
转录本定量结果里,稳定的数字很容易给人安全感。如果重复抽样一百次,两个异构体的比例始终是一比一,看起来似乎已经获得非常可靠的证据。但另一种可能是,输入根本没有能够区分这两个异构体的片段,算法在对称条件下持续给出了同一种分配。
本文实际安装 kallisto 0.52.0,构造两个共享大部分序列的异构体和一个独立对照,分别运行具有区分信息与只覆盖共享区域的两组文库,每组完成一百次 bootstrap。实验得到的关键结果是,只覆盖共享区域时,异构体比例的抽样标准差为零,但这并不证明真实来源比例已经被确定。
一、先明确伪比对能够提供什么信息
kallisto 利用参考转录本集合识别与读段相容的目标,并据此估计丰度。一个片段可能只与一个目标相容,也可能同时与多个目标相容。后者并不必然是坏数据,但它对不同目标的分配需要结合其他信息和模型处理。方法论文
因此,成功伪比对与能够唯一地区分转录本不是同一个概念。一个文库可以有很高的伪比对比例,却仍然包含大量只支持某个目标集合、不能区分集合成员的片段。若研究重点是异构体变化,这个区别尤其关键。
这个工具的优势是能较快生成定量结果,并提供重复抽样输出,让读者进一步检查估计的波动。它的局限也很明确,参考缺失、相似转录本之间的信息不足,以及真实数据偏离模型条件,不会因为计算结束而自动消失。
二、两个异构体怎样设计,才能看清共享信息
本次 isoA 与 isoB 都长两千碱基,前一千七百碱基完全相同,最后三百碱基各自独立生成。第三个目标 controlC 同样长两千碱基,但序列独立。全部序列由固定随机种子生成,避免将特定真实基因的生物学背景混入这个机制演示。
第一组一千对片段中,四百对完全位于共享区域,一百八十对位于 A 的特有尾部,二十对位于 B 的特有尾部,另有四百对来自 C。第二组同样一千对,但前两个异构体的相关片段全部来自共享区域,共六百对,C 仍为四百对。
| 来源类别 | 有区分信息 | 仅共享区域 |
|---|---|---|
| A、B 共享区域 | 400 对 | 600 对 |
| A 特有区域 | 180 对 | 0 对 |
| B 特有区域 | 20 对 | 0 对 |
| 独立对照 C | 400 对 | 400 对 |
每对读段的两端各一百碱基,完整片段长度随机取二百二十至二百八十碱基。我们先生成完整片段,再取两端并保持配对关系。没有测序错误,也没有让共享片段跨入异构体特有区域,因此能够明确知道哪些片段具有区分信息。
这里刻意按区域选择片段,不是均匀模拟整个真实转录本的覆盖。这个设计适合解释信息结构,不能用来证明估计值准确恢复了真实生物学表达量。尤其不能把共享片段的来源人为指定给某个异构体,再将软件没有恢复这种无法从序列识别的标签说成算法错误。
三、实际安装与运行,保留可复核的环境
本次使用固定摘要的 kallisto 0.52.0 镜像,实际建立索引,再分别执行两组定量。索引版本为十三,实际 k 值为三十一。程序版本和索引版本一起保留,避免以后仅复制一个索引文件,却不知道它与当前程序是否兼容。
kallisto index -i transcripts.idx -t 2 transcripts.fa

kallisto quant -i transcripts.idx \
  -o informative -b 100 --seed 143 \
  --plaintext --fr-stranded -t 2 \
  informative_1.fq informative_2.fq
两组使用相同索引、相同抽样次数和固定随机种子。读段方向由我们主动设计,因此选择与其一致的链特异性设置。双端模式下没有人为指定单端片段长度参数,程序根据配对信息处理片段分布。命令使用说明
固定种子有利于复核这次实验,但不代表所有硬件、线程安排和未来版本都会逐个数字完全一致。复核时应同时检查主要结构性结果,例如片段数量、相容关系、目标列表和两个条件的差别,而不是只盯住某个小数的最后一位。
不同版本的选项也需要重新核对。在线手册部分示例仍写着较早版本,而当前发布记录描述了一些功能的变化。本次只使用实际安装包支持并已经执行过的选项,没有将其他版本的全部功能都算入实测范围。发布记录
四、伪比对都是百分之百,但信息量并不相同
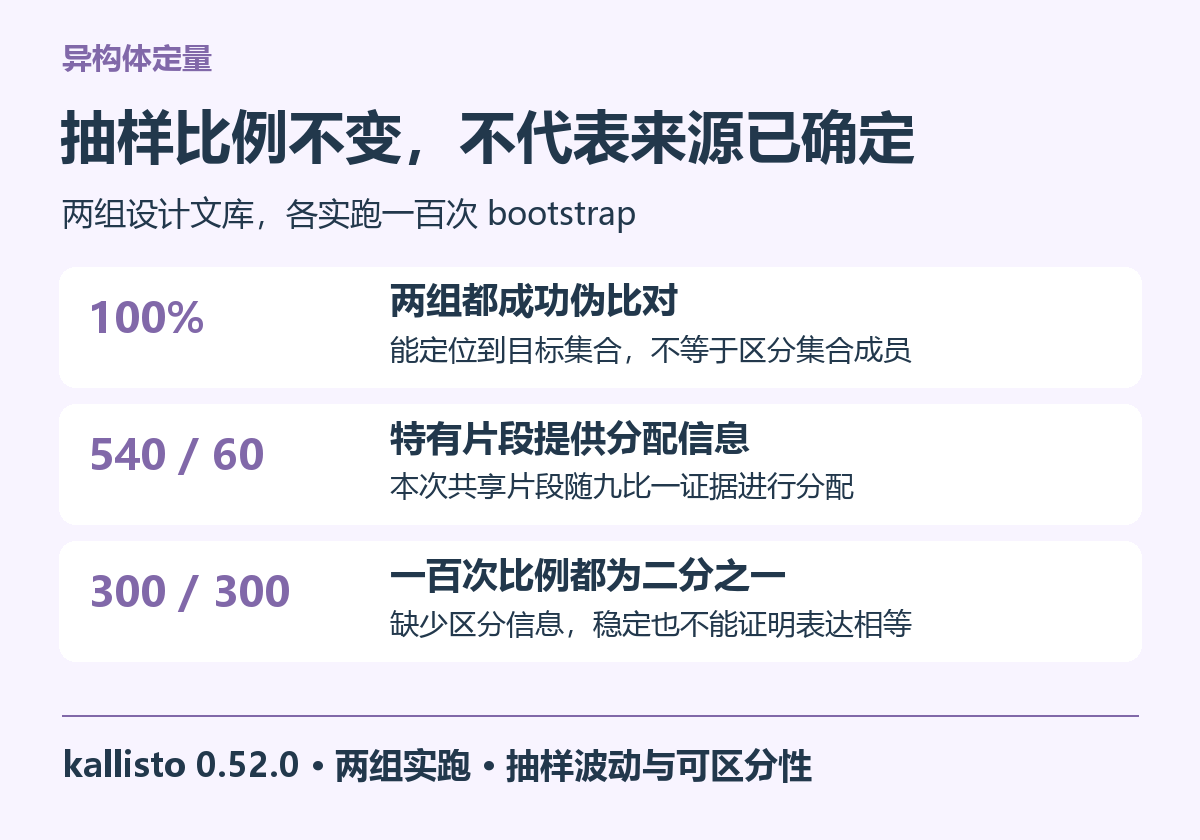
两组都处理了一千对片段,成功伪比对也都是一千,比例均为百分之百。有区分信息组的唯一相容片段为六百,其中包括 A 特有的一百八十、B 特有的二十和独立对照的四百。仅共享区域组的唯一相容片段只有四百,全部来自 C。
如果只把伪比对比例贴在报告里,这两组会显得一样好。把唯一相容数量一起看,才会发现第二组在 A、B 之间完全缺少区分性观测。因此,质量指标应与研究问题对应,目标是异构体时不能只报告一个总体成功比例。
点估计也揭示了这种区别。有区分信息组给出 A 为五百四十、B 为六十、C 为四百。A 与 B 的特有片段比例为九比一,在本次对称长度的简化条件下,共享片段也按同样比例被分配,四百对共享片段对应约三百六十与四十。
| 条件 | A 估计片段 | B 估计片段 | C 估计片段 |
|---|---|---|---|
| 有区分信息 | 540 | 60 | 400 |
| 仅共享区域 | 300 | 300 | 400 |
第二组 A、B 各三百,符合当前对称设置下的分配结果。但原始序列没有告诉我们六百对共享片段分别来自多少 A 和 B。这个相等的点估计不能被改写成“已经证实两者表达完全相同”。
五、一百次 bootstrap 实际告诉了我们什么
每组都成功产生一百份重复抽样丰度表。我们按目标标识汇总每次估计,而不是假定所有文件中的行顺序都一致。除了分别计算 A、B 的估计片段波动,还计算每次 A 占 A 加 B 总量的比例,以观察家族内部的分配。
有区分信息组中,这个比例的平均值约为 0.89942,标准差约为 0.02090。一百次抽样的最小值约为 0.83721,最大值约为 0.94975。这个范围只是本次有限次抽样的观察范围,没有被解释成某个指定置信水平的区间。
仅共享区域组中,一百次比例全部等于 0.5,标准差为零。但 A 和 B 各自的估计片段数仍有波动,标准差都约为 6.56117。原因是抽样改变了共享家族与 C 的相对片段数,而 A、B 在每次结果中仍然保持相同分配。
| 抽样指标 | 有区分信息 | 仅共享区域 |
|---|---|---|
| A 在家族中的平均比例 | 0.89942 | 0.50000 |
| 上述比例的标准差 | 0.02090 | 0 |
| A 估计片段数标准差 | 18.50093 | 6.56117 |
| B 估计片段数标准差 | 12.41387 | 6.56117 |
因此,不能把比例没有波动误读为所有数量都没有波动,也不能把某个抽样统计量为零解释为真实生物学参数已被完全确定。应先问这个统计量在当前输入和算法条件下能够反映哪种不确定性。
六、抽样波动与可区分性,是两类不同的问题
bootstrap 在已有观测信息的基础上重新抽样。若输入中没有任何能够区分 A 与 B 的片段,重复抽样不会凭空创造出这样的序列。所有抽样仍然面对同一类信息缺口,这正是本次比例始终相同的背景。
可区分性关注的是,不同的真实来源组合是否可能产生同样的观测。在仅共享区域的设计中,给 A 多分一些、给 B 少分一些,仍可能得到完全相同的共享片段序列。仅凭这些序列,无法判断应选择哪一种来源组合。
这与已经拥有区分信息、但由于样本量有限而出现的抽样波动不同。有区分信息组至少观察到两类特有片段,重复抽样会改变它们的相对数量,进而改变共享片段的分配比例。第二组缺的是信息类型,并不只是少做了几次重复抽样。
把 bootstrap 从一百增加到更多次数,可以更细致地描述当前抽样机制下的波动,却不能解决没有区分性片段的问题。真正需要改变的可能是实验读段设计、可覆盖的区域、参考注释或后续验证方式,而不是只增加计算次数。
七、怎样检查自己的重点异构体
实际数据中,可以先检查重点异构体是否具有能够被当前读长和片段长度覆盖的特有区域。如果差异只存在于很短的一段,或者测序方案很少覆盖那个位置,即使总体测序量很大,也可能缺少有效的区分信息。
接着查看结果是否大量依赖共享片段。对于几个高度相似的目标,除了各自的点估计,还可以检查相关目标的联合数量和估计之间的关系。如果总量比较稳定,而内部比例高度依赖少量证据,报告时应把这两层结论分开说明。
本次相反地展示了另一种情况,内部比例很稳定却仍缺乏区分信息。因此,无论波动大还是小,都需要回到输入结构。小波动不是万能的通过标准,大波动也不必然意味着全部数据无用,它们可能分别提示不同的问题。
如果要进一步做生物学比较,应保留独立样本与实验设计。一个样本内部的一百次 bootstrap 不能代替一百个生物学重复,也不能据此估计样本之间的真实差异。重复抽样输出与生物学重复应在文件命名和统计分析中明确区分。
八、怎样复核输出,避免统计脚本制造新错误
本次使用纯文本输出,普通丰度表保存点估计,另外一百张表保存重复抽样结果。脚本排除普通丰度表,确认重复抽样文件数量恰好是一百,再按 target_id 读取估计片段数。若把点估计也混进去,会得到一百零一次并不相同来源的观测。
import csv
from pathlib import Path
from statistics import stdev

ratios = []
for path in sorted(Path("shared_only").glob("*.tsv")):
    if path.name == "abundance.tsv":
        continue
    with path.open() as handle:
        rows = {r["target_id"]: float(r["est_counts"])
                for r in csv.DictReader(handle, delimiter="\t")}
    if rows:
        ratios.append(rows["isoA"] / (rows["isoA"] + rows["isoB"]))

assert len(ratios) == 100
print(min(ratios), max(ratios), stdev(ratios))
这段针对本次输出布局使用。如果目录中混有其他表,应进一步限定文件名和检查表头,不能让无关文件自动进入统计。分母为零的目标组合也需要单独处理,不能悄悄填成零比例后继续计算平均值。
记录估计片段数时不要只保存格式化后的图片。原始丰度表、运行信息、索引来源、片段类型和抽样参数共同决定结果的含义。将这些材料保留完整,后续才能回答某个结论来自真实数据支持,还是来自参考和模型的限制。
九、工具的优缺点应落到研究问题上
kallisto 适合在已有参考转录本的前提下开展定量,并通过抽样结果帮助审阅估计波动。它也适合用于这种小型机制实验,因为我们可以明确控制输入信息,再查看输出如何响应。本文没有进行工具间速度排名,也没有用人工数据给出真实样本准确率。
对于异构体问题,最重要的经验是同时检查点估计、抽样波动和区分性证据。三者回答不同问题,任何一个都不应独自承担全部结论。一个完全稳定的数值,仍可能只是当前对称条件下反复出现的分配结果。
下载本组复现材料可以取得三条设计参考的生成脚本、两组片段构成、一百次抽样结果与全部统计过程,读者可以重新计算文中的比例和标准差。
当转录本定量需要覆盖多批样本,并统一保存参考、重复抽样结果和分析记录时,可以了解云生信生物信息分析环境服务。


