
拿到两份扩增子分析结果时,如果都写着“按百分之三距离划分 OTU”,很多人会以为它们使用了相同规则。但距离阈值只说明比较尺度,序列如何组成一个簇,还取决于聚类方法。某些方法允许通过中间成员把距离较远的序列连接起来,另外一些方法则要求所有成员之间都足够接近。
本文安装并实际运行 mothur 1.48.6,用四条关系已知的序列计算距离,再比较最近邻、最远邻和平均邻居三种方法。我们还扩大计算范围重新运行,读取指定距离下的丰度表,检查输出标签与实际分组是否一致。读完可以自己复核一份聚类结果,而不只是记住几个参数名称。
先把序列、距离和聚类结果分开
序列文件保存碱基,距离矩阵保存序列之间的差异,聚类结果保存哪些序列被归入同一个单位。这三层对象相互关联,但不能互相替代。只知道两个序列被分到一起,无法直接推断它们具有完全相同的序列,也无法直接推断它们属于同一个物种。
我们构造四条长度均为一千碱基、没有缺口的已对齐序列。基础序列命名为 A,在其中二十个位置修改碱基得到 B,再在另外二十五个位置修改 B 得到 C。最后从 A 出发,在不重叠的八十个位置修改碱基得到 D。
这样的设计让距离关系能够独立复算。A 与 B 相差二十个位置,B 与 C 相差二十五个位置,而 A 与 C 的差异累积为四十五个位置。前三条序列形成一条由近到远的连接链,D 则作为较远的对照。
这些是为了检验算法而设计的序列,没有真实分类名称、样本分组或生态学背景。它们适合解释参数怎样改变分组,不适合据此评价某种方法在真实微生物群落中的总体准确率。
安装后先核对实际运行的版本
本次下载官方发布页提供的 Ubuntu 22 x86_64 无 Readline 依赖版本,解压后在独立目录运行。版本命令实际返回 1.48.6,下载包还记录了可执行文件的校验值,便于区分同名程序或不同构建。mothur 1.48.6 官方发布页
unzip Mothur.Ubuntu_22.x86_64.noReadline.zip -d mothur1486
chmod +x mothur1486/mothur/mothur
mothur1486/mothur/mothur --version
复现包中的 Python 驱动负责生成序列、调用程序和读取输出。它不替代 mothur 的距离计算或聚类算法。输入构造中的随机种子固定,具体修改位置也固定,因此可以从头重新生成相同输入。
安装环节容易出现的混淆是终端中调用了另一个目录里的程序。复现时可以直接传入可执行文件的完整路径,再把版本输出与文件校验值放到结果记录中。这样检查参数差异时,才不容易把版本变化误认为方法变化。
实际计算的距离与手算是否相同
本次先运行距离计算,输出下三角矩阵,保留六组两两比较结果。
mothur "#dist.seqs(fasta=aligned.fasta,output=lt,processors=2,cutoff=0.2)"
cp aligned.phylip.dist input.phylip.dist
对于本例的等长、无缺口序列,逐位比较得到的差异比例与程序输出一致。六组距离分别为 A 与 B 的 0.020、A 与 C 的 0.045、A 与 D 的 0.080、B 与 C 的 0.025、B 与 D 的 0.100,以及 C 与 D 的 0.125。
这里有一个值得记住的参数细节。官方说明中,下三角或方阵输出会忽略距离计算命令的截断选项。因此,本次使用下三角格式时获得完整距离矩阵,不能声称靠同一条命令中的截断值减少了矩阵内容。dist.seqs 参数说明
实际扩增子数据常包含对齐缺口、端部长度差异以及需要过滤的位置。此时距离的定义还受到缺口处理与有效比较范围影响,不能照搬本例“差异位置数除以一千”的简化算法。先确认输入已经覆盖可比较区域,再解释距离阈值,通常比直接调整聚类命令更有价值。
最近邻为什么把 A、B、C 放到一起
我们首先指定最近邻方法,观察百分之三距离附近的分组。
mothur "#cluster(phylip=input.phylip.dist,method=nearest,cutoff=0.03)"
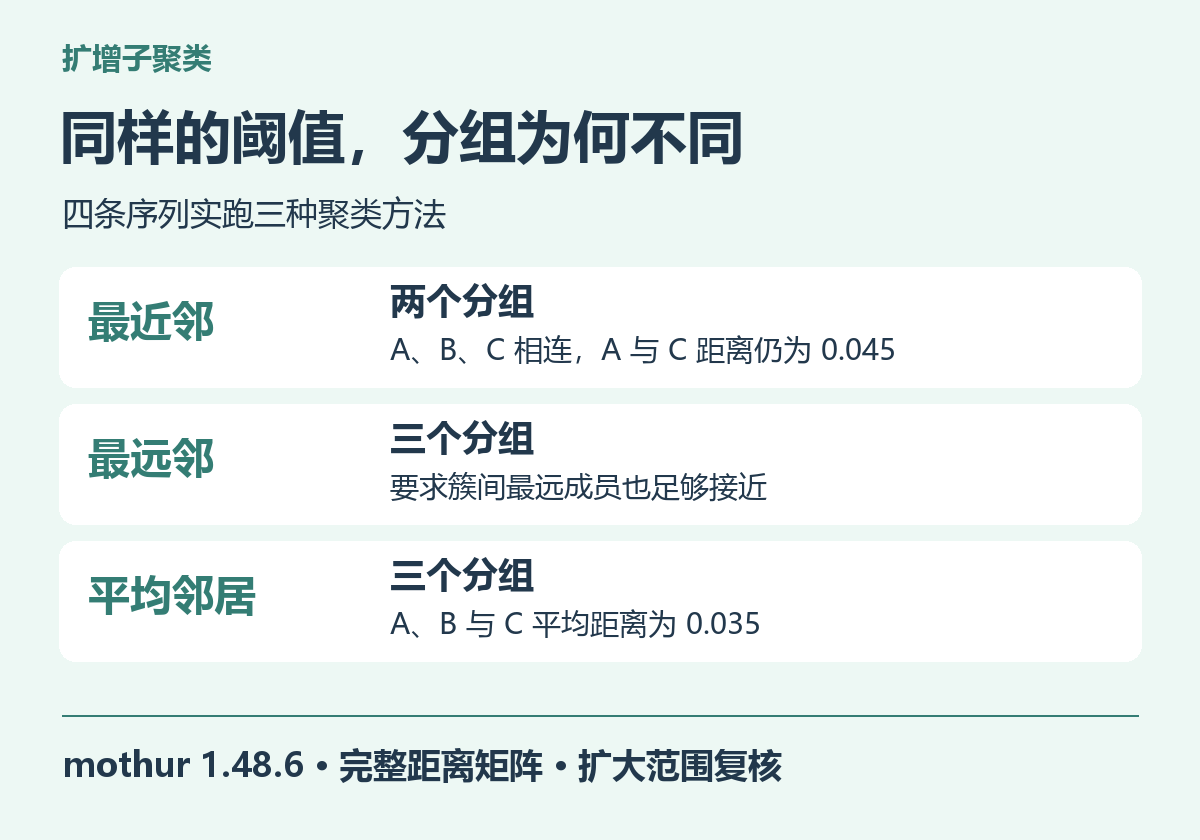
实际结果中,A 与 B 先合并。随后 B 与 C 的距离为百分之二点五,足够近,C 也加入同一个簇。最终形成包含 A、B、C 的一个簇,以及只包含 D 的另一个簇。
但 A 与 C 的距离为百分之四点五,已经高于百分之三。二者仍然同簇,是因为最近邻允许通过其他成员建立连接。本次结果恰好提供了一个能够直接检查的例子,避免把“同簇”错误解释为“任意两条都低于阈值”。
这种连接规则容易理解,也能把沿着局部相似关系相连的序列聚到一起。使用时需要注意链式扩展的影响。如果研究问题要求每对成员都满足相近程度,就应明确检查所用方法是否保证这一点,而不是仅凭阈值名称判断。
最远邻和平均邻居为什么仍然保留三个簇
最远邻比较簇之间最远的成员。A 与 B 合并后,若把 C 加进来,就必须面对 A 与 C 的百分之四点五距离。因此,在本次观察的百分之三水平,C 保持单独,最终分组为 A、B 一个簇,C 一个簇,D 一个簇。
平均邻居在本例中也留下三个簇,但原因需要单独计算。A、B 组成的簇与 C 的平均距离,是百分之四点五和百分之二点五的平均值,也就是百分之三点五,仍然高于目标水平。
mothur "#cluster(phylip=input.phylip.dist,method=furthest,cutoff=0.03)"
mothur "#cluster(phylip=input.phylip.dist,method=average,cutoff=0.03)"
最远邻的分组条件较容易用于检查簇内最大差异,但也可能让一些通过局部相似性相连的序列保持分离。平均邻居综合多个成员间的距离,结果受簇组成影响。本文的计算说明了三种规则为何不同,没有给出一种能够适用于所有扩增子任务的优胜方法。
另外,当前官方文档列出的默认方法为 OptiClust。本次为了展示距离连接规则,明确指定了上述三种方法,读者不能把这里的结果当作省略方法参数时的默认输出。cluster 方法与默认参数
为什么还要把计算范围扩大后再跑一次
初次对照将聚类命令的截断值设为 0.03,能直接看到本例的区别。但正式流程中,应区分计算时保留的距离范围与最后准备读取的分组水平。对于这里的三种邻居方法,官方建议计算范围高于最终关注的距离。
为检查初次结果是否受到范围设置影响,我们又把三种方法全部改为 0.2 运行。完整矩阵保持相同,输入序列和方法名称也保持相同,只扩大计算范围,再从输出中读取目标距离附近的状态。
复现驱动为每个方法和计算范围建立独立目录,并把同一份矩阵复制为下面命令使用的文件名,避免不同对照覆盖输出。扩大范围的平均邻居命令如下,另外两种方法只替换方法名称。
mothur "#cluster(phylip=input.phylip.dist,method=average,cutoff=0.2)"
扩大范围后,最近邻依旧在标签 0.03 对应两个簇。平均邻居在标签 0.02 时是三个簇,到标签 0.04 才合并成两个。最远邻同样先保持三个簇,到标签 0.05 才变为两个。这些变化与前面独立计算的距离关系相符。
本次输出保留了默认精度下的标签,所以百分之三点五和百分之四点五对应的变化,分别显示在 0.04 和 0.05 行。应保留原始距离和输出标签两份证据,不要把打印标签的位数当作原始距离的全部精度。
指定读取 0.03,文件里为什么出现 0.02
进一步读取结果时,我们为四条序列建立同一个演示样本的归属文件,再运行丰度表生成命令。这样可以同时检查分组数量和每个分组中包含的序列数量。
printf 'A\tdemo\nB\tdemo\nC\tdemo\nD\tdemo\n' > input.groups
mothur "#make.shared(list=input.phylip.an.list,group=input.groups,label=0.03)"
平均邻居的列表中没有单独的 0.03 行,因为在该位置之前,分组仍然保持 A、B 合并而 C、D 独立的状态。实际生成的丰度表使用了 0.02 标签,三个分组的计数分别为二、一、一。
最远邻同样返回 0.02 标签与三个分组。最近邻则返回 0.03 标签,两个分组的计数为三和一。这些都是程序实际写出的结果,没有为了让表格整齐而将标签手动改成相同数字。make.shared 输入与标签选择
| 方法 | 请求标签 | 输出标签 | 分组数 | 成员关系 |
|---|---|---|---|---|
| 最近邻 | 0.03 | 0.03 | 2 | A、B、C 同组,D 独立 |
| 最远邻 | 0.03 | 0.02 | 3 | A、B 同组,C 与 D 各自独立 |
| 平均邻居 | 0.03 | 0.02 | 3 | A、B 同组,C 与 D 各自独立 |
排查自己的输出时,先查看列表中实际有哪些标签,再核对读取命令和日志。某一行没有出现,并不自动代表程序漏算或运行失败。本次通过扩大范围和实际生成丰度表,确认了目标水平对应的分组状态。
怎样比较两份真实项目结果
拿到结果后,第一步可以检查代表序列是否相同。如果输入本身经过不同的质量过滤、去嵌合体或去冗余处理,即使后续方法与阈值相同,也可能得到不同数量。此时只比较最终 OTU 数,难以找到差异来自哪里。
第二步核对距离矩阵的定义。确认对齐范围、缺口处理和使用的序列集合,尤其注意是否将不同标记区域或长度差异很大的片段直接放到一起。距离定义不同,后面的阈值就不具有完全相同的含义。
第三步检查聚类方法和计算范围。本次三种方法已经说明,同一个目标距离无法唯一确定分组。对照实验应先固定输入和距离矩阵,逐项改变方法,再检查哪些成员发生移动,才容易理解变化机制。
第四步核对丰度映射。真实去冗余后的代表序列可能承载许多读段,需要保留名称映射或计数表。若把每条代表序列都当成一次观测,可能保持相同分组结构,却改变每个样本的丰度。本次每条设计序列恰好代表一次观测,因此表中的三和一仅表示成员数量。
第五步检查记录是否足够复现。至少保存软件版本、序列输入、距离矩阵、完整命令、列表文件和所选丰度表。需要复核某个簇时,能够从成员名称回到原始序列,比只留下一个多样性图更有帮助。
比较分组时,还应以成员集合为准。不同运行中的分组编号未必指向同一组序列,不能只因为都叫第一号就认定它们一致。本次检查时将每组成员排序,再比较集合,因此能够确认差异具体发生在 C 是否加入 A、B 所在的组。
还可以做两项简单核对。一是把所有分组中的成员数量相加,本例应始终得到四。二是检查同一条输入序列是否重复出现在多个分组。如果总数变化或成员重复,先排查文件解析、输入筛选和映射过程,再解释所谓的生物学差异。正式项目使用计数表时,还需要另外核对各样本丰度之和,不能把成员守恒和读段丰度守恒当作同一个检查。
这次实跑能得到哪些判断
mothur 的价值之一是提供从序列整理到距离、聚类和群落表的连续操作,并把不少中间关系保存为可以检查的文本文件。对于需要复查传统 OTU 流程的读者,这种明确的输入输出有助于定位差异。
需要投入的学习成本也很具体。相近的参数名可能作用于不同步骤,列表标签和目标阈值不一定逐行对应,代表序列与原始读段的计数也需要额外映射。解决这些问题依靠理解文件之间的关系,不能只复制一段最终聚类命令。
本次没有进行物种注释、测序错误校正或真实群落比较。因此,两个簇和三个簇都只是各自规则下的结果,不能把数量较少的一组自动称为更准确,也不能把一个固定相似度阈值直接等同于物种边界。
复现包提供四条序列的构造脚本、六组实际距离、两种计算范围下的完整聚类列表,以及请求 0.03 时实际生成的丰度表和日志,便于读者逐项复算。下载实跑脚本与本次结果
当项目需要对多个扩增子批次统一流程、保存中间结果并复核聚类差异时,可了解云生信的生物信息学分析计算服务。


