
两张相邻切片并排摆在屏幕上,左图有一小块组织伸出,右图在相应位置恰好裁掉了一角。运行对齐程序后,左图这块组织仍向右图发出几条连线。它是否在另一张片上还有对应的细胞群?要回答这个问题,先看输出矩阵在数学上必须满足的条件。原始 PASTE 的两片对齐输出描述两张切片的点位质量怎样分配。若每个点都必须把分配额度用完,即使另一片缺了一角,也依然能得到某种分配。这会直接影响如何阅读彩色连线、最大匹配和叠合图。PASTE 原始方法
给传输矩阵写上行名、列名和分母
设矩阵的行是来源切片上的捕获点,列是目标切片上的捕获点。软件结合两种信息估计矩阵,一种是跨片表达特征差异,另一种是各片内部的点间几何关系。使用同片相对距离有一个具体好处,一张片即使整体旋转和平移,内部任意两点间的距离仍然保持不变。若一张片的坐标单位是像素,另一张是微米,或者经历了不均匀的形变,几何关系就未必能直接比较。实际对齐时应保留坐标单位和原始照片,并先确认两张片取的是同一解剖层面的足够重叠区域。
在默认均匀边际的例子里,若来源有六个点,每行应加到六分之一。目标若有五个点,每列应加到五分之一。值为零点一六七的格子可能已经耗尽了这一行的全部额度,不能看到它小于一点零就解释为只有不足两成把握。若要描述某个源点流向各目标点的相对占比,先将该行除以它的和。这个占比受给定表达、几何和边际约束共同影响,不能直接当作生物同源概率。对照两个分母,是读这种表格最省时间的一步。作者包的配对接口和边际参数
| 设置 | 最大匹配能说明什么 | 如何检查 |
|---|---|---|
| 两片有密实且单一的对应 | 在当前约束下质量集中 | 比较行内第一、第二候选及独立地标 |
| 源片有一块在目标片缺失 | 这一行仍需分配额度 | 看整行和实际重叠掩膜 |
| 两个目标点并列或近似并列 | 单个最大编号受列顺序或微小误差影响 | 保存所有近似并列的点和对应份额 |
实跑经验|删除一个真实对应点,矩阵把这一行放到了哪里
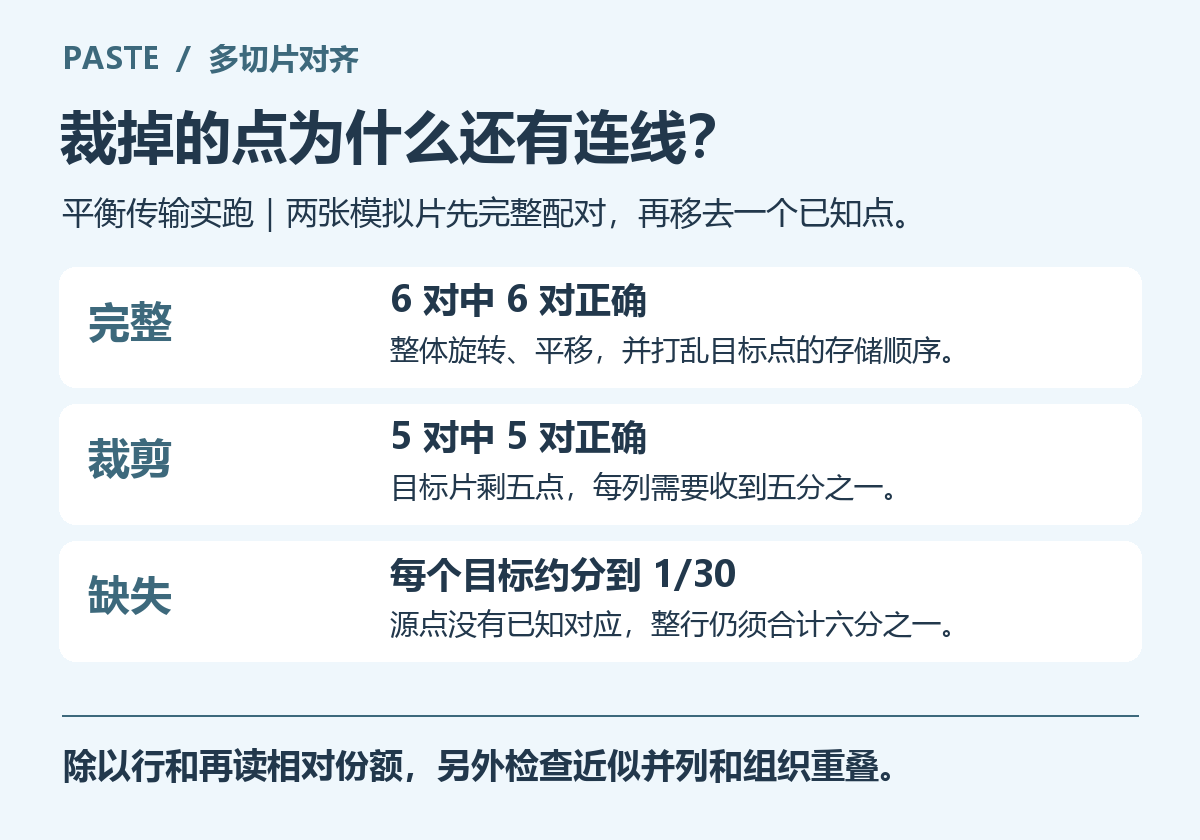
我们安装 paste-bio 1.4.0,用六个非完全对称排列的点和十二个基因构造模拟切片。每个点拥有一对相对突出的表达特征。复制切片时,保持表达向量不变,将坐标旋转九十度并平移,再故意打乱目标点的存储顺序。两片的所有点名在试验记录中都有已知对应,因而既能考察旋转平移,也能检验脚本有没有偷用相同行号。使用均匀边际、欧氏表达差异,空间项权重设为零点一,并启用空间距离归一化。完整情况下,六个源点的最大质量都对应到正确目标,每行只有一个约六分之一的非零项。
第二次仅从目标片删除源编号五的副本,其他五对仍然一一对应。重新运行后,这五对的最大匹配全部正确,但源编号五的那一行向五个目标各分配约零点零三三三三,总和仍为六分之一。换算成这一行内部的比例,每个目标约占五分之一。若脚本只导出一列最大位置,它依然会给出某个具体编号,却会隐藏这个源点对五个位置几乎等量分配的事实。这个例子可以手算核对。每个目标须收到五分之一,已有的同源点贡献六分之一,余下的三十分之一正好由缺少对应的源点补齐。
import numpy as np

# pi 来自一次 pairwise_align,行、列次序分别来自当时的两个输入对象
row_sum = pi.sum(axis=1, keepdims=True)
share = np.divide(pi, row_sum, out=np.zeros_like(pi), where=row_sum > 0)
ranked = np.sort(share, axis=1)
print(pi.sum(axis=0), row_sum.ravel())
print(ranked[:, -1], ranked[:, -1] - ranked[:, -2])
版本也是复现的一部分。我们的首次尝试配套较新的 POT 0.9.7.post1,优化器给线搜索回调传递的参数数量与这个 PASTE 版本不一致,计算中途抛出异常。固定 POT 0.9.4 后,同样输入完成了上述两次对齐。判断是否成功应同时检查返回矩阵、行列边际和已知阳性对应。仅能导入包,或者只获得一张坐标叠合图,无法验证读取的矩阵究竟对应哪两个输入对象。
另一个能从这组数据直接演练的检查是调换观察方向。将目标片作为行读取时,先转置矩阵并使用新的行和归一化。裁剪后的目标片有五枚点,每枚点收到的五分之一里,同源点贡献六分之一,缺失点贡献三十分之一,因而反向条件份额分别为六分之五和六分之一。正向看缺失点是对五处各给五分之一,反向看任意目标都有一个主要来源,两个结论并无矛盾。给叠合图加箭头或做标签转移时,注明从哪张切片向哪张转移,以及先按行还是按列归一化,能排除这种方向误解。
用留出的区域验证对齐,而不是只检查最亮的一条线
对真实切片,建议先用同一组织内明显可辨认的两三个结构作地标,再单独圈出疑似缺损、折叠或边缘裁剪的区域。将前一组地标用作可核查的正对照,后一组则专看是否被分配到多个不相邻候选。若几何与表达都将一个点映往解剖上合理的邻近区域,而且独立标记也支持这种关系,写成局部对齐具有依据。若整行非常分散,或者几个几乎并列的候选落在不同组织层,就应保留这种不确定性。改变目标表的行顺序再运行一次,也是捕捉编号误用和并列最大值的简单测试。
当两张片只有部分重叠,可以先讨论明确的共同组织区域,必要时比较能显式处理部分重叠的方法。PASTE2 是作者另行提出的部分对齐方法,适用问题与这里实跑的原始平衡传输不同。即便采用了部分对齐,还要核查选取的重叠比例与病理轮廓是否相容。能拒绝某些分配只改变了模型允许什么,独立地标、区域级误差记录以及输入条形码追踪仍是判断结果好坏的依据。部分对齐的原始研究
将上述核查扩展到连续切片时,保留每对输入的顺序、原始坐标、传输矩阵和逐行份额,便于追查某一步发生的漂移。需要批量对齐并保留这些中间结果的团队,可了解云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)