
两个测序文件合并后,重复率突然升高,常见的排查动作是回头看建库量和扩增轮数。还有一个几乎不花时间的检查,打开 BAM 头,核对两个读组写的是同一份文库,还是两份独立文库。我们用 Picard 对同样的三对读段做了两次标记,样本名、读组名、坐标、方向和碱基质量都没改,只改第二个读组的文库标识。第一次有一对被标重复,第二次一对也没有。理解这个差异,有助于判断合并泳道、合并文库以及计算有效深度时该保留哪些信息。
从实验记录追到 BAM 文件头的三个字段
样本标识回答这些数据属于谁。文库标识回答它们由哪一次建库得到。读组标识则让每条比对记录能指回文件头的一条读组声明。一个样本可以独立建两份文库,一份文库也可以分到不同泳道测序。合并文件后,只保留相同样本名无法恢复这些实验关系。应从实验记录整理样本、建库批次、泳道的对应,再检查每条记录上的读组标记能否在文件头找到,头里的文库字段有没有正确填写。SAM 规范中的读组与文库字段
Picard 的位置法会结合文库信息与读段的方向、未剪切的五端位置等特征寻找重复候选。数据是成对还是单端,也会影响它能利用的信息。默认评分策略会利用碱基质量在候选组里挑选代表。因此,同样坐标的两对读段有可能保留其中一对,再给另一对标上重复位。文库信息一旦划错组,工具比较的对象集合就发生变化。对于高度富集的小靶区或固定扩增引物,大量不同分子可能天然具有相近的端点,解释位置重复时要结合实验设计。Picard MarkDuplicates 官方参数说明
实跑经验|两个读组是否属于同一份文库
安装 Picard 3.1.1,构造一个样本、两个读组、三对读段。第一对与第二对都从一百零一和一百八十一这两个位置开始,比对方向一致,两端各长三十个碱基。第一对所有碱基的质量值为四十,第二对为二十。第三对的质量较低,但位置换到四百二十一和五百零一,作为额外对照。我们按坐标排序输入,使用严格格式检查和默认的标记策略。人工名字不含测序仪图块或像素坐标,因此本次关闭光学重复识别,只考察位置和文库。
| 比较项目 | 两个读组同属文库 A | 第二个读组属于文库 B |
|---|---|---|
| 输入/输出的比对记录 | 6/6 | 6/6 |
| 文库层面的已检查读对 | A 为 3 对 | A 为 1 对,B 为 2 对 |
| 标记的重复读对 | A 为 1 对 | 两个文库均为 0 |
| 被标记的两条记录 | low,FLAG 1123 与 1171 | 无 |
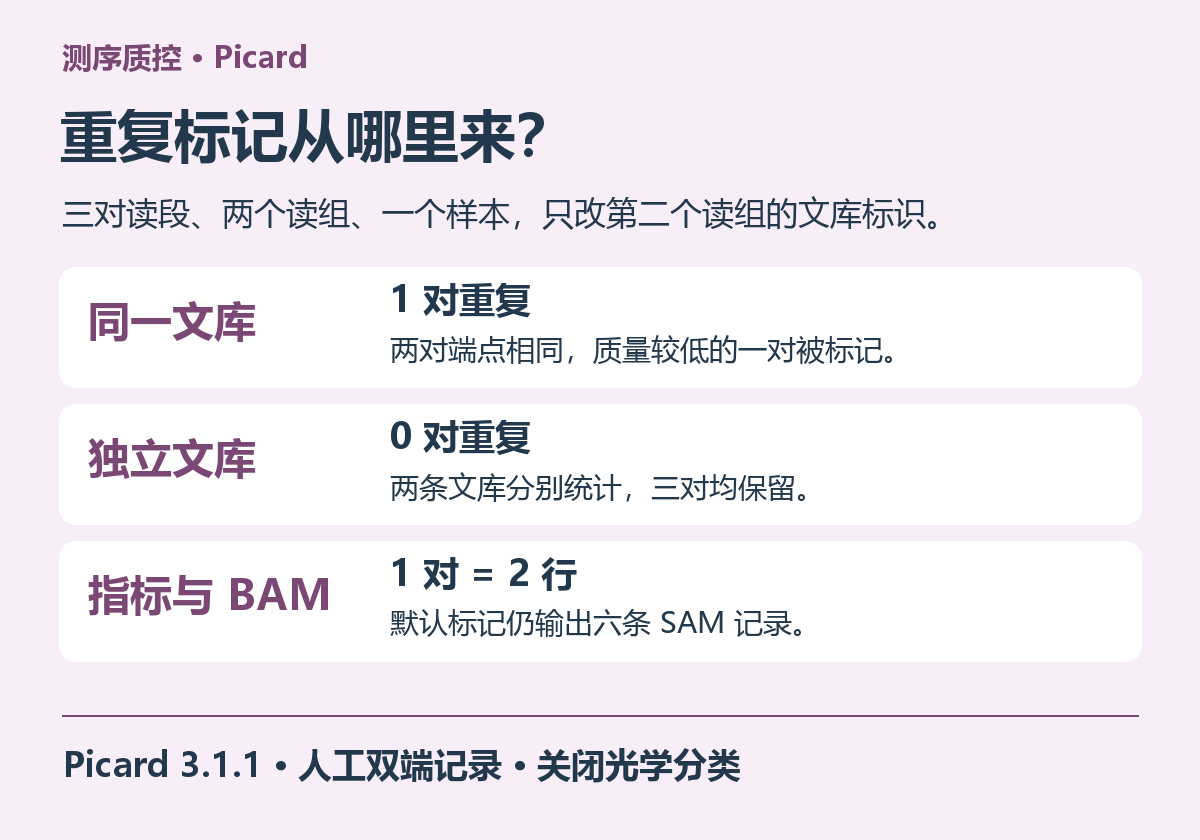
第一次运行的重复对数为一,指标表里的重复比例为零点三三三三三三。观察被标记的实际记录,两条都叫 low,对应那对质量较低、坐标相同的读段。它们原先的标志分别是九十九和一百四十七,加上数值为一千零二十四的重复位后,变成一千一百二十三和一千一百七十一。按重复标志筛选会得到两行,指标表则按读对记一,两者可以逐行对上。第三对尽管质量也较低,因为端点不同,两次都保留下来。
第二次仅改变第二个读组在文件头中的文库名称。第一次和第二次测量实际都输出六行,区别是第二次六行里没有任何一行带重复标志。检查指标表还会看到原来单独的一行拆成两行,分别检查一对和两对。跨文库汇总时应累加分母和分子,再计算实验要用的整体比例,特别是一个文库比另一个深很多时,直接平均两个文库的百分比会改变每对读段的权重。
samtools view -H shared.bam | awk '$1=="@RG"'
java -Xmx512m -jar picard.jar MarkDuplicates I=shared.bam O=marked.bam M=metrics.txt READ_NAME_REGEX=null
samtools view -f 0x400 marked.bam | cut -f1,2
samtools view -c -F 0x400 marked.bam
对本例做一项简便的反算,第一次六条输出记录中有两条带重复位,余下四条,正好对应两对。第二次排除重复位后仍有六条。正式数据常同时含有未配对、未比对、次要或补充记录,指标表给这些记录单设了字段,不能把任意两个命令得到的行数都直接除以二。
如何把这个对照用到真实项目
同一份建好的文库分到两条泳道时,给它们各自的读组标识,同时在文库字段保留一致的身份,才有机会跨泳道比较相同位置的候选。若来自两次独立建库,则应保留各自的真实文库身份。为改善报表数字随意修改头部,会让文件的技术来源与实验记录脱节。如果旧文件缺少文库信息,先回查实验记录、拆分样本清单和原始比对命令。确实无法还原时,应记录这一不确定性,再解释重复率变化有多少可能源于标识问题。
标记完成后要问,下游是在统计标记数量、忽略被标记读段,还是物理移除记录。默认标记提供了可复查的证据,下游是否应用该标志由具体工具与参数决定。最好挑一个代表区域分别数全部记录、重复记录和排除重复后的记录,理解覆盖曲线的差值。另一项常见误读是指标表里光学重复为零。本例明确关闭光学识别,那个零只能说明没有记录被归为光学类别。如果目标是分析光学重复,应先保证读段名称能解析出仪器和像素信息,并核对相应距离参数。
位置重复本身也无法区分所有技术和生物学情形。碰到带分子标签的建库,可以先确定标签在上游如何纠错、以哪个字段保留、后续按哪个策略分组。常规位置法输出的一行重复率,不足以替代这种分子层面的核查。把读组到文库的映射、去重前后计数和几个典型候选读对一起保存,下一次遇到重复率突跳就能先分辨实验信息变化与数据本身变化。
多批次样本需要按统一文库规则重新标记时,可使用云生信的生物信息分析服务器集中处理并保留各文库的指标表。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)