
两个样本使用同一份 ASV 计数表和同一份功能预测表,仅改变是否进行标记基因拷贝数校正,某个功能的高低顺序就可能反转。这个变化发生在功能丰度汇总阶段,不需要重新测序,也不代表软件突然发现了新的基因。
本文安装并运行 PICRUSt2 2.6.4,围绕三条 ASV、两个样本和两个设计功能完成六组参数对照,并从官方三十七条序列示例跑通完整的 EC 与通路预测。我们逐项复算校正后的权重、功能总量和每条 ASV 的贡献,同时检查 NSTI 门槛如何改变样本中被保留的部分。重点是读懂结果从哪些输入推导而来,避免把预测值写成直接测量。
功能预测需要哪些不同层次的输入
PICRUSt2 可以根据标记基因序列与参考基因组信息推测功能组成。典型流程需要处理序列放置、性状预测以及样本层面的功能汇总。这几个步骤产生的文件有不同含义,不能把其中一张表称为全部测序结果。
本文主对照直接使用设计好的标记基因拷贝数表和功能拷贝数表,调用已安装软件的功能汇总程序。这样每一个输入数字都有明确来源,可以独立验证计算过程。设计数字不是由这些 ASV 的真实基因组测得,也不是本次用系统树推断出来的生物学事实。
正式项目中,这两类预测表通常来自前面的性状预测步骤。把阶段分开解释,有助于定位问题。若功能总量出现意外变化,可以先检查汇总、校正和筛选,再决定是否需要回头检查序列放置。官方功能汇总流程
本次安装与复现方式
本次使用 BioContainers 提供的固定版本镜像,实际版本命令返回 2.6.4。复现包记录镜像摘要,并提供独立驱动,重新写出三份输入表后调用真实命令行程序。
docker pull quay.io/biocontainers/picrust2:2.6.4--pyhdfd78af_0
docker run --rm \
  quay.io/biocontainers/picrust2:2.6.4--pyhdfd78af_0 \
  metagenome_pipeline.py --version
这里固定的是本次使用的环境,并不要求所有项目都采用相同安装方式。已有可运行环境时,可以先核对版本和命令帮助,再运行下载包中的对照。正式从序列开始分析,还需要确保相应参考文件和外部依赖完整。官方安装与示例说明
三条 ASV 的计数怎样安排
两个样本各有一百个输入计数。样本一中 A、B、C 三条 ASV 的计数分别为八十、十、十,样本二分别为二十、六十、二十。
设计的标记基因拷贝数分别为一、二、五。第一个功能在 A、B、C 中的拷贝数分别为一、零、十,第二个功能分别为零、二、五。对应 NSTI 设为 0.05、0.2 和 1.5,用于观察不同门槛的作用。
这些值刻意让不同 ASV 在标记基因数量与功能数量上不一致。即使两条 ASV 的读段数相同,也不必在校正后承担相同权重,更不必对每个功能贡献相同数量。
输入表的序列标识必须能够对应起来。计数表、标记表和功能表若使用不同命名方式,可能只剩部分交集。实际操作中应先核对这些标识,而不是等到最终功能变少时才怀疑预测算法。
拷贝数校正先改变每条 ASV 的权重
默认汇总会利用预测的标记基因拷贝数调整输入计数。本例样本一从八十、十、十变成八十、五、二,样本二从二十、六十、二十变成二十、三十、四。
metagenome_pipeline.py \
  -i counts.tsv -m marker.tsv -f functions.tsv \
  --max_nsti 2 --strat_out -o normalized
例如 B 的标记基因拷贝数为二,因此两个样本中对应的计数都除以二。C 的拷贝数为五,其权重相应除以五。软件实际输出的校正表与这些计算一致。
校正后样本一的权重和为八十七,样本二为五十四。虽然两个样本最初都有一百个计数,校正后的总量并不要求相等。因此,不能继续把原始的一百当作所有后续比例的固定分母。
这些权重也不应直接写成样本中的绝对细胞数量。它们依赖标记基因拷贝数预测与分析假设,属于该计算流程中的校正量,仍需结合实验设计和其他证据解释。
功能总量可以怎样手算
功能汇总相当于把每条 ASV 的校正权重乘以相应功能的预测拷贝数,再在样本内相加。
对于第一个功能,样本一的结果是八十乘一,加五乘零,再加二乘十,得到一百。样本二则是二十乘一,加三十乘零,再加四乘十,得到六十。
对于第二个功能,样本一得到二十,样本二得到八十。程序输出的四个数字与手算一致,说明我们能够从输入表追踪到最终功能表。
| 汇总条件 | 功能 | 样本一 | 样本二 |
|---|---|---|---|
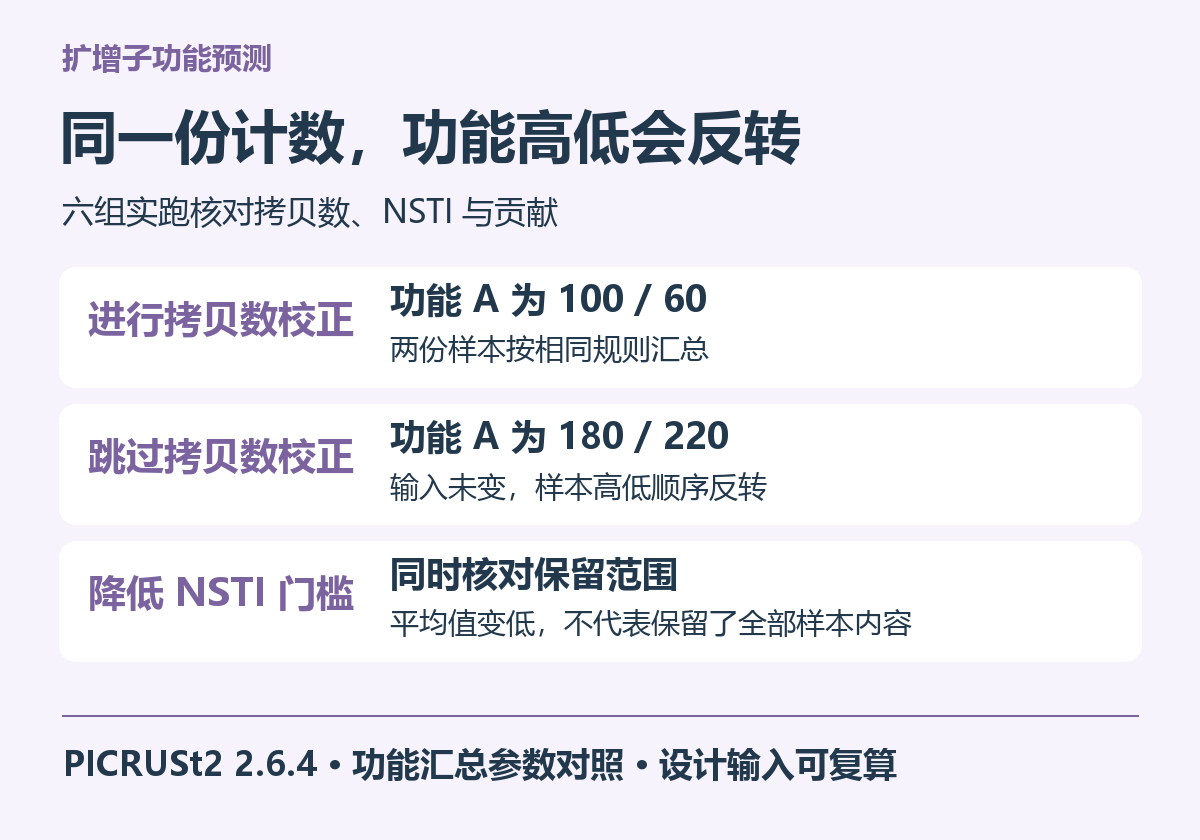
| 使用拷贝数校正 | 功能 A | 100 | 60 |
| 使用拷贝数校正 | 功能 B | 20 | 80 |
| 跳过拷贝数校正 | 功能 A | 180 | 220 |
| 跳过拷贝数校正 | 功能 B | 70 | 220 |
| 校正且 NSTI 不高于 0.5 | 功能 A | 80 | 20 |
| 校正且 NSTI 不高于 0.5 | 功能 B | 10 | 60 |
建议在真实结果中挑选少量功能,手动复算几个样本。这样可以较早发现表格方向弄反、功能列读错或计数单位改变等问题,比只查看最后的排序图更容易判断流程是否按预期执行。
跳过校正后,样本顺序真的发生了反转
第二组实际启用跳过校正选项,并按程序要求不再传入标记基因表。其他功能输入和样本计数保持不变。
metagenome_pipeline.py \
  -i counts.tsv -f functions.tsv \
  --skip_norm --max_nsti 2 \
  --strat_out -o skip_normalization
第一个功能的样本一结果变成一百八十,样本二变成二百二十。与默认校正后的第一组相比,高低顺序确实反转了。
原因可以直接追到 C。它在样本二有二十个原始计数,并被设计为具有十个该功能拷贝。跳过校正时,这部分贡献达到二百,而默认校正后只有四乘十,也就是四十。
这个对照说明,改变归一化方法可能改变后续比较方向。但本例只有两个设计样本,没有生物学重复,因此不进行显著性判断,也不把某一种输出顺序称为真实效应。正式项目应预先明确校正方法,并在解释时说明输入与假设。
NSTI 门槛改变的是哪些输入还能参与
本例进一步把最大 NSTI 设为 0.5。C 的设计 NSTI 为 1.5,因此被排除,A 与 B 继续参与。实际两个功能的结果分别变为样本一的八十和十,以及样本二的二十和六十。
这个变化同时影响样本保留范围。按原始输入计数核对,样本一保留九十,样本二保留八十。虽然都删除同一条 ASV,两个样本损失的比例并不相同。
如果进一步将门槛设为 0.1,就只留下 A。两个样本分别只保留原始计数的八成和两成,第一个功能输出八十与二十,第二个功能不再出现在最终功能表中。
因此,报告过滤结果时,除了统计删除了多少条 ASV,还应核对每个样本丢失了多少丰度。相同的特征数量变化,可能对不同样本产生很不一样的影响。
NSTI 与参考代表性有关,但不能被当作每个功能预测都必然准确的证明。参考覆盖、菌株间基因差异以及标记基因分辨能力仍会影响解释。官方局限说明
加权 NSTI 为什么也要核对权重
默认校正组实际输出的样本加权 NSTI 分别约为 0.09195 和 0.24074。以样本一为例,将八十乘 0.05、五乘 0.2、二乘 1.5 相加,得到八,再除以校正权重和八十七,就能复算该值。
这说明本次默认汇总中的加权使用了校正后的数量。如果直接拿原始计数计算,会得到另一组数值。跳过校正的实际运行中,两个样本的加权 NSTI 正好为 0.21 和 0.43。
门槛降为 0.1 后,两份样本的加权 NSTI 都变成 0.05,因为只剩下 A。数字看起来更低,但样本二只保留了原始计数的两成。评价结果时应把这个数与样本保留比例一起查看。
仅选择一个看起来更好的平均指标,容易忽略被筛掉的数据。更完整的记录应包含每条 ASV 的 NSTI、校正方法、门槛和样本保留量,让读者能够判断最终预测覆盖了输入中的哪一部分。
贡献表可以解释谁在驱动某个功能
开启分层输出后,程序会把样本功能量拆到具体 ASV。默认校正组中,样本一第一个功能由 A 贡献八十、C 贡献二十,二者分别占该功能总量的八成和两成。
样本二则由 A 贡献二十、C 贡献四十。C 在校正后的样本权重中只占约百分之七点四,却贡献了该功能总量的三分之二。原因是它在设计表中具有较多的该功能拷贝。
因此,ASV 在样本中的比例与它对某个功能的贡献比例是两种不同的数。前者以样本中的 ASV 权重为分母,后者以特定功能的总量为分母,不能直接互换。
阅读贡献表时,应明确自己取的是哪一列。本次用于复算功能贡献的是每条 ASV 对该功能的贡献量,以及在该功能内部归一化的贡献比例。名称中含有相对量的其他列,也需要结合分母解释,不能一律按同一种百分比处理。
RARE 标签没有把功能总量删掉
另一组将最小读数门槛设为三十五,并保留分层输出。实际贡献表中 C 被合并到 RARE 类别,但两个功能的样本总量与默认组完全相同。
这说明本次参数改变的是贡献表中的归类方式,没有把对应功能贡献直接从总量中去掉。若只搜索原来的 ASV 名称,可能误以为它消失了,但在汇总类别里仍能找到相应贡献。
整理报告时,应把特征筛除与贡献者合并区分开。前面的 NSTI 筛选改变了参与汇总的输入,当前这组稀有类别处理主要改变贡献的展示粒度,二者不应使用同一个“删除低丰度”标签概括。
从官方序列示例开始,环境问题发生在哪一步
前面的六组对照验证功能汇总。为了检查从序列开始的实际路径,本次还下载官方安装页面提供的示例归档,核对文件校验值,并使用其中的代表序列和 BIOM 计数表运行完整流程。这样能够把我们人为设置的数值对照与真实参考树推断区分开来。
示例只有三十七条序列,但序列放置需要使用参考数据。第一次以十六 GiB 容器内存上限运行显式 EC 表流程时,细菌 EPA-NG 阶段失败,容器状态明确记录内存限制触发终止。随后把上限改为二十四 GiB、进程数改为一,细菌和古菌放置阶段都通过。这个经验说明,不能仅用输入序列数量推断参考计算阶段的资源需求,也不能把所有非零退出都归为同一种故障。
本次还检查了固定版本的流程源码。默认双域流程在准备阶段会检查多套默认性状表,仅选择 EC 输出并不等于准备时完全不读取其他表。为明确实验范围,本次将镜像自带的细菌与古菌 EC 表分别通过两项自定义性状表参数传入,同时将反应类型设为 ec.txt。使用的仍是安装包自带参考,没有手工改写预测值。
这种显式传表方式会影响输出名称。本次功能汇总目录叫 ec.txt_metagenome_out,如果沿用另一套教程中的目录名称寻找结果,可能误判没有生成文件。实际处理应先检查运行命令、日志和目录列表,再把具体文件路径交给下游脚本。
序列通过两套参考放置后,软件比较并选择对应域。本次三十五条被保留到细菌参考分支,两条被保留到古菌参考分支。不能因为下载文件名中出现古菌相关缩写,就把整份输入当成全部来自古菌。这类样本说明必须依据文件内容和实际输出,而不能只看目录名称。
完整复现入口也放在下载包内,既可以只运行轻量的汇总对照,也可以加上官方示例归档,继续执行序列放置、性状预测、功能汇总和通路计算。读者检查一次新环境时,可以先确认版本与参考,再顺着日志确定失败发生在哪个阶段,避免在没有结果的情况下直接修改下游统计参数。
完整结果怎样验收,不能只看目录存在
这次官方示例的输入表包含二十四个样本,总计十万八千七百一十八个计数。完整流程最终正常退出,三十七条序列全部进入功能汇总,输出一千三百三十一个 EC 功能条目和三百一十二个通路条目,两个结果表均保留二十四个样本。
我们把三十二万零六百二十六行贡献记录按功能与样本分组,再将贡献量相加,与非分层功能表逐格比较。全部数值在浮点容差内一致,最大绝对差约为 7.3e-12。这种核对直接连接了贡献明细与总表,比单看文件大小或流程退出状态更能说明输出之间是否相互对应。
这里的功能条目数和通路条目数属于本次示例、参考与参数组合的输出,不能推广为任意扩增子样本应当出现的数量。通路预测也不等于这些通路已在样本中被直接测到或处于活跃状态。复现包分别保存完整示例汇总与设计参数对照,便于读者分清每一项结论来自哪里。
所有 ASV 都被筛掉时,应该怎样读结果
最后一组将 NSTI 门槛降到 0.01,低于三条设计 ASV 的数值。程序实际以非零状态退出,明确提示所有 ASV 都被过滤,没有生成可用功能表。
这种结果不能写成样本不含任何功能,也不能填一张全零矩阵继续做比较。当前参数下没有输入能够支持后续汇总,应先检查筛选条件和数据适用性。
对真实项目,建议保留样本计数表、代表序列、预测拷贝数、NSTI、校正后的表和贡献表。这样看到功能变化时,可以沿着具体 ASV 追查,而不是只面对一张无法解释来源的热图。
PICRUSt2 的价值在于利用已有标记基因数据形成可以进一步验证的功能假设。它的局限是这些结果依赖参考与预测步骤,不能替代对样本功能基因的直接观测,更不能仅凭预测丰度推断功能已经表达或发生了特定生化反应。
下载包提供三份设计输入、六组真实命令输出、设计对照贡献表,以及官方完整示例的运行驱动和核对汇总,读者可以逐项检查参数怎样改变结果。下载实跑脚本与本次结果
当项目需要对多个扩增子批次统一功能预测流程,并核对参考、筛选范围和贡献来源时,可了解云生信的生物信息学分析计算服务。


