
整理两次细菌注释结果时,如果基因总数相同,却发现很多功能名称变了,不能直接下结论说软件发现了不同的基因。位置预测、蛋白翻译、功能命名和条目编号属于不同层次,必须分别核对,才能知道变化发生在哪一步。
本文实际安装 Prokka 1.15.6,从公开大肠杆菌参考中取出同一段二十万碱基序列,运行普通模式、快速模式、改变位点标签,以及加入指定蛋白四组对照。所有输入核酸完全相同,随后比较每个特征的坐标、蛋白序列校验值和功能名称,让差异能够追溯到具体参数。
使用前先知道这个项目目前的定位
Prokka 仍常见于已有细菌分析流程和历史项目中。核对本次资料时,项目作者已在说明中建议后续流程考虑 Bakta,版本发布说明也明确了维护方向。因此,本文更适合需要复现已有结果、检查注释文件或理解参数行为的读者,不把历史使用广泛等同于仍在积极扩展功能。Prokka 项目说明
旧项目并不需要因为有了新工具,就立即把所有样本重新注释。如果研究要与既有结果比较,首先应确认旧软件、数据库和参数是否能够重现,再单独评估替换工具后产生的变化。否则,版本更换与样本差异混在一起,很难解释新增或减少的基因。
安装后为什么还要记录数据库
本次使用 BioContainers 的固定版本镜像,实际版本输出为 1.15.6。镜像摘要、数据库列表以及实跑脚本一并保存在复现材料中,避免只保留一个容易变化的镜像标签。
PROKKA_IMAGE='quay.io/biocontainers/prokka:1.15.6--pl5321hcbfc158_1'
docker pull "$PROKKA_IMAGE"
docker run --rm "$PROKKA_IMAGE" prokka --version
docker run --rm "$PROKKA_IMAGE" prokka --listdb
软件版本告诉我们调用的是哪一套程序逻辑,数据库列表和环境摘要帮助确认它实际能够搜索哪些参考。功能名称依赖这些参考,单独记录软件版本不足以解释命名差异。对正式研究,还应保留镜像摘要或明确的数据库文件记录。
安装成功也不代表所有研究对象都适用。需要先确认输入是适合该流程的原核组装,并明确遗传密码表与分析目的。本文固定细菌模式,不把这组实验推广到真核基因组,也没有比较不同遗传密码表带来的翻译变化。1.15.6 版本说明
同一段输入如何做到可核对
公开参考为大肠杆菌 K-12 MG1655 的 NC_000913.3,完整序列长度为四百六十四万一千六百五十二碱基。驱动首先检查完整序列长度与校验值,再取一到二十万的连续区间作为本次输入,写成只有一条记录的 FASTA。NCBI 参考序列
这里分析的是参考中的一个片段,不能把它的基因数量报告为完整菌株基因组的注释数量。截取边界可能切断原有基因,基因预测模型也会根据本次输入训练,因此所得结果只代表这段输入和对应参数。
校验时使用去掉标题、连接所有序列行并转为大写后的核酸内容。这样可以区分换行或标题改变与碱基本身改变。四组实验共用同一份片段文件,并进一步确认输出核酸仍与该片段一致,防止比较过程中误用了不同组装版本。
普通模式先建立可以逐项对照的基线
基线明确设置输出目录、文件前缀、位点标签和线程数。文件前缀决定一组结果叫什么,位点标签用于输出特征编号,二者并不替代序列身份。
prokka --cpus 2 --kingdom Bacteria \
  --outdir baseline --prefix sample \
  --locustag BASE segment.fna
本次基线实际得到 169 条 CDS 和 169 条蛋白记录,其中 16 条 CDS 被命名为假定蛋白。这个统计只描述软件当前给出的结果,不表示其余条目已经全部经过实验验证。
检查时不能只读取最后一行统计。我们同时解析主注释文件与蛋白文件,为每条蛋白计算序列校验值,并以序列编号、起止位置、方向和特征类型共同定位条目。这样后续即使名称或标签发生变化,仍然能够找到对应对象。
几种输出文件分别回答什么问题
主 GFF 文件包含特征坐标和属性,并带有输入序列部分。查看它可以确认某个条目在哪条序列、哪个区间和哪条链上。蛋白 FASTA 则适合检查翻译产物,或作为后续蛋白搜索和聚类输入。
核酸特征文件与蛋白文件不能直接互换。前者还可能包含 RNA 等非蛋白特征,因此两份文件的记录数不一定相等。本次核酸特征文件与蛋白文件恰好都是一百六十九条,因为当前这段输入的输出特征均为 CDS。这种相等关系不能推广到包含 RNA 注释的其他数据。
另外,功能名称表方便快速筛选,但它不能替代完整坐标和原始序列。若只把名称表导出到电子表格,日后很难核对某个名称变化是否对应同一个蛋白。建议至少共同保留主注释、核酸、蛋白、统计及日志文件。
快速模式改变了哪些结果
第二组仅增加快速模式选项,其余输入与主要参数保持一致。程序实际运行后,再把它与普通模式逐条匹配。
prokka --cpus 2 --kingdom Bacteria \
  --outdir fast --prefix sample \
  --locustag BASE --fast segment.fna
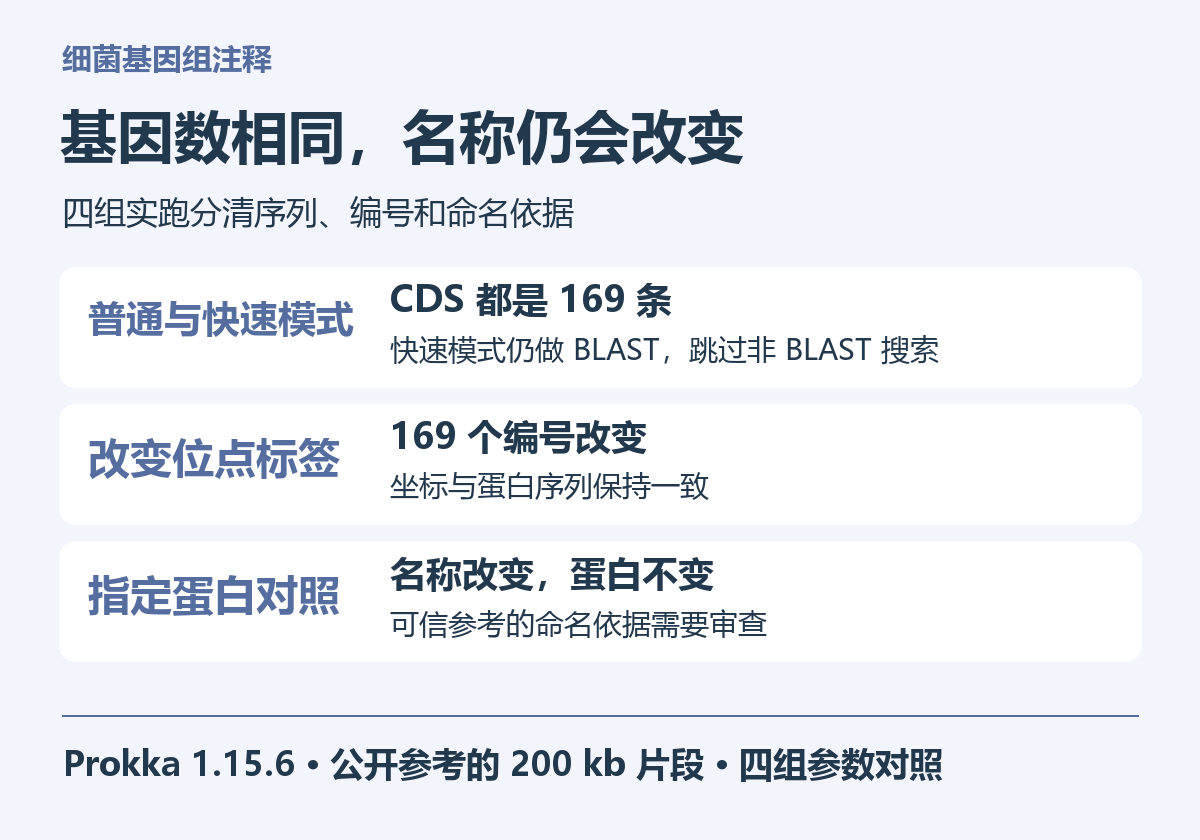
本次两组的特征坐标集合一致,蛋白序列及其重复次数也一致,但快速模式中假定蛋白条目增至 17 条。可见,结构预测结果相同,并不要求功能名称也相同。实际日志显示,快速模式仍运行基础 BLAST 搜索,跳过的是非 BLAST 搜索,其中包括本次的 HAMAP 隐马尔可夫模型搜索。因此,不能把这个选项解释为完全不做功能搜索。
这种对照适合检查流程是否能够从核酸产生预测编码区和蛋白序列。但如果研究重点是功能构成,不能把快速模式与完整搜索模式的假定蛋白比例直接当成样本之间的生物学差异。
还需要避免另一种误读。假定蛋白并不等于没有预测到蛋白,也不等于该位置没有基因。它说明当前结果没有给出足够具体的功能命名,结构预测与功能解释仍然是两件需要分别核对的事。
| 运行条件 | CDS 数 | 假定蛋白数 | 与基线蛋白序列比较 |
|---|---|---|---|
| 普通模式 | 169 | 16 | 基线 |
| 快速模式 | 169 | 17 | 完全一致 |
| 改变位点标签 | 169 | 16 | 完全一致 |
| 加入指定蛋白 | 169 | 16 | 完全一致 |
哪一条功能名变了,日志能否解释
本次普通模式与快速模式只有一条产物名称不同,对应片段四万四千一百八十到四万五千四百六十六的正链 CDS。普通模式将其命名为硫胺素噻唑合酶,快速模式将其保留为假定蛋白。两条记录的预测坐标和蛋白序列完全一致,所以差异发生在功能命名层面。
我们不仅查看了最终表格,还核对了实际搜索日志和固定版本源码。普通模式执行了基础蛋白搜索与后续模型搜索,快速模式明确记录跳过非 BLAST 数据库。程序帮助也把该选项描述为只使用基础 BLASTP 数据库,这比把它笼统称为“关闭功能注释”更准确。固定版本的参数与搜索实现
这个经验适用于阅读许多工具教程。一个选项名称可能保持多年,但帮助文字、流程和默认数据库会变化。解释实跑结果时,应把当前版本帮助、日志和输出相互核对,而不能只依赖旧教程中一句简短说明。
改编号以后,怎样确认仍是同一条蛋白
第三组把位点标签从 BASE 改成 RENAMED,其他条件保持基线设置。实际比较发现,169 个共享特征的编号改变,但特征坐标和蛋白序列集合没有变化。
prokka --cpus 2 --kingdom Bacteria \
  --outdir renamed --prefix sample \
  --locustag RENAMED segment.fna
因此,不能拿两个不同标签的名称表直接按编号求交集,再把没有匹配上的编号解释为新增或丢失基因。编号可以帮助定位当前结果,但是否属于同一个生物序列对象,还需要结合序列与坐标判断。
本例只改变标签前缀,坐标没有变化,所以匹配比较直接。真实项目如果同时发生组装修订、序列重排或边界改变,原坐标可能也不能直接使用,需要借助序列比对建立对应关系。校验值完全相同可以快速确认相同序列,校验值不同则只说明内容不同,不告诉我们差异有多大。
还有一种需要保留的情况是重复蛋白。若两个位置产生相同蛋白,简单去重成一个校验值会丢掉拷贝信息。本次比较使用包含重复次数的序列集合,因此不仅检查有哪些序列,也检查每种序列出现几次。
指定蛋白如何影响功能命名
第四组从基线中选取一条长度至少一百五十个氨基酸的蛋白,原样复制其序列,给它一个专用于对照的名称。我们明确把这个名称视为人为标签,不把它当作新增功能证据。
本次选中的是 BASE_00001,长度为 820 个氨基酸。驱动为它设置演示用基因名 demoX 和产物名称 Controlled annotation label,再通过指定蛋白选项交给软件。
prokka --cpus 2 --kingdom Bacteria \
  --outdir trusted --prefix sample \
  --locustag BASE --proteins trusted.faa segment.fna
实际结果中,目标条目的命名随指定参考发生变化,蛋白序列却与基线一致。这说明可信蛋白输入会参与并影响命名决策。若可信库本身标错了,后续输出可能继续沿用错误名称,不能因为结果来自自动化流程就免除对参考来源的审查。
指定蛋白的 FASTA 标题格式也需要按工具要求准备。简单格式只提供标识和产物说明,详细格式可以写入酶学编号、基因名称、产物和其他注释。本次驱动明确生成适合 Prokka 的标题,不把其他注释工具的自定义格式直接复制过来使用。
可信参考应当怎样选择
在正式项目中,优先使用来源明确、功能注释经过适当审查且与研究对象相关的蛋白或参考基因组。需要保留参考版本、来源和加工步骤,尤其要记录是否人为改过基因名或产物描述。
从自己上一轮自动注释中提取蛋白,再把它作为可信库重新注释,可以改善名称一致性,但不会自动增加独立证据。本次刻意复制基线蛋白并赋予演示名称,就是为了把这一点展示清楚。
名称一致也不是质量的唯一标准。两个样本使用同一个错误参考,可以得到非常整齐的功能表,却把相同的偏差传递到每个样本。比较分析应同时关注命名来源、覆盖范围以及是否存在只得到部分匹配的条目。
对照结果如何用于真实项目
如果两次注释基因总数相近,建议先抽查变化最大的功能类别。沿着对应条目检查核酸是否相同、预测边界是否相同、蛋白序列是否相同,最后再看命名依据。这个顺序能帮助区分组装变化、预测变化与名称变化。
如果蛋白相同但名称不同,优先检查数据库、指定参考、快速模式和名称整理规则。如果蛋白已经不同,则需要进一步查看起始位点、读框、截断和组装内容,而不能只修改表格中的名称使两版看起来一致。
当假定蛋白比例明显上升时,也应先核对运行范围。跳过搜索、参考覆盖不足或输入变化都可能影响这个比例。只有在环境与参数可比较、数据质量也得到检查后,才适合讨论样本层面的差别。
本次没有用四组运行评估注释准确率,没有把演示标签作为功能验证,也没有把片段上的基因数外推到完整基因组。它提供的是一种可复用的核对方法,让读者能够把注释差异拆到具体文件和具体参数,而不是只比较汇总数字。
复现包包括公开参考校验规则、四组命令、特征坐标、蛋白校验值以及发生名称变化的条目,便于检查每一个结论的来源。下载脚本与实跑结果
需要批量维护菌株注释、统一参考版本并核对跨批次结果时,可了解云生信的生物信息学分析计算服务。


