
只有肿瘤样本时,拷贝数分析往往需要借助正常参考。这里最危险的误解是,只要参考不是肿瘤,而且平均覆盖够高,就可以拿来比较。实际上,实验设计和处理流程造成的区域偏差会直接进入覆盖比值,可能削弱真实变化,也可能制造原本不存在的变化。
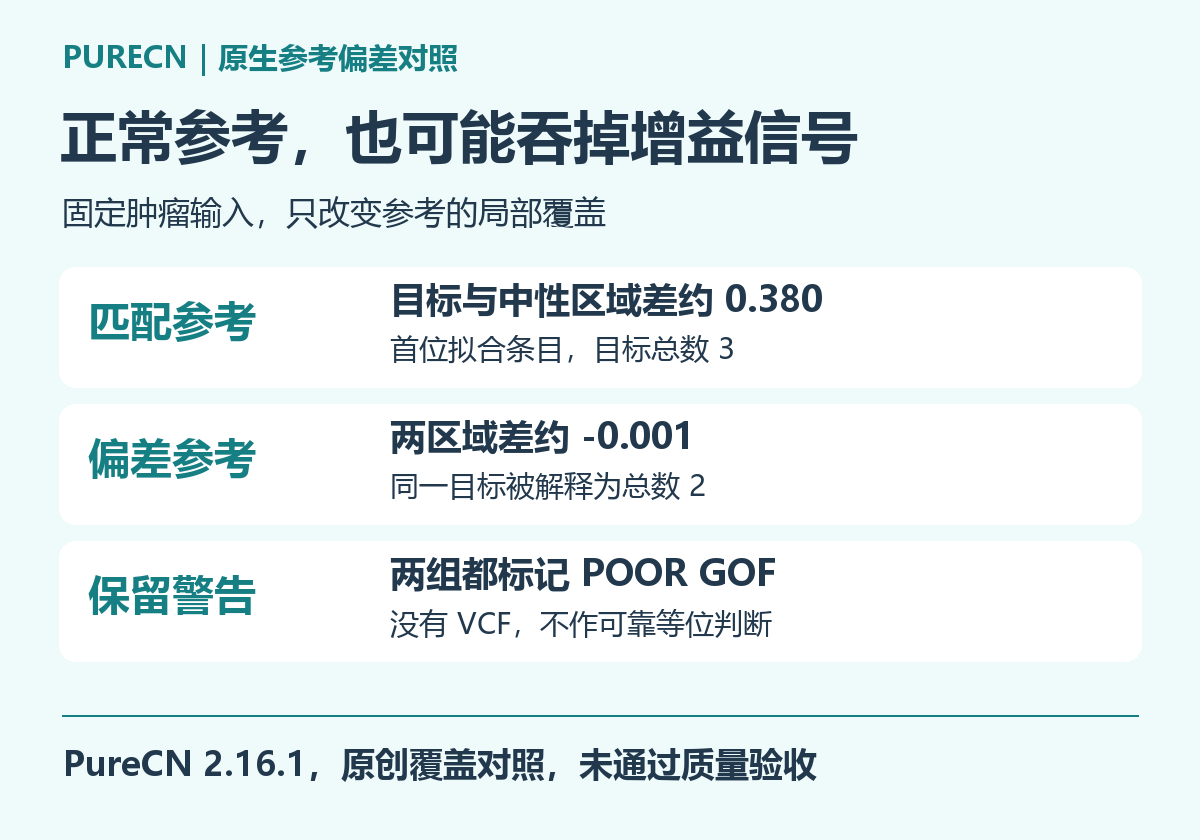
本文实际安装 PureCN 2.16.1,用原创覆盖数据比较两种正常参考。肿瘤输入保持完全不变,只在第二种参考的一段区域引入额外覆盖。原生归一化后,该区域与中性区域的差异明显缩小,后续首位拟合条目的总拷贝数从三变成二。同时,两组结果都带质量警告,本文不会把它们写成通过验收的真实分析。
正常参考提供的是比较基准
相对覆盖分析的基本问题是,肿瘤在某个区间的信号,相比可比较的正常基准是否偏高或偏低。捕获效率、片段组成、比对方式和区间定义等因素,都可能影响这个比值。因此,参考并不是一张可以随意替换的背景表,而是决定相对信号含义的一部分。
PureCN 支持在合适的参考和变异信息支持下分析没有配对正常样本的肿瘤。这个能力不等于不需要正常相关信息,也不表示不同面板或流程的正常数据都能混用。工具的总体任务范围可查 Bioconductor 软件介绍,具体操作仍需结合安装版本和数据条件。
官方实践强调正常数据应与肿瘤在实验和处理流程上匹配,正常库也需要按适合的实验设计建立。相关原则见 PureCN 实践说明。本文用两个简化参考直接做受控对照,没有建立完整正常库,也没有测试切线归一化在队列中的表现。
这个实验实际运行了哪些步骤
我们生成一份肿瘤覆盖和两份正常覆盖,调用原生读取与覆盖比值计算,再调用原生分段及纯度、倍性候选拟合。两组均没有提供变异文件,目的是隔离正常参考对总量信号的影响,而不是模拟完整的仅肿瘤分析流程。
没有变异信息时,局部等位状态和一些候选解之间的区分能力受到限制。因此,本文只报告实际得到的覆盖比值、总量候选以及质量标记,不推断等位特异状态、突变来源或杂合性丢失。代码里还实际调用了一次相应下游函数,确认软件对缺失变异输入给出的错误,而不是凭想象描述限制。
这种边界很重要。软件能接受某种不完整输入,并不代表它能在这种输入下可靠回答所有功能介绍中列出的问题。阅读教程时应检查实际传入了哪些信息,而不能从包名和最终文件数量推断分析范围。
三千六百个区间的生成条件
数据覆盖六条模拟常染色体,每条六百个区间,共三千六百个区间。每个区间宽二百碱基,区间间隔固定。肿瘤纯度设为零点六,各条染色体的肿瘤总数依次为二、三、一、二、四、二。正常细胞均按二倍体计算。
第一份正常参考与肿瘤共享同一个基础捕获轮廓,再分别叠加小幅随机波动。第二份正常参考在第二条模拟染色体的覆盖额外乘以一点三,其余区域保持同类生成方式。这个一点三来自人为设置的参考区域偏差,不是正常样本真的发生了对应的生物学扩增。
对于肿瘤总数三、纯度零点六的区域,简单混合模型给出相对于二倍体正常的信号约为一点三。若正常参考在同一区域也被技术因素抬高到一点三,肿瘤与参考的局部比值就会接近一。这个设计让我们能直接观察真实模拟增益如何被参考偏差抵消。
| 输入 | 肿瘤第二染色体状态 | 正常参考局部设置 | 对照目的 |
|---|---|---|---|
| 匹配组 | 总数3,纯度0.6 | 基础捕获轮廓 | 匹配参考 |
| 偏差组 | 完全相同肿瘤输入 | 基础轮廓再乘1.3 | 区域偏差参考 |
| 两组共有 | 其余状态相同 | 区间坐标一致 | 固定比较对象 |
这些区间不是实际外显子注释,染色体上的状态也不代表某个患者。输入没有真实碱基组成、可比对性或变异证据,因此不能据此量化正常库选错时在真实项目中会产生多大误差。它验证的是一个明确的因果方向,参考改变足以改变被解释的相对信号。
安装后,缺少计数字段为何会全被过滤
本次环境为 Ubuntu 22.04.5、R 4.5.3,独立安装固定版本 PureCN。初次输入采用覆盖表格式,虽然深度字段很高,但没有提供有效读数计数字段。原生过滤阶段提示三千六百个区间的总读数不足,最终没有区间可以进入分段。
这个错误说明深度和读数计数不是同一列。一个区域的平均深度高,不表示读表器一定能够从已有字段得到所需的读数。我们在原创输入中补充了明确的模拟计数定义,按区间宽度、深度和假定读长生成相应计数,然后重新运行。没有通过关闭低计数过滤来掩盖输入缺失。
micromamba create -n purecn-demo -c conda-forge -c bioconda bioconductor-purecn=2.16.1 r-jsonlite
python run.py --rscript /path/to/purecn-demo/bin/Rscript --work purecn-demo-output
本例计数是生成器的一部分,假定读长为一百五十碱基,不是从真实比对文件重新统计的结果。将这类模拟表迁移到实际任务时,应使用对应覆盖工具的真实字段和定义,不能把教程中的换算式当作通用于所有成对测序、去重和片段统计方式的精确公式。
另一个探针读取压缩示例时提示缺少可选解压依赖。最终教学输入使用普通文本文件,不依赖该压缩读取路径。如果读者使用压缩文件,应按官方依赖说明补齐,而不是认为包能够加载就意味着所有输入格式都已可用。
先比较归一化信号,再看整数
两组都调用相同的原生覆盖比值函数。匹配参考下,第二条染色体的对数比值中位数约为零点二八八四,中性第一条染色体约为负零点零九一九。两者相差约零点三八零二,保留了预设增益相对于中性区域的区别。
使用带偏差参考后,第二条染色体约为负零点零二四四,第一条约为负零点零二三一,两者几乎重合。这个结果比仅看最终整数更直接,因为它表明变化已经发生在拟合之前。后续模型接收到的信号,本身已经不再显示那段预设增益。
| 原生结果 | 匹配参考 | 带区域偏差参考 |
|---|---|---|
| 第一染色体log2中位数 | -0.091855 | -0.023149 |
| 第二染色体log2中位数 | 0.288351 | -0.024425 |
| 第二减第一 | 约0.380205 | 约-0.001276 |
| 首位条目第二染色体总数 | 3 | 2 |
| 首位条目质量标记 | POOR GOF | POOR GOF |
中性区段没有恰好等于零,也不应立即判断为缺失。原生计算包含整体校准,队列中增益和丢失的构成会影响信号中心。这里比较中性区域与目标区域的差异,比单纯要求所有中性位置都在零线上更符合实际处理步骤。
候选拟合输出说明了什么
随后使用相同参数进行原生分段与候选拟合,两组都得到六段主要结果。为了形成有限教学对照,纯度候选设为零点三到零点九,步长零点零五,倍性范围为一点五到五,迭代次数设为十,使用串行并行接口。它们是本例运行条件,不是队列分析的统一推荐配置。
fit <- runAbsoluteCN(
  normal.coverage.file=normal,
  tumor.coverage.file=tumor,
  genome="hg19", sex="diploid",
  test.purity=seq(0.3, 0.9, 0.05),
  min.ploidy=1.5, max.ploidy=5,
  max.candidate.solutions=3, iterations=10,
  plot.cnv=FALSE, BPPARAM=BiocParallel::SerialParam()
)
匹配参考的首位结果条目给出总数二、三、一、二、四、二,带偏差参考给出二、二、一、二、四、二。两者的纯度都为零点六,但倍性摘要不同。这提醒我们,全局纯度相同并不能保证每个局部事件相同,也不能保证参考已经可比。
实际保留下来的结果条目分别为四个和五个,因此我们记录实际输出数量,而不是把某个参数中的数字直接当作最终结果数量。候选生成、优化和去重属于不同阶段。审查结果时应先看对象结构和日志,确认自己正在读取哪一层候选。
质量警告必须与数值一起交付
两组首位条目都带有质量标记,拟合优度字段为零,注释为拟合优度不足。我们没有删除这个字段,也没有因为部分整数与模拟设定一致,就把这两个输出称为通过质量验收。软件计算结束与分析结果可用于生物学判断,是两个不同条件。
本例缺少正常数据库、变异文件以及用于真实组成审查的区间注释,日志也提示相应缺项。它不是一个完整的仅肿瘤分析实例。输出适合用于观察参考偏差怎样传递,不能直接作为生产流程模板,更不能据此宣称可靠恢复了真实肿瘤纯度。
实际调用杂合性丢失函数时,程序明确指出此前运行没有变异文件,拒绝继续给出结果。这个失败是有信息的,它说明当前输入不支持该项任务。总数为二的区域既可能等位平衡,也可能包含等位丢失,缺少相应证据时应保留未判定状态。
正常库、配对正常和覆盖参考不要混为一谈
一个正常覆盖文件提供局部比较信号,正常数据库则可以汇总多个正常样本的区域质量和变化特征,变异背景还涉及等位偏差等问题。这些对象即使都来自正常样本,承担的作用也不同。不能因为传入了一个正常文件,就在方法部分写成已经建立了完整正常库。
配对正常在样本身份上有优势,但仍需检查实验处理是否匹配。非配对正常可以为某些任务提供技术基准,但不能替代所有需要配对身份的信息。选择参考时,应分别回答它是否适合覆盖比较、是否适合背景过滤,以及是否支持当前等位或体细胞问题。
对于混合了不同捕获面板或流程的历史数据,先按实验设计检查正常参考的可比性通常更有价值。若某个区域在参考中长期偏高,不能简单把它归一化掉后就认为没有问题。应检查该偏差是稳定技术特征、个别异常样本,还是不适合混合的数据来源。
优缺点与下一步操作
PureCN 的优势是能把覆盖、候选纯度与倍性、变异和局部状态纳入较完整的分析体系,并允许检查候选和质量标记。难点也来自这些输入之间的依赖,参考、变异信息和实验设计不充分时,完整的输出对象仍可能包含不可用或需要复核的结果。
实际接手任务时,可先检查参考与肿瘤的区间是否一致,再审查覆盖字段、计数和归一化信号,随后查看候选与警告,最后决定哪些下游问题具备足够证据。如果目标区域在拟合前就被参考抵消,继续调整最终调用阈值通常无法补回已经丢失的比较信息。
附件保存原创生成脚本、两组原生调用、候选摘要和实际警告。本文没有测试完整正常库构建、真实变异分类或准确率,读者可以复现的是同一肿瘤覆盖在不同参考下发生的变化,以及如何从日志和中间量定位变化来源。
下载原创输入生成脚本、原生调用与实际结果(ZIP)。合集按工具分目录,Sequenza、PureCN 为原生运行对照,GISTIC2 为独立读表练习。按各自说明准备环境,使用新的输出目录复跑。
准备按面板建立固定环境并批量分析时,可带上样本数量、参考数据来源和软件版本,向云生信生物分析服务器业务咨询运行环境与资源安排。


