
肿瘤纯度与倍性分析常会给出不止一个可行解。如果将搜索范围缩窄后,高倍性解排到第一位,能否认为模型更支持肿瘤发生了基因组加倍?这个问题不能只看排名。排除另一类候选,本身就会改变剩余候选的相对位置,甚至改变归一化后的支持数值,而输入测量可能完全没有变化。
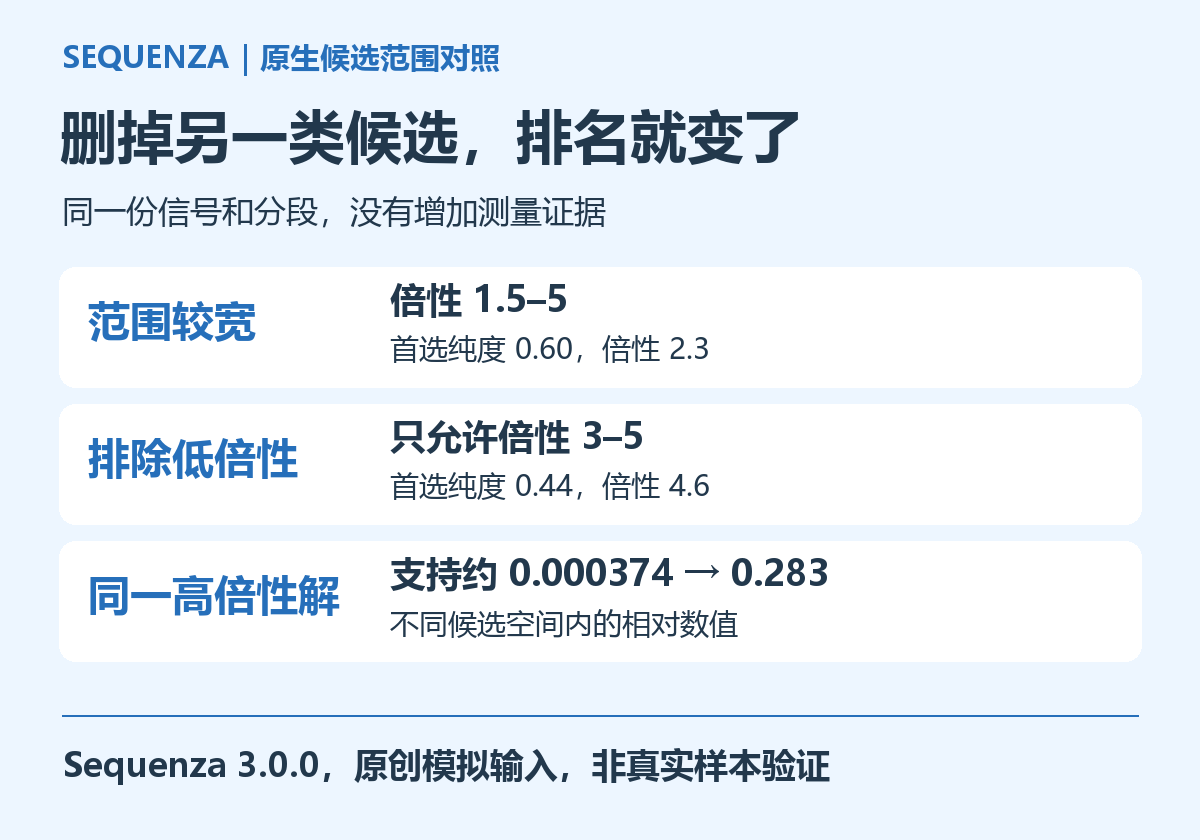
本文实际安装 Sequenza 3.0.0,生成原创配对测序摘要,运行原生读取、校正、分段和模型拟合。我们固定同一份提取结果,只改变允许搜索的倍性范围。较宽范围内,首选纯度为零点六、倍性为二点三。排除低于三的倍性后,纯度零点四四、倍性四点六成为首选。下面解释这个变化为什么不能直接当成新的生物学证据。
联合估计纯度和倍性为何可能有多个解
测序覆盖反映的是肿瘤细胞与正常细胞混合后的信号,且通常经过整体归一化。局部覆盖升高,既可能对应肿瘤细胞中的较高拷贝数,也可能需要结合整体倍性和正常细胞比例重新解释。等位频率提供额外约束,但并不保证在任何输入质量和事件结构下都能得到唯一答案。
可以把分析理解为,软件在许多纯度与倍性组合下,分别寻找能够解释局部总量和等位组成的整数状态,再比较这些组合。某些组合对多个区段都有相近解释,便可能形成不同的局部最优点。最终输出一个排名,不意味着其他峰从数学上已经不存在。
Sequenza 的原生工作流先提取与分段,再评估候选网格,最后可按选择的解导出结果。三个阶段的职责与候选范围参数可查 归档版本工作流说明。本文保留整个拟合网格,并没有只保存被选中的那一个数字。
先说明版本状态和安装边界
本次使用 Ubuntu 22.04.5、R 4.4.3 与 Sequenza 3.0.0。这个软件包已不在 CRAN 主仓,官方页面记录了归档状态,因此直接执行通常的在线安装命令可能找不到它。需要从归档或固定版本的软件环境获取,同时核对依赖。CRAN 包状态。
实际安装时遇到两件不同的问题。首先,环境管理器显示事务结束,但加载软件时仍提示缺少基因组信息数据包。我们从对应 Bioconductor 版本下载数据包并完成安装后,才确认软件能加载。事务结束只说明安装流程走到了终点,不能替代实际加载检查。
其次,当前输入输出依赖的分块函数改变了并行参数名称,旧提取函数调用时出现参数未使用错误。我们没有删除校正过程,也没有修改模型代码,而是利用原生支持的预先提供组成统计量选项,按同一份模拟输入计算统计表后传入。这个处理避开的是旧分块读取入口的兼容问题。
micromamba create -n sequenza-demo -c conda-forge -c bioconda r-sequenza=3.0.0 r-jsonlite
python run.py --rscript /path/to/sequenza-demo/bin/Rscript --work sequenza-demo-output
附件说明列出缺失数据包的补装方式。对于归档工具,最有用的记录是具体版本、实际错误、补齐了什么以及最终跑到了哪一步。仅写“安装成功”会掩盖环境问题,直接换成一份现成结果又无法验证当前环境是否真的可执行。
模拟数据怎样兼顾总量与等位信息
我们生成六条模拟常染色体,每条一千个位点,间距一万碱基,共六千个位点。每条染色体一半为正常杂合位点,另一半为正常纯合位点。正常深度均值设为二百,肿瘤深度按纯度零点六及指定拷贝数组成生成,两者都有抽样波动。
各条染色体的肿瘤总数依次为二、三、一、二、四、二,次要数依次为一、一、零、零、一、一。因此既有增益与丢失,也有总量不变但等位组成改变的区域。六段总数的平均值约为二点三三三,这是本例的模拟参照,不是某个真实样本的病理测量。
每个位点还随机分配一个组成百分比,分布与拷贝状态独立。脚本按这个百分比分组,对正常和肿瘤各自的深度计数生成统计矩阵,并给出各染色体在文件中的行范围。这些就是传给提取函数的统计量,原生函数仍据此完成自己的归一化步骤。
这种设计没有引入真实捕获偏差、比对错误、复杂亚克隆或测序批次效应。它适合观察候选范围对同一信号解释的影响,不能用来评估实际肿瘤检测灵敏度。模拟坐标只用于形成可处理的区间,读者不应据此寻找对应位置的真实致病基因。
从输入列到原生分段
输入包含正常与肿瘤深度、两侧等位频率、正常合子状态和组成统计等列。这里的深度比是线性比值,不是对数比值。把已经取过对数的数字写进线性比值列,会改变模型的量纲,单靠文件能够读取无法发现这类概念错误。
| 信息 | 在练习中的作用 | 不能替代什么 |
|---|---|---|
| 正常与肿瘤深度 | 构造总量比值及权重 | 真实比对质量审查 |
| 正常杂合状态 | 确定等位信息来源 | 肿瘤体细胞变异分类 |
| Af与Bf | 表达两侧比例 | 具体父母来源 |
| GC统计矩阵 | 供原生校正使用 | 完整参考基因组 |
| 候选纯度与倍性 | 定义模型搜索范围 | 新的测量证据 |
原生提取产生六个主要分段,每条模拟染色体一个。增益、丢失以及等位不平衡的信号在分段摘要中保留下来。用于拟合的每段长度超过默认三百万碱基过滤阈值,深度与等位观测数也满足相应条件,所以本例没有靠降低过滤要求来保留极短事件。
提取日志还出现了密度估计带宽选择未使用权重的提示,我们完整保留了这些提示。它不能被简写成所有权重都被忽略,也不能因为结果与设定接近就当作无需说明。本文没有进一步评估不同带宽选择方法的影响,这属于复用旧版本时应知道的限制。
两组候选网格只差一个范围
两次拟合使用同一个提取对象,纯度候选都从零点三到零点九,步长零点零二。第一组倍性从一点五到五,第二组从三到五,步长都为零点一。其他条件保持一致,并使用单进程执行,使比较集中在候选空间变化上。
cp.full <- sequenza.fit(
  extracted, chromosome.list=as.character(1:6),
  cellularity=seq(0.3, 0.9, 0.02),
  ploidy=seq(1.5, 5, 0.1), mc.cores=1
)
cp.restricted <- sequenza.fit(
  extracted, chromosome.list=as.character(1:6),
  cellularity=seq(0.3, 0.9, 0.02),
  ploidy=seq(3, 5, 0.1), mc.cores=1
)
这组范围并非完整默认网格,也不是针对所有真实样本的推荐参数。它只是覆盖本例主要候选并构成明确对照。真实项目若存在合理的更低或更高倍性,缩小范围可能把重要解释直接排除。计算方便不能成为把生物学可能性删掉后不再说明的理由。
弱候选为什么能变成强候选
较宽范围内,原生首选为纯度零点六、倍性二点三,该网格点的归一化支持约为零点四九七九。另一个局部最优点位于纯度零点四四、倍性四点六,支持约为零点零零零三七四。后者仍存在,但在这次比较空间里远弱于前者。
限制范围后,原来的低倍性首选不再有资格参与比较。四点六倍性解成为首选,该点的归一化支持上升到约零点二八三零。这个数值变化没有伴随额外读段、额外杂合位点或新的实验结果,它来自竞争集合和归一化分母的改变。
| 比较项目 | 倍性1.5至5 | 倍性3至5 |
|---|---|---|
| 网格大小 | 36×31 | 21×31 |
| 首选纯度 | 0.60 | 0.44 |
| 首选倍性 | 2.3 | 4.6 |
| 首选点支持 | 约0.497930 | 约0.283037 |
| 4.6倍性局部解支持 | 约0.000374 | 约0.283037 |
不能把最后一行直接解释为高倍性解的生物学可信度提高了数百倍。两列是在不同候选空间内归一化的数值,而且这里列的是单个离散网格点的支持,不是对整个高倍性区域积分后的概率。比较支持之前,必须先确认比较对象和分母是否相同。
网格点支持与参数区间是两回事
一个峰可以覆盖多个相邻网格点。提高网格分辨率后,同一片区域的支持可能分摊到更多点,单点数值因此改变,而参数解释未必发生同样程度的变化。因此,用固定的单点概率阈值跨不同分辨率分析做质量筛选,容易混入离散化方式的影响。
本例真实平均拷贝数约为二点三三三,但倍性网格步长为零点一,所以首选落在二点三附近符合离散搜索的特点。不能因为输出没有精确等于生成值,就立即判断恢复失败,也不能把输出的小数位数当作实际测量精度。应结合网格间距、峰宽和输入误差一起解释。
软件提供候选解和区间相关函数,读者仍需检查其具体定义。例如当前版本的候选整理逻辑见 原生解整理源码。使用图上的峰、单点支持或参数范围时,应说清各自来自哪一步,不能把不同摘要混称为同一个置信度。
怎样把候选比较变成有依据的判断
首先保留完整或足够宽的搜索结果,观察是否存在多个分离的峰。然后检查每个候选如何解释主要增益、丢失和等位不平衡区域。如果一种候选需要大量难以解释的局部状态,而另一种与独立证据更一致,这种比较比只看排名更有信息。
其次,外部约束需要注明来源。病理纯度、其他分子检测和可靠的倍性信息可以帮助缩小解释范围,但约束后的结果应该明确是结合这些信息得到的。不能先凭主观预期删除候选,再把剩余答案说成测序数据独立证明了预期。
对于基因组加倍等全局结论,还应区分整体高倍性、局部高拷贝与历史演化事件。一个高倍性最佳解并不自动给出事件发生顺序,也不能替代克隆演化分析。本文只是展示同一观测可能在不同模型范围下得到不同全局解释。
有分段,不等于这段参与了全局拟合
查看结果时还要区分,某段是否被分出来,与它是否用于约束全局纯度和倍性。拟合入口会按区段长度和观测支持进行筛选,较短或信息不足的片段可能没有参与全局参数比较。看到局部输出里仍有这个区域,不能据此认为它对候选峰贡献了同样多的信息。
如果研究重点恰好是短事件,应先检查它经过哪些过滤,再决定怎样解释局部状态。不能为了让目标基因附近的一个小片段参与拟合,就不加评估地降低全局过滤要求,因为同时进入的其他噪声片段也会改变结果。比较参数前后纳入的区段数量与信号质量,比只比较最优纯度更容易定位变化来源。
优点、限制和复用时的检查顺序
Sequenza 的优势是保留纯度与倍性的二维比较,能让读者看到单个最优数值背后的候选结构。对于需要审查替代解的分析,这种透明度很有价值。限制是旧版本依赖兼容性需要额外维护,输入预处理、分段质量和先验设定也会影响候选形状。
复跑时可以先检查软件加载,再检查输入列与统计矩阵,随后确认分段数量和通过过滤的范围,最后比较候选网格。若结果异常,应按这个顺序定位,而不是首先缩窄搜索范围。每次改变条件都使用新的输出目录,保留原始日志和中间对象。
附件提供原创输入生成、预先统计组成信息的代码、原生调用和实际结果。本文没有运行比对文件到输入摘要的上游步骤,也未完成真实样本验证。读者能够直接复用的是候选审查方法,以及在遇到归档软件兼容问题时,怎样把实际完成的步骤和未验证部分清楚分开。
下载原创输入生成脚本、原生调用与实际结果(ZIP)。合集按工具分目录,Sequenza、PureCN 为原生运行对照,GISTIC2 为独立读表练习。按各自说明准备环境,使用新的输出目录复跑。
当配对分析扩展到多样本、需要固定旧版本环境时,可携带样本规模和依赖清单,向云生信生物分析服务器业务咨询环境与资源安排。


