
组装去冗余之后,有人用原始总长减新总长,想得到“去掉了多少重复碱基”,结果总差一点。还有人发现一个位于候选区右边的基因居然跨过了一串 N。两种现象都要回到去冗余操作是怎样改写 FASTA 的。我们用 purge_dups 1.2.6 官方的序列提取程序,给它一段内部候选和一段端部候选,实际运行三种方式。两个候选区间自始至终相同,最终主文件的条数、名称和坐标却不同。purge_dups 作者的用法说明
把识别候选和如何输出候选分开检查
purge_dups 工作流可以结合读段深度与组装自比对来寻找可能重复表示的单倍型区域,之后再根据候选区间生成保留的主序列与转出的片段。这里专门验证最后一项操作,输入使用人为指定的 BED,所以实验不对软件发现重复的准确率作估计。这个拆分对真实项目也很实用。一个基因从主组装中消失时,先确认它是不是已经出现在候选 BED,然后检查即使给定同一份候选,输出模式本身会怎样改变这条序列。
我们生成三条无模糊碱基的随机序列,分别长五万、三万五千、三万。第一条的内部从零基二万到二万六千标为候选,长六千。第二条的开头从零到五千也标为候选。第三条没有任何候选,作为序列完全不该变化的对照。由于只测试区间处理,这些随机字母不需要真的互为重复。验收时将所有输出重新逐字匹配到原三条序列,正好可以算出哪些碱基转出了主文件、哪些是真正新增的占位,以及重新命名以后每段坐标对应哪里。
为什么侧枝文件和主文件必须一起数
先使用只处理两端的选项。结果中端部候选五千个碱基进入另一个 FASTA,该原片段剩余三万碱基进入主文件。五万碱基长的内部候选所在序列整条保留,未出现 N。第三条三万碱基对照也完整保留。此时主文件共十一万个已知碱基,转出文件五千,二者加起来恰为输入的十一万五千。换句话说,内部候选出现在 BED,和内部候选确实被这次输出剔除,是两个需要分别核对的事实。
默认运行时两段候选都转出,总计一万一千碱基。内部候选原来两侧的已知序列分别长二万和二万四千,程序将它们留在同一条主序列中,中间加入二十三个 N,于是这一条变成四万四千零二十三。端部候选只影响第二条开头,无须在两个剩余片段之间插标记。对照仍然正确。若只用前后的主 FASTA 总长相减,会得到一万零九百七十七,少算二十三。正确的去向可以逐项对上,原输入减真正转出的碱基,再加新出现的占位数,等于输出主文件的总长。该版本 get_seqs 的区间输出实现
| 同一份候选 BED | 内部候选所在主序列 | 主文件总长 | 转出碱基数 |
|---|---|---|---|
-e,只处理两端 |
保留整条 50000 | 110000 | 5000 |
| 默认 | 20000 + 23 个 N + 24000 | 104023 | 11000 |
-s,分开输出 |
20000 与 24000 两条记录 | 104000 | 11000 |
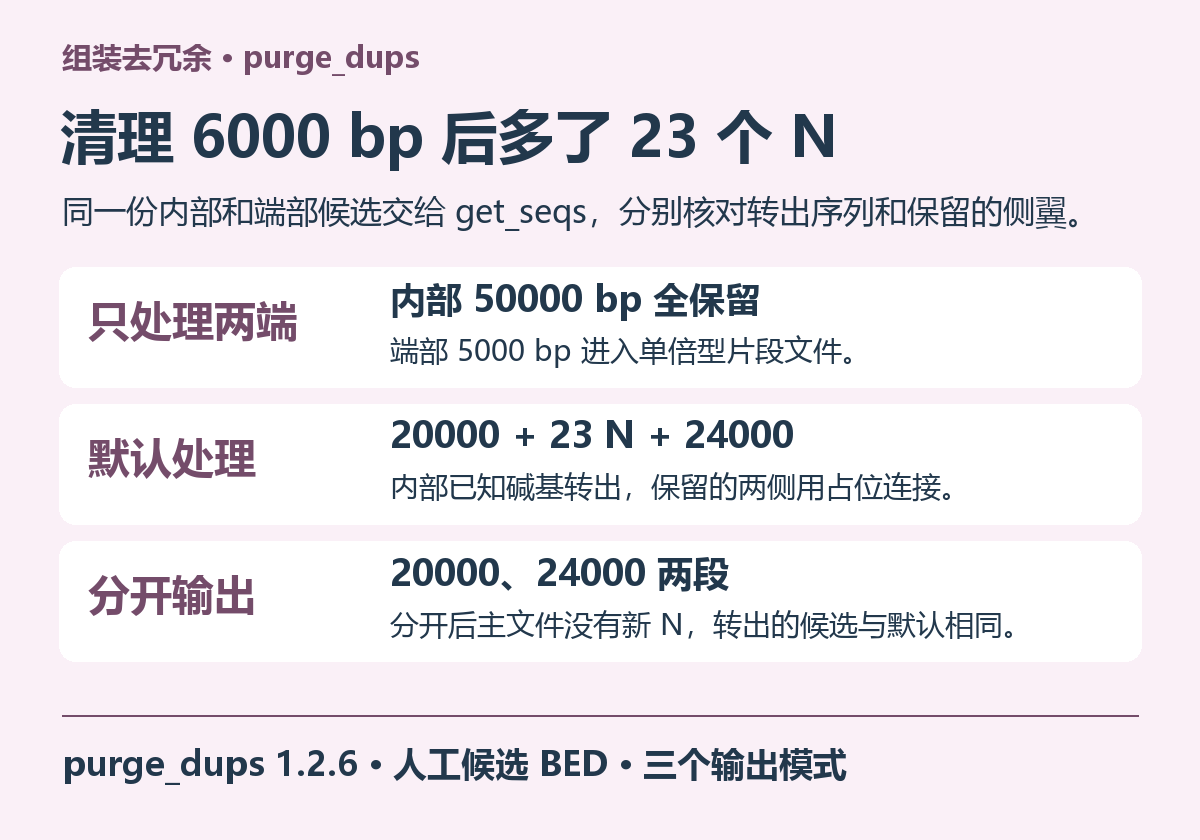
在批量统计时,不必先把所有序列头改成统一形式。对两套结果分别建立按输入片段名索引的表,将草图中的实际碱基、转出部分的实际碱基、输出中新加入的未知字符分别列出。当原始草图也含有缺口时,还应单列原有未知字符,避免将它们误算成这次新添的占位。把每条记录各自结清,再做样本汇总,可以防止一条多算、另一条少算在总数上刚好抵消。
第三条无候选对照也需要做完整比对。它在不同模式下即使被加上名称后缀,实际碱基仍应逐字一致。若这一步不成立,先核对 BED 的染色体命名与 FASTA 版本,排除把上一轮组装的坐标拿到这一轮处理的可能,再去解释保留或转出的生物学意义。
实跑经验|在 BED、主序列和转出文件之间做平衡表
get_seqs -e -p ends calls.bed primary.fa
get_seqs -p joined calls.bed primary.fa
get_seqs -s -p split calls.bed primary.fa
samtools faidx joined.purged.fa
samtools faidx joined.hap.fa
分开输出的运行把内部候选两侧变成两条独立的主记录,两段长度准确相加为四万四千,里面没有新 N。转出文件里仍是同一对候选,分别为六千和五千,逐碱基与原 BED 完全一致。因此默认和分开两种方式对被删已知序列的判断相同,对下游怎样表达两侧连接的处理不同。若下游算法把一条 FASTA 记录当作不可再分割的连续单位,则应使用实际输出的片段及缺口定义来说明断点如何表示。盲目去掉所有 N 后再拼接序列,会在没有额外证据的情况下制造一个直接连接。
迁移基因坐标时可挑一个靠近边界的字母验算。原第一条上一基二万六千零一,是候选之后第一个保留碱基。默认结果中它应排在两万个左侧碱基和二十三个 N 之后,即第一条的新二万零二十四位。分开输出时它却是右片段的第一位。若使用旧版注释按原坐标查询新版 FASTA,即使同名基因仍在,也会在错误位置读取序列。这次不同模式连部件名称的后缀都可能改变,因此转换表应保存版号、原名、原始区间、新名、在新序列中的区间以及方向。
实际决定某个内部候选是否应该清理时,回到支持它的生物学数据。单倍型重复表示、近期基因家族扩增、多倍体的同源区域都可能产生相近比对。检查原始读段在区域两侧的覆盖与跨越支持,也可以结合亲本标记与拷贝数证据。批量操作前先取含端部、内部、无候选的三条做复查,确认序列保留方法符合项目想交付的坐标系统,再把同一组规则用于全量组装。
若需要为多个版本保留原始自比对、深度、候选区间和主序列的坐标关系,可了解云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)