
同一份基因型文件,同时分析两个性状,为什么结果表中的样本数不一样?第一步已经成功生成预测文件,为什么第二步仍然可能遗漏样本或位点?这类问题往往发生在模型正式计算之前,却会直接影响结果能否解释。
本文实际运行 REGENIE 4.1.3.1,使用四百个人工样本、两个数量性状和两条人工染色体,核对两阶段衔接、缺失处理、低内存模式及次要等位基因计数过滤。所有输入由固定种子的脚本生成,不是真实队列。我们检查的是参数行为和文件关系,不用这些人工关联结果评价软件检出能力。
一、把两阶段的职责分开理解
第一阶段从一组基因型中拟合背景预测,第二阶段把相应预测用于逐位点关联检验。理解这两个职责后,才能解释为什么第一阶段的位点集合可以比第二阶段更小,也能理解为什么预测文件不是随便找一个已有文件就能复用。
本次设计两百个常见变异,每条染色体各一百个,作为第一阶段的输入。在第二阶段,额外加入一个只有两个替代等位基因拷贝的变异,以及一个完全单态的变异。这样可以直接观察“参与背景拟合”与“作为候选位点进入检验”两个集合的差别,而不用从大量真实数据里猜测过滤原因。
第一个数量性状包含预先加入的基因型效应、年龄效应和随机扰动,第二个性状使用另一组生成规则。设置强信号只是为了让结果容易辨认,它不代表真实遗传效应大小。数据没有模拟复杂群体结构、家系、测量批次或表型选择偏差,不能据此宣称模型已经控制了这些因素。
运行器固定容器摘要,限制为两核和四吉字节内存,并保存每条命令的退出状态及输出。完整输入生成、调用和核验过程见实跑复现包。这些资源限制只是本次实验条件,不是大型队列的配置推荐。
python3 run.py ./regenie_practice
二、第一步结束后,要检查预测文件的内容
第一步使用两百个位点、每块五十个位点,因此日志列出四个基因型块。这里的块大小描述计算组织方式,不是每次只分析五十个样本,也不是只保留五十个关联结果。把不同维度混在一起,是阅读批处理日志时常见的误解。
两个性状各生成一份预测文件,另有一个清单把性状名与文件路径对应起来。本次每份预测文件包含三百九十九个样本标识,随后是二十三行按染色体编号组织的预测值。虽然人工输入只含两条染色体,文件仍采用这套输出结构,因此不能把预测文件行数直接解释为实际输入染色体数。
留一条染色体的预测用于避免待检验区域参与同一背景预测造成的近端影响。第二步在检验一号染色体时,读取对应的一号染色体预测行。它不是对所有位点都使用一个完全相同的全基因组评分,也不能把用于其他用途的多基因评分文件直接当作这个预测文件。
检查衔接时,应同时核对性状名、样本标识、染色体编号和清单中的路径。文件能打开只说明路径存在,不说明它属于当前性状、当前样本集合或当前协变量设置。尤其在重复分析许多性状时,容易出现旧预测文件名称相似、实际模型已经变化的情况。
regenie --step 1 --bed toy \
  --extract model.snps \
  --phenoFile phenotypes.txt \
  --covarFile covariates.txt --covarCol age \
  --qt --bsize 50 --threads 2 --seed 183 \
  --out step1
本例使用同一套表型和协变量定义贯穿两步。若正式研究改了样本纳入条件、协变量或性状变换,应重新判断第一阶段能否复用,而不能仅因基因型没有变化就默认有效。文件格式与两步输入约定可查官方选项说明。
三、为什么四百个样本最后变成了三种人数
我们刻意安排三类缺失。最后一个样本缺少年龄,第一性状有另外八个样本缺失,第二性状有另外十个样本缺失,两个表型缺失集合互不重叠。这样每一处人数变化都能用简单算术核对,而不是只接受软件给出的总数。
由于年龄是本次模型中的协变量,缺少年龄的样本先被排除,进入分析候选集合的是三百九十九人。第一阶段处理数量性状时可以对缺失表型进行均值填补,因此预测文件中的人数不等于每个性状实际有测量值的人数。
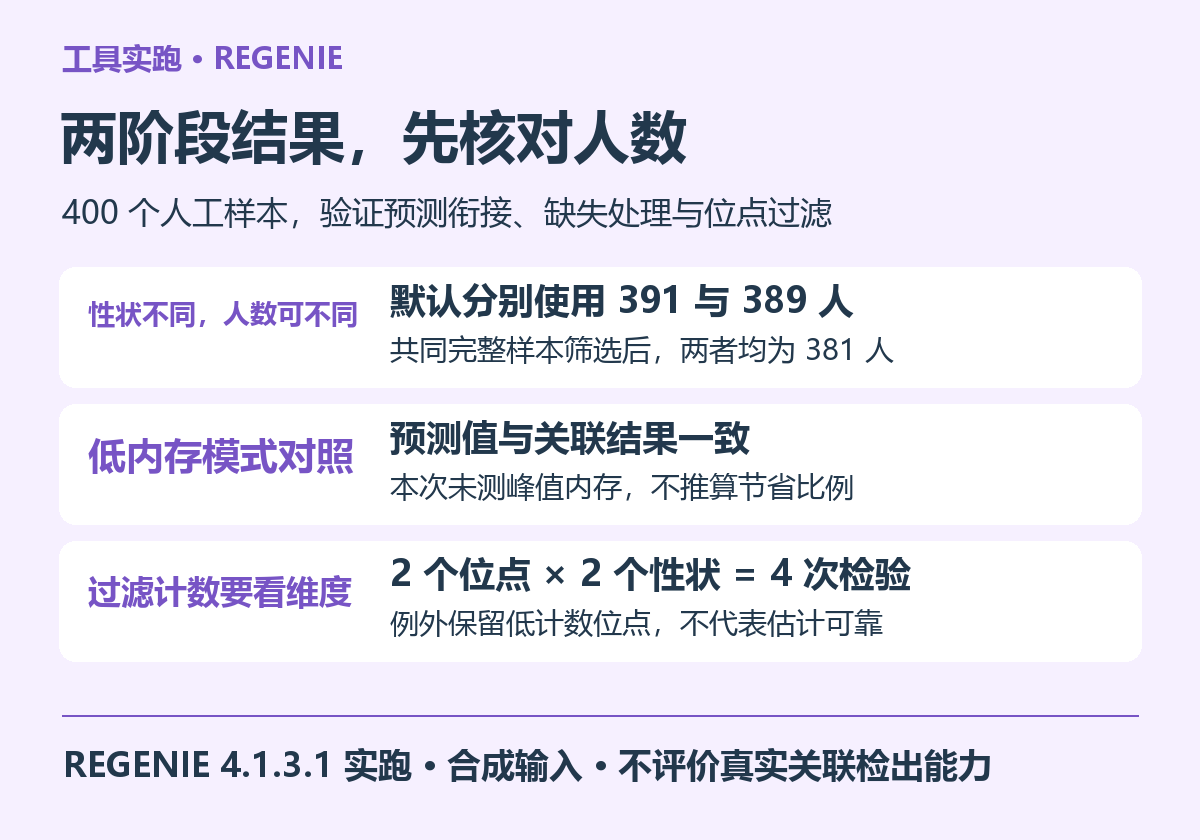
第二步默认按性状排除缺失表型,第一性状实际三百九十一人,第二性状三百八十九人。两张结果表的基因型来源相同,但有效观测集合不同,因此同一个变异的频率也可能出现轻微差异。这不是凭频率差一点就能断定的导入错误,需要先比较参与统计的个体。
| 对照 | 第一性状人数 | 第二性状人数 | 每个性状的输出位点 |
|---|---|---|---|
| 默认两阶段分析 | 391 | 389 | 200 |
| 低内存模式拟合后检验 | 391 | 389 | 200 |
| 表型行顺序完全倒转 | 391 | 389 | 200 |
| 两步都使用 strict | 381 | 381 | 200 |
| 仅第二步检验一号染色体 | 391 | 389 | 100 |
| 指定低计数变异例外保留 | 391 | 389 | 201 |
把两步都改为严格完整样本筛选后,任一性状缺失的样本都被排除,两种性状均剩三百八十一人。这个选择改变了研究使用的样本集合,不只是让两张表看起来整齐。对表型缺失较多的项目,是否使用共同完整样本,应由比较目的和缺失机制决定。
如果需要比较不同性状的效应,建议同时保存各性状样本列表、缺失原因与人数统计。共同样本分析可以减少一类集合差异,但也可能丢掉许多本来可用的观察值。默认方式和共同样本方式各回答略有不同的问题,不能把其中一个当作无条件更严谨的选项。
四、倒转表型行顺序,验证身份匹配而非行号匹配
本次协变量表本来就采用倒序排列,另一次第二步又把表型表完全倒序。实际输出与默认结果逐字段一致,表明这里依靠家系编号与个体编号匹配,文件行号不承担样本身份的作用。
这个对照值得放进分析前的小检查。若只是把表型按某种顺序排列,却没有检查编号唯一性,重复编号或命名规则变化仍然可能留下问题。编号的前导零、分隔符和家系字段也不能在转换过程中随意丢掉。
但倒序结果一致并不能证明所有样本标签都真实无误。把两名个体的编号一起贴错,程序仍可能完成一致的匹配。软件匹配检查解决的是数据文件之间的关系,样本采集与实验登记中的身份错误还需要原始记录核验。
第二步增加写出样本标识的选项后,可以把实际分析名单与预期名单比较。读者应优先找出被排除的具体样本及原因,再判断总人数是否合理。只看到分析人数接近预期,就跳过名单核对,容易漏掉“删错一个、又多进一个”这样的抵消情况。
五、低内存模式改变存放方式,不等于改变统计目标
我们分别用默认模式与低内存模式重新完成第一阶段。后者把中间预测写到指定临时前缀。本次两个性状的预测文件数值最大绝对差都为零,第二步关联结果也逐字段一致。这给出了一个可复核的对照,而不是仅凭选项名称推断结果应该相同。
regenie --step 1 --bed toy \
  --extract model.snps \
  --phenoFile phenotypes.txt \
  --covarFile covariates.txt --covarCol age \
  --qt --bsize 50 --threads 2 --seed 183 \
  --lowmem --lowmem-prefix temporary \
  --out step1_lowmem
本实验没有测量内存峰值,也没有比较大规模运行速度,因此不能从输出一致推出节省了多少内存,或承诺运行一定更快。把中间数据落盘可能改变存储需求与读写开销,正式项目应在有代表性的任务上测量。
临时前缀还应与任务对应,避免多个并发作业写到相同文件名。保存最终预测清单和必要日志即可支持结果追踪,不必把每次临时文件都当作永久成果。但清理之前应确认第一阶段已成功完成,第二阶段所需文件并不是准备删除的对象。
本次固定了随机种子与线程数,便于比较计算组织方式。跨版本、跨数学库或不同平台出现末位浮点差异时,应采用事先约定的容差与结果键比较,而不是要求日志耗时、路径和所有文本字节都完全相同。
六、结果少了两个位点,先查计数门槛
第二步读取二百零二个位点,但默认每个性状只输出二百行。额外加入的低计数变异有两个替代等位基因拷贝,单态变异没有次要等位基因,两者都未达到本次默认次要等位基因计数五的门槛。
日志报告四个因低计数忽略的检验,因为两个被过滤位点分别对应两个性状。这里统计的是检验次数,不是四个不同位点。多性状分析中,若把检验数、位点数和样本数混用,过滤记录很容易看起来对不上。
我们进一步使用例外保留列表指定那个计数为二的变异。它进入第二步结果后,每个性状的输出增加到二百零一行,而单态位点仍不在结果中。这验证了该列表与计数门槛的组合行为,也说明“被软件跳过”与“位点不存在于输入”是不同问题。
这项对照不意味着应当放宽稀有变异门槛来获取更多结果。极低计数时,少数个体对估计有很大影响,还需要核查基因型质量、携带者分布及适用的检验方法。某个位点能被强制纳入,并不自动使其效应估计稳定或统计近似可靠。
七、读结果时,把效应、样本数与显著性放在一起
第一性状中,预设强信号位点的效应等位基因为 G,效应约二点〇三,标准误约零点一四三,分析人数三百九十一。第二性状同一位点的效应接近零,人数三百八十九。两种输出符合人工生成方式,但只说明实验按预期工作。
结果字段中的对数显著性是负十进制对数形式,不能当作原始概率直接使用。例如第一性状该位点的数值约四十五点一八,对应的概率应按十的负该数值次方换算。制作图或汇总结果前,必须确认列的含义,不能因为名字里带有字母 P 就套用相同转换。
效应方向也应结合被计数等位基因阅读。本例输出区分参考编码与效应编码,跨文件合并时应保留这两列。仅按变异编号拼接效应值,可能在等位基因顺序变化后把方向读反。
REGENIE 的优势是把多性状背景拟合和逐位点检验组织成可重复的流程,第一阶段成果可在适用条件一致时服务于第二阶段分批任务。相应代价是需要维护更多中间文件关系,不能只保留最终结果表而丢失预测来源、样本筛选与参数记录。
八、从这个实验带走一套检查顺序
开始正式计算前,先确定性状类型及编码,再核对编号、缺失值表示和协变量。第一步完成后检查预测清单与样本集合,第二步完成后核对实际人数、候选位点数、被跳过检验数及输出字段。每一步都应有可回溯的文件,而不是只看最后有没有报错。
对于病例对照、稀有变异集合或生存性状,不能把本文的数量性状命令原样套用。校正方法、缺失处理和结果含义都需要按任务重新确认。本次没有运行这些分支,因此也没有把它们描述成已完成验证的能力。
当两阶段文件关系、样本筛选和检验设置都已核清,需要扩展到更多性状与队列时,可了解云生信生物信息学分析环境与算力服务,在保留版本和复现记录的基础上开展批量分析。


