
一段质控代码运行成功,调用比例从六分之五变成百分之百,能否说明这个位点已经没有缺失?同一个数据对象里,另一个质控字段却显示六分之四,这两组数字为什么能够同时存在?在 Hail 中,理解数据的行、列与条目,以及过滤对聚合范围的影响,比记住几个函数名更重要。
本文实际运行 Hail 0.2.140,用三个变异、六个样本组成的人工文件,检查条目过滤、基因型设为缺失、样本筛选、多等位基因拆分、外部表连接与检查点读取。每个结果都能从少量输入中复算,不使用真实队列,也不把本地运行描述成分布式性能测试。
一、先认清三种维度,才能判断一行代码改了什么
Hail 的矩阵表可以同时保存变异层面的行信息、样本层面的列信息,以及变异与样本交叉位置上的条目信息。基因型、深度和基因型质量通常位于条目里,位点坐标属于行,样本编号属于列。三个维度不能互换。
本次导入后的形状为三行六列,共十八个条目位置。一个基因型字段缺失,并不等于这个条目不存在,条目中的深度或质量字段仍可能有值。相反,执行条目过滤会使对应位置不再参与通常的条目聚合,而行和列本身可以继续保留。
第一个位点有五个已调用基因型和一个缺失,其中一个杂合基因型的质量只有五,其余已调用样本质量为六十。第二个位点的六个基因型都有调用,但质量全部为五。第三个位点有两个替代等位基因,并保留一名质量字段有值、基因型却缺失的样本。
这样安排,是为了分别观察低质量、缺失值以及整行条目被过滤的情形。它们不代表真实测序质量分布,二十这个质量门槛也只是实验中的对照设置,不是针对所有测序平台的推荐标准。
二、先固定环境,再运行可以逐项核验的小输入
此次实际环境为 Python 3.12.16、Java 21 与 Spark 4.1.2,Hail 版本带有固定构建标识。运行器固定官方镜像摘要及镜像配置摘要,使用本地两个计算线程,容器限制两核和四吉字节内存。
安装时遇到镜像下载停滞,我们对公开镜像各层及解压内容逐项核验摘要后载入相同环境,没有修改分析软件。这个过程也提醒读者,下载是否完整、依赖是否匹配、代码逻辑是否正确是三个不同问题,应先判断失败发生在哪一层。
当前安装要求应以官方 Linux 安装说明为准,不能直接沿用旧教程中的 Java 版本。本文的实跑复现包包含输入生成器、分析程序和实际结果,在可运行 Docker 的 Linux 环境可执行下面的调用。
python3 run.py ./hail_practice
这里使用本地 Spark,仅证明这套小实验可以运行。大规模数据还涉及分区、任务调度、数据落盘和中间表大小,不能根据十八个条目在小环境中跑通,就推断几十万样本项目的时间或内存需求。
三、过滤条目与把基因型设为缺失,结果结构不同
对第一个位点,我们分别执行两种操作。第一种保留质量至少二十的条目,第二种保留全部条目,只把未达到门槛的基因型改成缺失。两种操作最终都有四个有效基因型,替代等位基因拷贝数为三,总已调用等位基因数为八。
filtered = mt.filter_entries(mt.GQ >= 20)
filtered = hl.variant_qc(filtered, name="qc_after")

missing = mt.annotate_entries(
    GT=hl.or_missing(mt.GQ >= 20, mt.GT)
)
missing = hl.variant_qc(missing, name="qc_after")
但第一种方式在该位点只剩四个参与聚合的条目,第二种仍有六个,只是其中两个基因型缺失。对全部三个变异而言,前者的条目表共有十行,后者仍有十八行。两者的矩阵形状却都保持三行六列。
这种差别会影响后续汇总。例如计算基因型质量平均值、统计已调用比例或构造长表时,使用条目过滤后的对象,相当于先缩小了参与统计的位置集合。仅把基因型设为缺失,则可能保留其他条目字段供追踪,二者的用途不同。
第一个位点中原本质量缺失的样本也没有被保留在过滤结果里。判断条件本身为缺失时,不能自动当成通过条件。如果研究需要对“质量未知”采用另一套处理方式,应把规则写清楚,并安排能触发该情形的检查输入。
四、百分之百与六分之四,都可能是正确计算
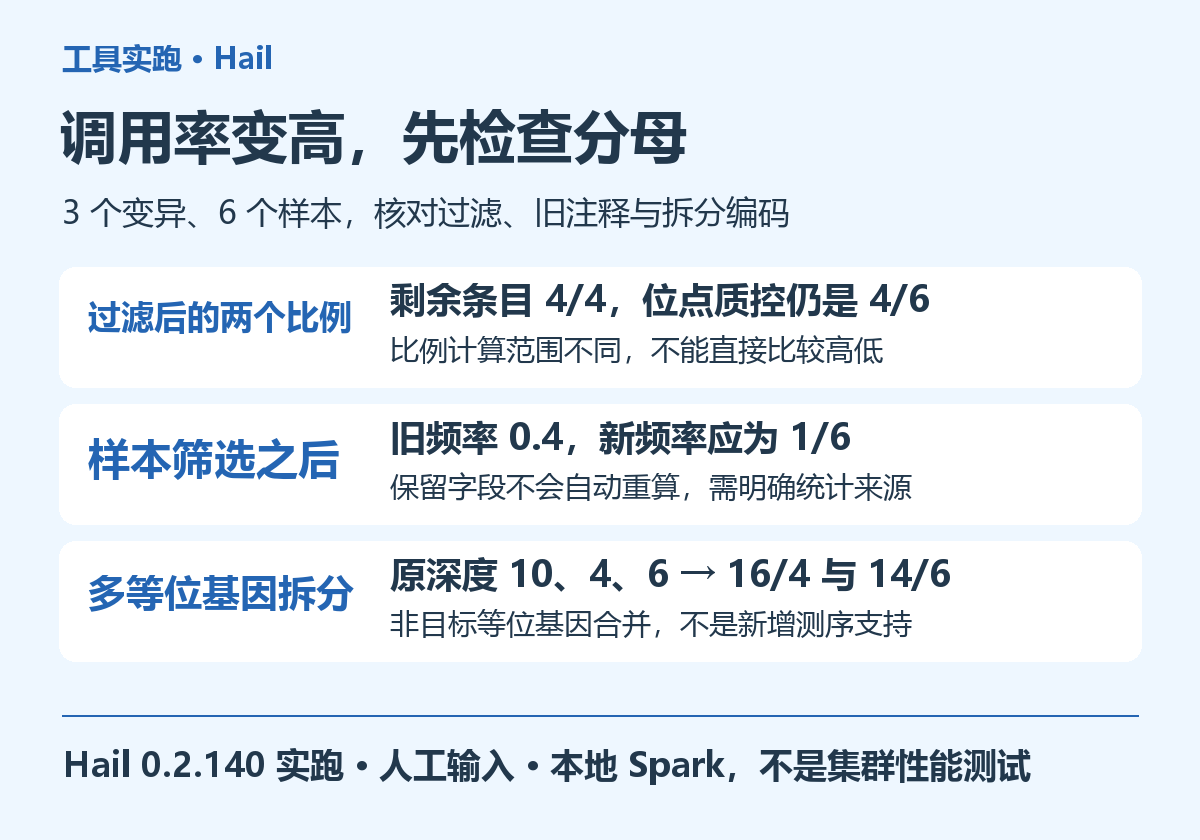
对过滤后的第一个位点,直接聚合“基因型是否有定义”的比例,得到一。原因是参与该聚合的四个条目恰好都有基因型,计算的是四除以四。这个数字描述剩余条目内部的完整程度,没有把已经被过滤的两个位置纳入分母。
与此同时,重新运行位点质控得到的调用率为四除以六,约零点六六七。质控结果还明确列出四个已调用、零个未调用、两个被过滤。它记录了原有样本列中哪些位置失去了可用调用,回答的是另一种问题。
| 第一个位点的处理 | 聚合条目数 | 已调用 | 未调用 | 被过滤 | 位点质控调用率 |
|---|---|---|---|---|---|
| 过滤低质量条目 | 4 | 4 | 0 | 2 | 4/6 |
| 只把基因型设为缺失 | 6 | 4 | 2 | 0 | 4/6 |
因此,不能看到百分之百就直接宣称位点质量改善。先问这个比例的分母包含谁,再问它是否对应研究需要的质量定义。把不同聚合范围的比例放在同一张图中比较,还应给出清楚的说明,否则图形上“更好”的结果可能只是丢掉了更多位置。
在实际项目里,建议同时保留调用数、未调用数、过滤数以及参与聚合的位置数。单独保存一个比例,往往无法在事后重建分母。相关行为可结合矩阵表过滤说明和实际输出核对。
五、一整行都被过滤,并不会自动删除这个位点
第二个位点的所有质量值都低于门槛,因此六个条目全部被过滤。它仍然作为一行存在于矩阵中,矩阵形状没有少一行。该位点的聚合条目数为零,调用数为零,被过滤数为六,位点质控调用率为零。
此时对剩余条目计算已调用比例,没有有效分母,结果为缺失。它不应该被写成百分之百,也不能简单当作一个与其他位点同样可比较的零。缺失和零具有不同含义,填表或绘图时应保持这种区分。
如果研究希望移除没有任何有效调用的位点,需要另行定义行筛选规则。条目筛选和行筛选处理的是不同层次,不能因为前一步“过滤过”就默认所有空位点已经离开数据集。
我们还运行了恢复过滤位置的操作,条目表重新变成十八行,但原来被过滤位置的字段以缺失值恢复,原始低质量调用没有因此回来。第一个位点仍只有四个有效调用。这不是撤销历史操作,真正需要回到原始状态时,应读取原始对象或之前保存的检查点。
六、改变样本集合后,旧质控注释不会自动更新
原始第一个位点有五个已调用的二倍体基因型,总等位基因数为十,替代等位基因频率为零点四。我们去掉第二和第三个样本后,剩四列,其中三个有调用,总等位基因数为六,替代等位基因只有一个,正确的新频率为六分之一。
但先前保存的质控注释仍记录十个等位基因和零点四频率,直到再次执行质控计算才得到新数值。这不是软件偷偷保留了被删除的样本,而是原先算好的行字段仍附在行上,不会因为列筛选自动重算。
subset = mt.filter_cols((mt.s != "S2") & (mt.s != "S3"))
subset = hl.variant_qc(subset, name="qc_subset")
这个问题不只影响官方质控字段,也影响自己添加的聚合结果。本次恢复过滤位置后,之前存储的聚合条目数字仍然是四,尽管恢复后的条目结构已经有六个位置。旧字段记录的是过去那一次计算,不能把它当作当前对象的即时状态。
比较不同人群、病例对照子集或质控前后数据时,应明确哪些统计是全体样本上的背景注释,哪些是当前子集重新计算的统计。前者可以有用途,但命名必须清楚。把两个含义不同的频率都命名成“频率”,再依赖读者猜测上下文,很容易造成错误筛选。
七、多等位基因拆分,会改变标准字段的编码
第三个位点原本有参考 A 和两个替代等位基因 C、G。第一个样本的基因型为一比二,深度字段为二十,三个等位基因深度依次为十、四、六。拆分后生成 A/C 与 A/G 两行,整个数据的行数从三变为四,样本数仍是六。
在 A/C 行中,该样本变成零比一,等位基因深度为十六和四。在 A/G 行中,也变成零比一,等位基因深度为十四和六。两个拆分结果的总深度都是二十,不能把它们相加后宣称原始测序支持增加了一倍。
这里的零编码要结合拆分后的二分类表示理解,其他等位基因被归入非目标一侧。因此 A/C 行里的十六并不意味着原始数据中有十六条只支持 A 的读段,它合并了原先参考与另一个替代等位基因的深度。
拆分函数会处理相应的标准基因型字段,但并不意味着任意自定义行注释都能自动理解并重写。本次保留的旧质控字段仍带有原始三等位基因数组,而重新计算的拆分质控字段才对应两等位基因。下游若直接读取旧数组第二项,很可能选中了错误的统计对象。
处理拆分结果时,应保留原始位点、原始替代等位基因索引及拆分标记,再确认新统计的计算范围。官方遗传分析方法说明可帮助核对标准字段规则,本例没有测试复杂插入缺失、星号等位基因或其他特殊记录。
八、表连接依靠键,检查点帮助固定可解释的中间状态
最后,我们导入一张样本顺序完全倒转、并缺少第六个样本的外部表。按样本编号作为键进行连接后,第一个样本得到正确数值十一,第六个样本的值为缺失,样本列数仍然保持六。未匹配到注释不等于样本自动被删除。
连接后应核对匹配人数、未匹配编号和键是否唯一。不要把缺失注释默认补成零,因为零可能是一个有实际意义的表型值,也不要仅靠文件排序来判断谁对应谁。需要删除未匹配样本时,应额外写出明确筛选规则。
我们将拆分结果重新分为两个分区并写入检查点,再读取该矩阵,形状仍为四行六列,行内容与写入前一致。这个检查固定了一个能够继续使用的中间结果,但不证明任意未来版本都兼容,也不说明分区越多就会越快。
Hail 的优势是把复杂基因型数据与按键注释、聚合及持久化放在统一的数据模型中。相应的学习成本在于,表达式作用的维度、过滤后参与统计的范围和旧注释的来源都必须清楚。小数据先核对分母和字段,再扩展到大数据,通常比在最终结果表里追查这些问题更容易。
当质控分母、样本集合和拆分注释已经核清,需要扩展到更大队列时,可了解云生信生物信息学分析环境与算力服务,在保存可追溯检查点的基础上规划批量计算。


