
把十二条属于同一家族的序列交给 RepeatModeler 的 Refiner,得到一条长三百二十个碱基、内部逐碱基都正确的共识。这个结果听起来足够漂亮,问题是我们预先知道家族原型长四百八十个碱基,左右两端各少了八十个。更有意思的是,十二条中即使放回一条完整拷贝,程序给出的共识仍然只有三百二十个碱基。这个对照适合回答整理新物种重复序列库时一个很实际的问题,什么时候应该结束整理,什么时候还值得回到组装寻找更完整的家族成员?
家族、拷贝和边界各是什么
一个转座元件家族可以在基因组中留下许多拷贝。时间、突变、删除和后续插入会让它们成为长短不同的亲属。家族共识把多条同源序列中相互支持的信息合成一条代表序列,方便之后到整份组装上找其他成员。它不一定与某个位点上实际存在的一条序列完全相同。要复核它,至少要同时保留代表序列、用于建立这条序列的多序列比对,以及这些拷贝来自基因组哪个位置。单独拿到一条带家族名称的序列,无法判断最后几十个碱基有多少独立位置支持。
RepeatModeler 的从头发现流程会提出候选家族,再对这些家族的拷贝进行整理。Refiner 接收已经归在一起的拷贝,先借助两两比对寻找合适的代表,再由多条序列的比对更新共识。本文实际运行了家族整理这一步。我们特意先把拷贝身份确定下来,这样长度变化就能归到末端证据的差别。若直接比较两次整套从头发现的输出,家族分群、随机采样、相似家族合并等环节也可能改变结果,反而难以回答边界这个具体问题。RepeatModeler2 方法论文 · Refiner 的输入与处理说明
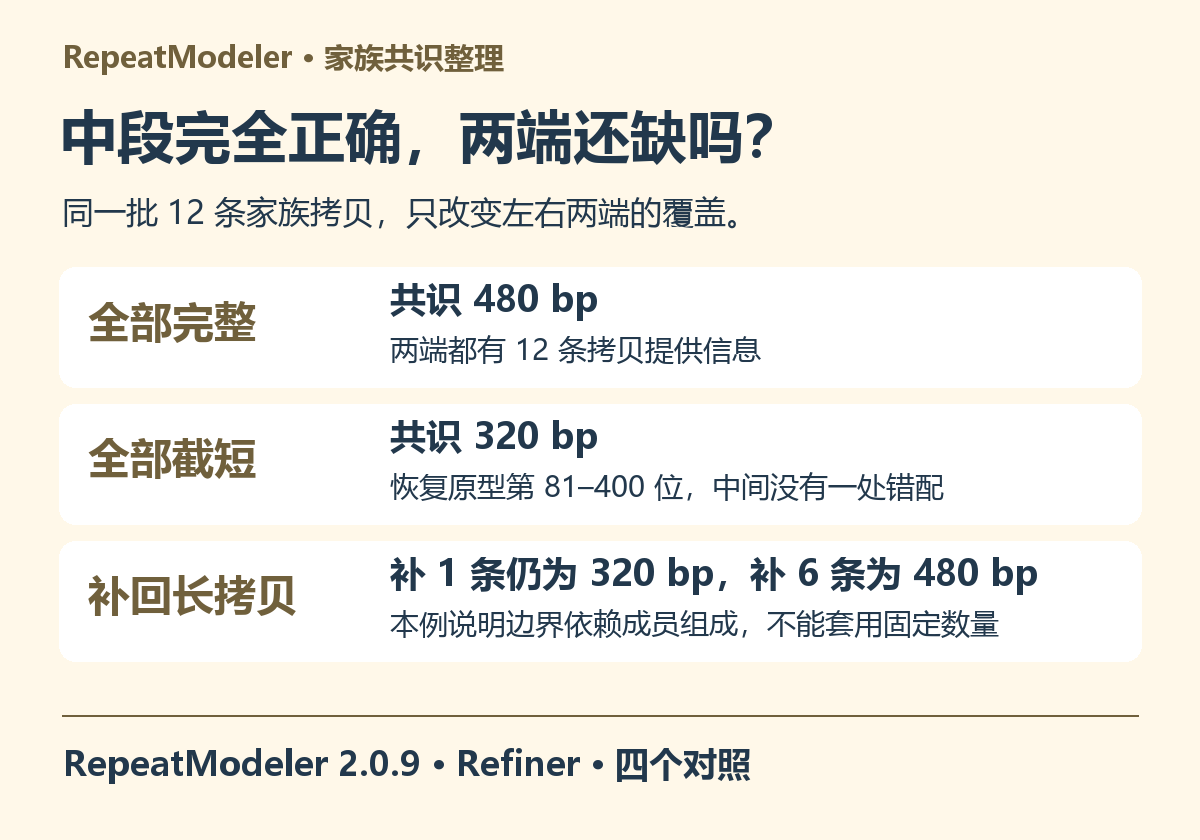
实跑经验 · 同样十二条拷贝,只有末端覆盖不同
我们生成一条四百八十个碱基的人工原型,为每个拷贝独立选择二十四个位置做替换,得到十二条相近但不相同的序列。每个拷贝的替换位置只在本拷贝内不重复,不同拷贝可以碰巧在同一位置发生改变。四份输入都从这同一批序列复制,改动仅限于是否保留原型的头八十个和尾八十个碱基。也就是说,中部用了哪十二条成员、这些成员各自有什么替换,在四种条件下完全一样。人工原型在运行时没有交给软件,只有在评价输出时才重新拿出来核对。
使用 RepeatModeler 2.0.9 的 Refiner,配合报告版本为 2.17.1+ 的 RMBlast,四次均用一个线程。软件会输出共识及种子比对,后者保留每个成员在比对中的位置。复核时把每条共识分别按正向和反向互补和原始设计比对,寻找差异最少的连续区间。这个实验只引入了替换与两端裁切,因此用不含内部缺口的比对便可以验算。如果真实材料还存在内部插入或缺失,应改用能容纳缺口的比对,记录错配和缺口分别出现在什么位置。复现实验的输入生成脚本和预期结果
python3 094-repeatmodeler/run.py /path/to/RepeatModeler/Refiner results
# 在四个条件的输出目录分别检查这两个文件
head -n 2 results/one_full/copies.fa.refiner_cons
head -n 12 results/one_full/copies.fa.refiner.stk
| 完整拷贝 | 仅有中段的拷贝 | 共识长度 | 在原型上覆盖的范围 | 覆盖区内错配 |
|---|---|---|---|---|
| 12 | 0 | 480 | 1–480 | 0 |
| 0 | 12 | 320 | 81–400 | 0 |
| 6 | 6 | 480 | 1–480 | 0 |
| 1 | 11 | 320 | 81–400 | 0 |
四个结果里,所有成功覆盖的位置都与人工原型完全一致。如果质量表只登记平均一致性或错配数,四行都能拿满分。表中真正决定能否继续用于全长搜索的是另一列,恢复的覆盖范围。既然中段在每种条件下都有十二个拷贝,得到相同的中段是可以理解的。两端在四种条件下却分别有十二、零、六、一条输入提供资料。即使有一条拷贝延伸到末端,本次算法与输入组合仍然只报告中段。这项观察可以用来提醒审阅者检查两端的独立支持,不能用来给所有物种规定一个固定的最少拷贝数。
用一个真实位点的工作方法读种子比对
拿到候选共识后,先沿代表序列按位置统计,有几条拷贝在该列给出有效碱基。内部一段可能有十几条重合,越往两端参与的条数越少。然后把这些拷贝起止位置画在同一坐标尺上。一个常见的形状是大多数拷贝都在相似位置结束,只有一条在右边伸出很长一段。此时应该回到这条拷贝的基因组邻域,观察那段伸出部分是否在别的独立位点也能找到。若它只属于当前插入位置周围的宿主序列,贸然把它写进家族库,会让普通基因组序列在下游也被错误命中。
对四份人工数据,可以先做一个不用任何专业软件的核对。给每份输入列出各序列长度,再按位置统计覆盖深度。全长加中段那一组的中央三百二十个位置都能得到十二条序列的信息,两侧各八十个位置只有六条。单个全长那一组的中央支持数相同,但两端各只有一个观察。单看总记录条数,两组都是十二,单看中段一致性,两组也相同。读到这里就可以预先解释,下一步取证应该优先寻找另一个带边界的插入位置。继续加入十条只含中央区域的碎片,会让中段显得更稳,却不会新增末端的直接观测。
数“独立位点”时不要只按 FASTA 标题数行。同一个长拷贝可能因不同搜索命中被截取了两次,又可能同时出现在主组装和保留的替代单倍型上。两段序列都很像、两端也一样,未必是两个独立插入事件。可将成员映射回原组装,比较两侧一段宿主区域的序列、邻近基因和相对位置。如果重复的只是元件内部而两端侧翼明显不同,独立插入的解释更可信。若连两侧非重复序列都成段相同,就值得先核实是否重复取样或分相冗余,再决定把它们算作多少条支持。
怎样查明“短共识”到底少在哪里
把短共识重新定位到一组较长候选上。若多个候选的同一端都还能向外延伸,延伸段之间也能互相比对,再提取邻域扩大边界,若共有序列在不同位点都到相近坐标结束,边界外立刻进入彼此不同的宿主序列,则当前末端有较好的位置依据。一开始不要把窗口定得过大。可先在两端增加一个足以辨别边界的短窗口,查看相邻区是否已经变得无关,再决定是否继续延伸。保存每个成员的方向,必要时先统一为家族方向,否则左端和右端的证据会被混在一起。
有些短模型其实来自另一个问题。一个较大的元件内部又插入了另一个元件,中央的强比对会把两边本来相关的侧段隔开。另一些情况下,两个不同家族共享较短的保守功能区域,软件可能只整合了双方都有的部分。区分这两种情况可以挑几条长且彼此独立的基因组实例,以共识核心作为锚点,分别比较左右两侧。如果两端分成持续稳定、彼此不同的几组,而核心几乎一样,可以试着分组重做种子比对。若核心两侧在多处独立插入都呈现相同排列,却只被个别新插入打断,则可把断点记录下来,再重新评估两端能否连成同一家族。
对于长末端重复元件或带末端倒置重复的元件,结构特征能提供另一条线索。先明确自己期待看到哪种末端结构,以及该结构必须以何种方向成对出现,然后检查多个候选位点,连同附近的靶位点重复一并记录。遇到仅有中央片段的候选时,这些标记可能根本没有落在输入范围内。此时可以先把它作为有中段同源证据的候选保留。把家族类别和边界置信度写成两栏有实际价值,即使内部蛋白结构域支持某种类别,完整边界仍可能需要后续补证。
还可以为这类整理留一个简单的稳定性检查。从成员表中轮流去掉某一条特别长的序列,再看共识是否在同一端明显缩短。若只有去掉某条成员才导致末端丢失,说明该处结论很依赖一个具体位点,应当优先检查那条序列及其邻域。若若干套互不重叠的成员子集都恢复相同边界,证据更分散。抽取子集时尽量按基因组位置分组,避免把同一个插入的重叠片段分别放入两份样本。每次保留成员名单和种子比对,日后更新组装时才能区分边界变化来自拷贝组成,还是来自新版本修复了断裂的序列。这种验证比只保存一个长短数字多花不了多少时间,却直接回答了结论依赖哪条证据。
从共识回到整份组装,再决定是否入库
整理完成后,用旧共识和新共识分别搜索同一份组装。比较相同位置新增或消失的覆盖碱基,单列新出现的位点,查看它们是否集中在低复杂度区、保守蛋白区域或某一批高度相似的组装片段。若较长版本主要把原来短命中的两端补齐,而且在许多不同位置重复发生,延长有较明确的应用收益。若额外命中大量只包含伸出尾部的短片段,而这些片段附近没有成员核心,就要检查是否错误收纳了常见宿主序列。比较时固定搜索程序、评分条件和输入组装,才能把差异解释为库版本变化。
一个容易实践的交付格式是让每个家族拥有一份简短记录。写下共识长度、从多少个独立位置取了成员、中央与两端分别有多少条支持、哪些位置靠近组装缺口、两侧能否找到共享边界,以及整理前后在基因组上新增了哪些覆盖。对本例中一条完整配十一条截短的条件,我会留下那条长拷贝的坐标供继续寻找相似侧翼,暂用可重复恢复的三百二十碱基作为已支持部分。若后来找到更多独立的长实例,重新运行同一个脚本并比较两端的变化,就能知道新增证据究竟解决了什么。
若还想判断短共识会怎样影响重复含量,不要把少掉的一百六十个碱基直接乘以全基因组命中条数。许多真实拷贝本身可能已经截短,有的末端可能被嵌套插入打断,有的与另一个家族的注释重叠。更稳妥的量是两套库各自在相同组装上产生的区间并集,算清新增长度后再对位点分类。这一步既给出了实际影响,也能把“家族代表定义是否合理”和“有多少组装碱基因此改变了标记”这两个研究问题分开作答。
对照方案确定后,如果要在多个大型植物组装上反复做家族整理和回搜,可以凭一组已核验的拷贝与命中规模向云生信生物分析服务器团队评估整批任务。


