
用近缘基因组将碎片化组装挂载到染色体后,结果表里多出几千个碱基,容易被写成“恢复了缺失序列”。判断是否真的找回序列,可以做一个很直观的检查,把 FASTA 拆成已知碱基和未知碱基两部分,再问多出来的全是什么。我们在参考上事先留出七千五百碱基的间距,用 RagTag 挂载同样的两个片段,二者的排列方向完全一致,只改一个参数就使 scaffold 增长七千四百。多出来的位置每一个都是 N。RagTag scaffold 官方说明
在参考上挖一个知道长度的缺口
生成一条长十四万碱基的参考。截取零基区间五千到五万五千作为左片段,长五万。另取六万二千五百到十二万五千作为右片段,长六万二千五百。两个片段相距七千五百,位于两端之外的参考序列也没有加入查询。故意将右片段写成反向互补,以便检验挂载过程有没有识别方向。最后再给查询加入一个全新生成的二万八千碱基片段,它在参考上找不到对应位置,用来观察“未挂载”到底是被丢弃、附在末尾,还是另行保留。
两轮都运行 RagTag 2.1.1,底层使用同一版 minimap2 和相同查询。使用给未放置片段添加后缀的选项,保证输入部件名与新挂载名易于区分。第一轮采用默认间隔,第二轮要求软件根据参考比对推断间距。目标是由查询本身的碱基组成一份挂载结果,因此参考的已知序列只提供排序、方向和间距的依据。若有人希望把参考碱基作为额外信息填入缺口,那已经是另一项需明确记录来源的操作,不能从“参考指导挂载完成”几个字推断发生了这一步。RagTag 项目与工具范围
AGP 的序列行和间隔行各讲一件事
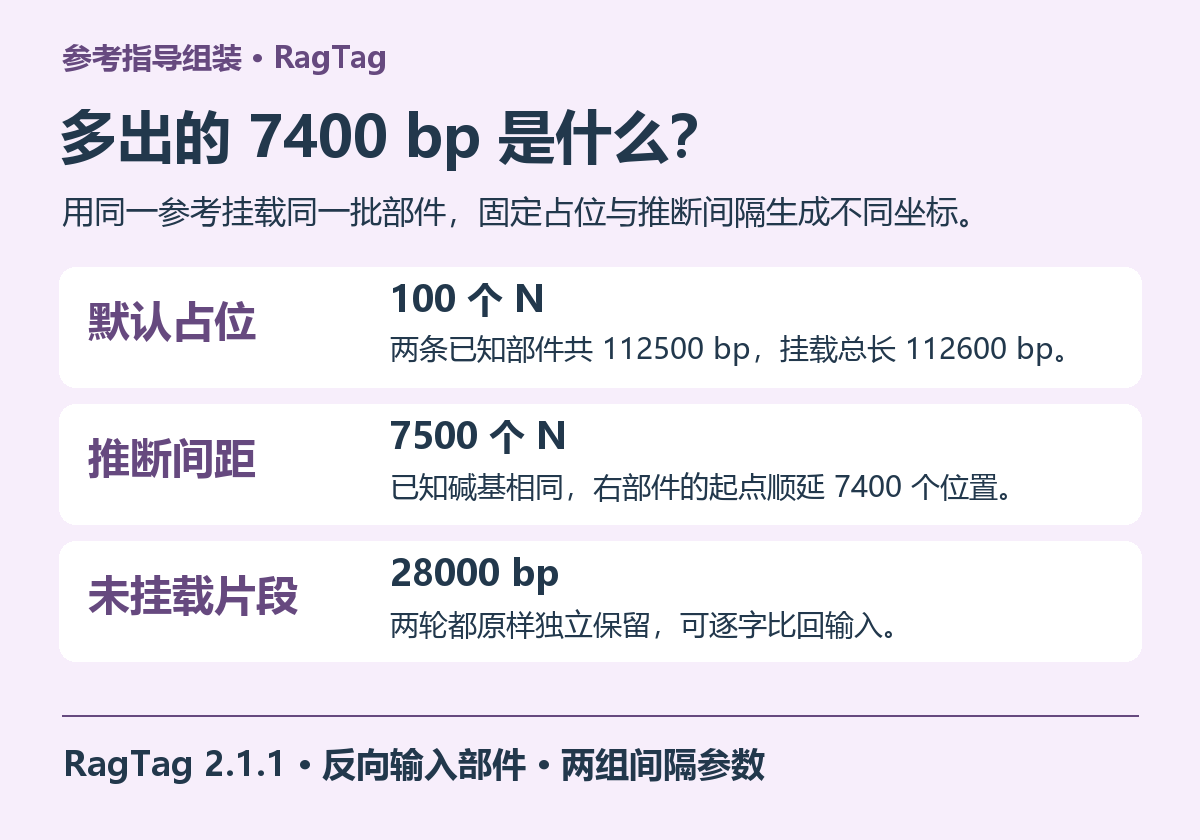
默认运行把左片段放在首位,方向为正,右片段放在第二个序列位置,方向为负。由于输入时右端人为反转,最终 FASTA 的右侧正好逐字等于原参考对应区间。两个部件本身加起来是十一万二千五百个已知碱基。默认在它们之间插入一百个 N,总长十一万二千六百。AGP 中表示这段间隔的类型是 U,表示长度未知,标准占位值为一百。只看 FASTA,无法知道这里的一百是实验测量值还是约定值,查看 AGP 能把这两类来源区分开。
第二轮的两条序列行仍使用相同部件、相同方向和相同部件坐标。间隔改成七千五百个 N,间隔类型变成 N,挂载总长变成十二万。这一改变使右片段在新坐标中的起点从一基的五万零一百零一移动到五万七千五百零一,差值正好七千四百。换句话说,同一条右侧基因在这两版 scaffold 上可以有两个不同坐标,即使它周围的实际碱基逐字相同。比较两次注释时,应该先通过部件映射对齐坐标,再去怀疑基因是否发生了结构改变。NCBI 对 AGP 间隔行的定义
| 运行方式 | 输入部件贡献 | 间隔未知碱基 | 挂载全长 | 右部件起点,一基 |
|---|---|---|---|---|
| 默认 | 112500 bp | 100 个 N | 112600 bp | 50101 |
| 根据参考推断间隔 | 112500 bp | 7500 个 N | 120000 bp | 57501 |
还可以用一个不在缺口附近的位点做坐标验算。选右侧输入片段倒数第一个碱基,它在反向互补之后会成为右部件的第一个碱基,所以应分别落在两份挂载的两个起点。再选输入的第一个碱基,它应落到对应部件的末端。两端都经过这个测试,能同时检出坐标起点少一位及遗漏链向翻转两种常见错误。对负链的基因、引物和探针重新定位时,可以先用这个简单案例校准转换脚本。
实跑经验|从输出文件直接验证每个字段
ragtag.py scaffold -t 2 -u -o fixed_gap ref.fa query.fa
ragtag.py scaffold -t 2 -u -r -o inferred_gap ref.fa query.fa
awk -F '\t' '$5=="U" || $5=="N"{print $1,$2,$3,$5,$6}' inferred_gap/ragtag.scaffold.agp
samtools faidx inferred_gap/ragtag.scaffold.fasta
先用 AGP 的挂载端点反算每段所占长度,一基闭区间需要末位减起点再加一。再在 FASTA 中实际统计 N 数。最后取左右两段具体序列,第一段按原向、第二段按反向互补与输入比对。四个数字应该一致,即两个输入部件长度、间隔长度以及三者之和。更完整的复查还包括未挂载条目。我们在两轮结果中都找到了长度仍为二万八千、序列与输入完全一样的独立条目。它没有被硬接到参考染色体末端,也没有仅因为缺乏参考证据就从交付物中消失。
要是没有外部已知模板,能做的检查仍然不少。看每个查询被挂到哪条染色体,是否有一大段与另一条染色体竞争,是否只有一小段高度重复的序列承担全部定位证据。一个与参考确实存在倒位或易位的样本,也可能在参考指导下得到看似很顺的排序。因此对打算发表的新倒位、新易位或断点附近的基因结构,保留原始 contig 和自身长读段支持比只检查参考上的一致性更重要。推断间隔长度本身是基于参考几何关系得到的估计,跨物种、复杂重复或两种单倍型结构不同都会使它偏离目标分子的真实距离。
报告中可以把挂载率拆成两个分母。一个用输入部件的总碱基数,回答有多少原始序列被放到命名染色体上。另一个直接统计包含未知间隔的输出总长度,描述最终坐标系统有多长。本例前者的分子在两轮都是十一万二千五百,未挂载的二万八千也不变。只有后一个数发生变化。如果下游要统计每兆碱基的基因或变异密度,需再明确分母是否含这七千五百个无法观测具体字母的位置。
当多个品系需要在同一参考框架下挂载并保留原始部件和坐标映射时,可使用云生信的生物信息分析服务器管理和复核各个版本。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)