
假设你在一个样本中发现一段三百六十碱基的缺失,另外两份单样本变异表在同一位置都是空白。现在要计算这段缺失在队列中的频率,能直接把三个人都放进分母吗?我们模拟了三个有已知真值的样本,实际安装 Sniffles2,分别运行单样本发现和多样本联合分析。两个单样本文件看起来一样安静,把它们的局部覆盖带进联合分型后,能支持的判断却完全不同。Sniffles2 官方工作流程
空白行漏掉的那部分信息
长读长结构变异分析先从比对中寻找支持插入、缺失或其他事件的读段,再把同一事件附近的证据聚起来。单样本变异文件通常只记录通过相应条件的事件。一个位置没有记录,可能因为有足够读段按参考序列顺利跨过,也可能因为这个样本在断点附近没有可用的读段。直接合并各样本的文本行,只能知道别处有人报出了这个位置,无法补回原先文件省略的局部覆盖情况。
Sniffles2 在单样本发现时可以另外写一个 SNF 文件,供联合分析读取候选和覆盖等信息。计划做队列时,第一次调用就同时保存这个文件和常规变异表。对照要使用同一参考版本、相容的染色体命名与样本编号。若只留下一个经筛选的变异表,到补样本时才发现没有该位置的背景证据,即使把坐标完全对齐,也没法凭空判断谁能可靠分型。作者的多样本模式与输入说明
实跑经验|只让一个样本在断点处没有读段
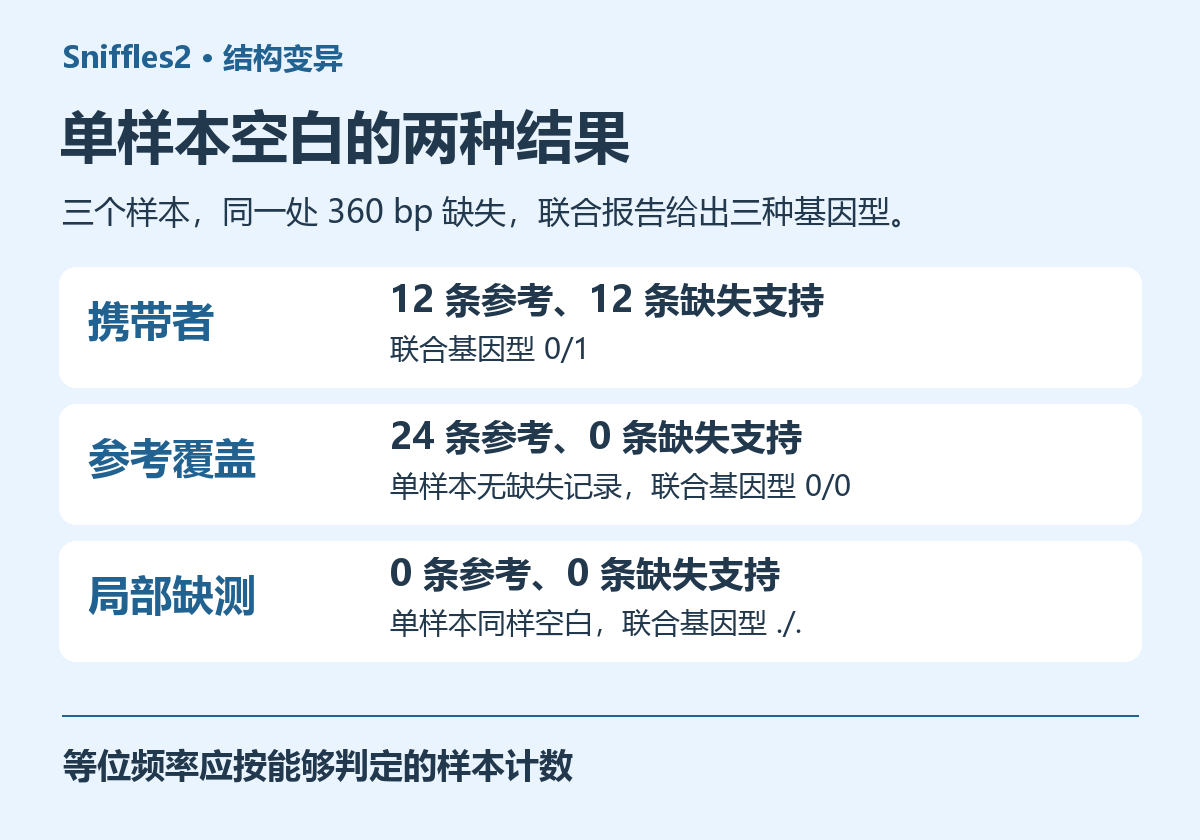
实验用十二万碱基的人工参考。在携带者中造出二十四条跨过目标位置的高质量比对,十二条带相同的三百六十碱基缺失,另外十二条保留参考序列。第二个样本同样给二十四条跨越读段,全部为参考型。第三个样本只在染色体另一段放入读段,目标处的跨越数为零。三个样本在远处都有读段,因而最后一个样本依然是一份可正常读取和索引的比对文件。实际运行版本为 2.2,单样本最少支持读段数明确设为四。
| 样本 | 跨过完整断点区的读段 | 单样本缺失记录 | 联合 GT | 联合 DR / DV |
|---|---|---|---|---|
| 携带者 | 24 | 1 | 0/1 | 12 / 12 |
| 有参考支持 | 24 | 0 | 0/0 | 24 / 0 |
| 目标区没有覆盖 | 0 | 0 | ./. | 0 / 0 |
四次调用产生一条队列事件,类型为缺失,长度栏为负三百六十。携带者的基因型质量为六十,另外两人的质量栏在这个版本的联合输出里都是零。由此可见,在这份输出上单看质量栏,恰好分不开有参考支持和没有覆盖的样本。读这一行要把基因型、两类支持读段以及局部覆盖放到一起。本例用人工安排的无噪声比对,使参考支持栏恰好吻合手工计数。真实联合结果中有些参考支持来自覆盖估计,不能把每个数都解作逐条人工查看过的独立分子。
多算一个进入分母的人,频率会变多少
本例按二倍体常染色体计算。两个有基因型的样本合计提供四个可以计数的等位,其中一个为缺失,示例等位频率是四分之一。如果把第三个样本的缺失基因型补为参考,分母会变为六,频率也会变成六分之一。若改为报告携带者比例,应写两个可判定个体中一人携带,并注明共分析三人。给频率同时写上分子、可调用的分母和缺失数,读者可以快速发现这几种统计口径是否被混用了。
# 三个 BAM 均已按坐标排序并建立索引,使用相同参考
for s in carrier reference gap; do
  sniffles --input "$s.bam" --sample-id "$s" --reference ref.fa \
    --vcf "$s.vcf" --snf "$s.snf" --minsupport 4 --threads 1
done
sniffles --input carrier.snf reference.snf gap.snf --vcf cohort.vcf --threads 1
bcftools query -f '%CHROM\t%POS\t%INFO/SVLEN[\t%GT:%DR:%DV]\n' cohort.vcf
遇到真实样本的空白,先从联合记录提取断点和事件长度,再打开两侧比对,分别看读段是否锚定到唯一位置、是否有人从两端跨过、缺失读段的起止点是否聚在同一段。特别长的缺失和短缺失产生的表现不同,有的证据写在一条读段的比对操作串里,有的分布在补充比对中。只在一个断点数所有重叠读段,可能把只在一侧停下的分子也算作跨越支持。文章表中的跨越数,是在已知真值上独立检查越过两个边界的人工读段得到的。
如果还打算做病例和对照的比较,可以为每个目标断点另列一张可判定样本表。保存样本总数、参考型数、携带者数和未定数,逐行核对参考型、携带者、未定三类之和是否与总数相符。随研究纳入新样本时沿用这套统计,把分母的变化和真实新增的携带者分别说明。
扩到队列前的核对顺序
先选一小段已知有阳性、又有局部低覆盖的候选区域,用该批次正式的参考和软件版本从头保存两类输出。把样本在联合表中的列名与输入文件逐一核实,确认携带者的支持关系仍然可追溯。再按样本汇总可判定位点比例,特意抽取测序深度低的一批与常规样本对照,观察缺失值是否集中在某些样本、测序批次或重复区域。若某个表型组恰好更多样本测得浅,直接把无调用处理成参考,连组间比较的方向都可能受影响。
最后要确认任务是发现新事件,还是对外部给定的断点集合重新分型。前者可以从多人的候选证据联合汇总,后者在软件中另有指定输入变异表的分型方式。已知断点的坐标约定、等位表示和参考序列应先核对。本实验覆盖的是三个样本的发现与联合流程,没有估计真实队列的检出率,也无法代表低比例嵌合样本。要回答这些问题,需要已知真值、不同支持比例和符合研究材料的测序噪声一起进入对照。官方指定已知位点分型说明
下载本篇实验脚本与结果(12 篇合集 ZIP),解压后打开 078-sniffles2 目录。
样本分批到齐、需要用同一参考持续做联合分析时,可以在云生信的生物信息分析服务器保留每个样本的 SNF 文件与覆盖核对记录。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)