
扩增子双端分析中,截掉低质量尾部往往能够提高过滤通过率。但如果只观察过滤后的读段数量,可能选出一组最终无法合并的参数。前后两个方向分别通过质量检查,并不保证它们仍然拥有足够的重叠区域。
本文实际运行 DADA2 1.38.0,使用软件包自带的两个配对 FASTQ 示例。我们完成过滤、错误率学习、去冗余、去噪、双端合并和去嵌合体检查,并比较两组截断长度与两个合并重叠门槛。每一步的保留数量和候选合并记录都保存下来,便于解释读段在哪个环节减少。
为什么要把质量和重叠长度一起考虑
双端读段来自同一个扩增子两端。经过方向转换后,如果二者覆盖范围重叠,就可以在重叠区核对序列并尝试拼接。截短会减少低质量位置,也会缩短可用于重叠的部分。
对于没有额外复杂变化的片段,可以先用前向保留长度加反向保留长度,再减去目标片段长度,估算可能的重叠范围。这个估算适合在正式处理前排除明显不可行的组合,实际接受与否还要看比对和错配条件。
DADA2 的标准流程先分别处理两个方向,再合并对应的推断序列。官方教程也要求输入保持正确的样本对应、配对顺序以及适当的前处理状态。官方流程教程
本次重点检查截断与合并的关系。两个输入文件中的样本只是软件包示例,我们没有为它们补充未经验证的实验分组或来源背景,也没有使用这些小数据推断真实群落差异。
本次环境与输入怎样固定
实验环境中 R 的版本为 4.5.2,DADA2 为 1.38.0。软件随本次安装的官方 QIIME 2 发行环境提供,我们直接调用其 R 包函数完成分析,实际版本通过程序读取并保存。
输入来自 DADA2 安装目录的示例文件,每个样本包含前向和反向各一个压缩 FASTQ。每个样本实际读入一千五百对读段。下载包记录了四个输入文件的校验值,因此复现时可以确认是否使用了相同文件。
library(dada2)
packageVersion("dada2")

example <- system.file("extdata", package="dada2")
samples <- c("sam1", "sam2")
fwd <- file.path(example, paste0(samples, "F.fastq.gz"))
rev <- file.path(example, paste0(samples, "R.fastq.gz"))
dir.create("filtered", showWarnings=FALSE)
filtF <- file.path("filtered", paste0(samples, "F.fq.gz"))
filtR <- file.path("filtered", paste0(samples, "R.fq.gz"))
示例文件适合检查操作和结果关系。正式项目中的错误率模型需要结合实际测序批次、读段质量与足够数据评估。本次数据量很小,后文讨论的是这些输入下的实际行为,没有把它当作生产分析的质量基准。DADA2 项目与安装资料
第一组保留前向二百四十、反向一百六十碱基
第一组将前向读段截到二百四十、反向截到一百六十。两个方向的最大期望错误数都设为二,不允许未知碱基,其他主要过滤条件按代码固定。
filtered <- filterAndTrim(
  fwd, filtF, rev, filtR,
  truncLen=c(240, 160),
  maxN=0,
  maxEE=c(2, 2),
  truncQ=2,
  rm.phix=TRUE,
  compress=TRUE,
  multithread=FALSE
)
实际过滤后,样本一保留一千零二十一对,样本二保留一千零九对。这里的数量是配对过滤后保留的对数,需要按两个方向配套理解,不能把前后向文件中的记录数再相加当作样本的独立片段数。
最大期望错误数与平均质量也不是同一个量。质量分数经过转换后对应错误概率,将读段各位置的错误概率相加,能够形成期望错误数。更长的读段可能积累更多低质量位置,因此截断长度与这一过滤条件会共同影响通过数量。
排查自己的数据时,可以保留每个样本的输入量、过滤量及保留比例,再结合质量图选择候选截断组合。此时得到的是进入后续分析的候选输入,最终能保留多少片段还需要继续往下检查。
错误率学习和去噪在本例中怎样运行
我们用第一组过滤后的两个样本分别学习前向和反向错误率,再保存两个模型。随后对两个方向分别去冗余,并实际调用去噪函数。
errF <- learnErrors(
  filtF, nbases=1000000,
  multithread=2, randomize=FALSE
)
errR <- learnErrors(
  filtR, nbases=1000000,
  multithread=2, randomize=FALSE
)

derepF <- derepFastq(filtF)
derepR <- derepFastq(filtR)
dadaF <- dada(derepF, err=errF, multithread=2)
dadaR <- dada(derepR, err=errR, multithread=2)
实际去噪后,样本一前向保留一千零一十七个读段,反向保留一千零二十一个。样本二前向保留一千零五个,反向保留一千零六个。这些是两个方向各自的结果,下一步还要依据原始配对关系连接。
为了集中观察截断与合并的变化,后面的较短截断组继续使用本次学习并保存的同一组错误率模型。这样可以明确本例哪些条件变化了,哪些条件保持固定。正式项目是否重新学习模型,需要根据实际数据组织和分析方案决定。
将模型文件和去噪结果一起保存,还能帮助复查一个参数对照是否混入了其他变化。若每次同时改变过滤、学习数据和合并门槛,就难以解释最终差异主要来自哪里。
正常重叠门槛下,实际合并了多少读段
第一组采用十二个碱基的最小重叠,允许的重叠区错配数为零,并保留被拒绝的候选记录。
mergers <- mergePairs(
  dadaF, derepF, dadaR, derepR,
  minOverlap=12,
  maxMismatch=0,
  returnRejects=TRUE,
  verbose=TRUE
)
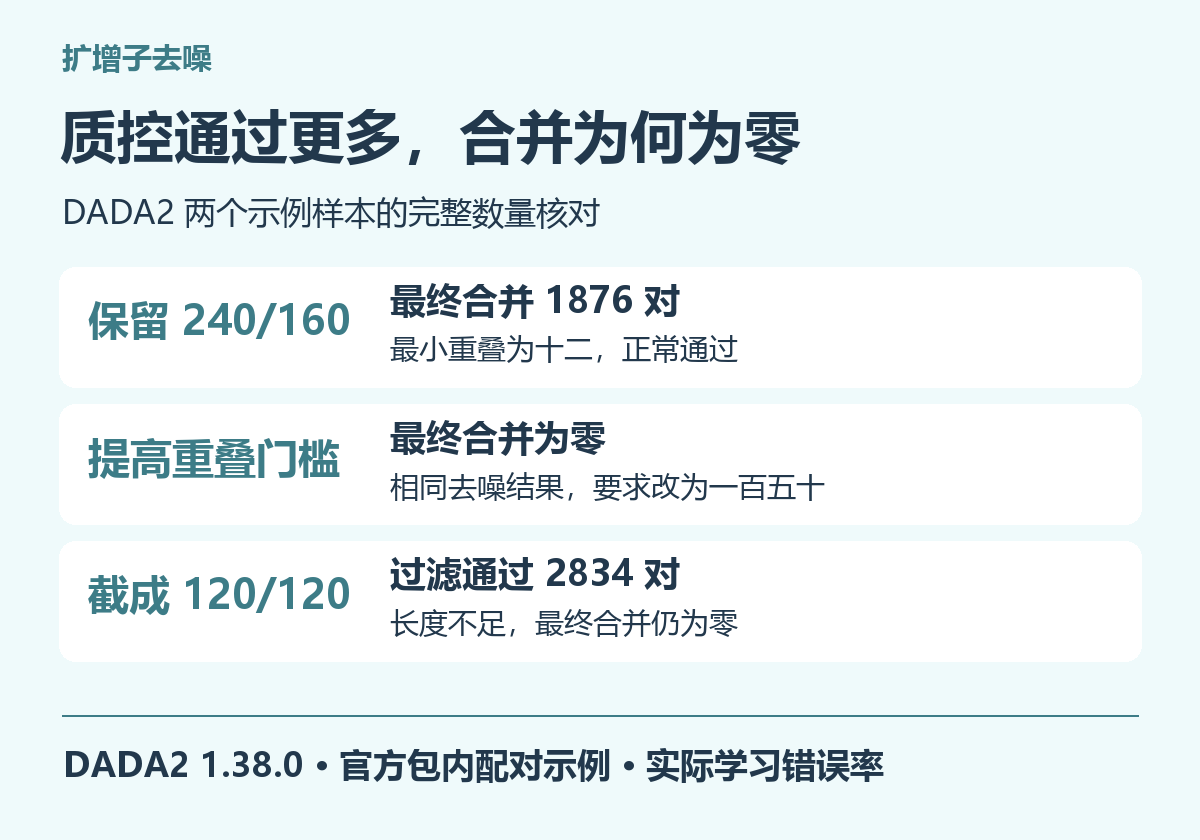
实际合并后,样本一保留九百六十五对,样本二保留九百一十一对。合并序列表共得到八个不同序列,后续去嵌合体步骤没有从这八个序列中检出需要移除的对象,因此两份样本的最终计数保持不变。
大部分接受序列的长度为二百五十三,另有一个二百五十二碱基的序列。对于二百五十三碱基的片段,前向二百四十加反向一百六十,再减去二百五十三,得到一百四十七碱基的重叠估算。
候选合并表里,多个实际接受记录的匹配数正好为一百四十七,错配和插入缺失数均为零。这让截断长度、最终序列长度与实际合并证据相互对应起来。
只提高重叠门槛,也能让全部合并失败
接下来保持第一组过滤和去噪结果不变,只将最小重叠要求提高到一百五十。实际合并数在两个样本中都变成零。
前面具有一百四十七个匹配位置的主要候选仍然存在,序列内容也没有变化,只是无法达到新的重叠条件。二百五十二碱基片段对应的长度关系同样低于这一门槛。
这组对照说明,即使读段质量与去噪结果都相同,合并阶段的要求本身也足以改变最终保留量。因此,发现合并数大幅下降时,应查看实际使用的合并参数和候选记录,再决定是否需要返回前面的步骤。
设置更严格的门槛可以表达不同的接受条件,但需要与目标片段长度相容。如果输入设计本来就无法提供所要求的重叠,提高门槛只会使这些候选被拒绝,无法凭空增加可用证据。
截到一百二十以后,过滤更多、合并却为零
第二组将两个方向都截到一百二十碱基,最大期望错误等过滤条件与前面保持一致。实际过滤通过量明显上升,样本一保留一千四百一十八对,样本二保留一千四百一十六对。
去噪后的数量也较高。样本一前后向分别保留一千四百一十六和一千四百一十七,样本二分别保留一千四百零九和一千四百一十六。仅查看这些中间数量,短截断组似乎更有利。
但两个方向总共只有二百四十碱基,对主要的二百五十三碱基片段已经无法形成完整重叠。实际使用十二碱基最小重叠要求时,两份样本的合并数都为零,候选记录中的主要配对也没有匹配重叠。
| 条件 | 样本 | 过滤后对数 | 合并后对数 |
|---|---|---|---|
| 240/160,最小重叠 12 | sam1 | 1021 | 965 |
| 240/160,最小重叠 12 | sam2 | 1009 | 911 |
| 240/160,最小重叠 150 | sam1 | 1021 | 0 |
| 240/160,最小重叠 150 | sam2 | 1009 | 0 |
| 120/120,最小重叠 12 | sam1 | 1418 | 0 |
| 120/120,最小重叠 12 | sam2 | 1416 | 0 |
短截断组两样本合计通过过滤两千八百三十四对,长截断组合计两千零三十对,但最终能够使用的合并片段来自长截断组。这正是需要追踪全流程保留数量的原因。
被拒绝的候选表还可以告诉我们什么
本次保留了所有候选合并记录,读者可以同时检查丰度、前后向推断序列编号、匹配数、错配数、插入缺失数及是否接受。
例如,样本二在正常重叠门槛下,有一个丰度为五十七的候选,记录了一百四十六个匹配和一个错配。在本次零错配要求下,它被拒绝。这类记录能够帮助区分“重叠不足”与“重叠区不一致”。
如果只保存最终接受序列,就看不到这些失败原因。适当保存候选表,可以让分析者判断读段损失主要集中在哪一种情况,再决定是否需要检查配对、前处理或参数设置。
本次没有为了增加合并数量而修改错配允许值。真实项目是否调整这一条件,需要结合质量、错误模型以及研究设计判断,并记录改变后具体接纳了哪些候选。
还有一个容易忽略的操作细节。保留拒绝候选是为了诊断,但构建最终序列表时仍须只选用被接受的合并结果。本次驱动先按接受字段筛选,再调用建表和去嵌合体函数。若把调试用的全部候选直接当作正式结果,可能把失败记录带入后续统计,破坏前面建立的数量关系。
本次去嵌合体采用跨样本共识方式,结果没有移除序列。这只能描述当前两个小示例及当前参数下的输出,不能据此认定真实项目不存在嵌合体。正式数据应同时查看被移除的独特序列数与对应读段丰度,避免只报告一个总百分比。
另外,本次较短截断组没有可接受的合并结果,因此驱动明确记录空表并跳过依赖非空序列表的步骤。排查时应把这种情况识别为上游缺少可用输入,保留失败阶段的证据,而不是继续尝试分类注释,再把后续报错误认为数据库或注释软件故障。
换成自己的数据,先算哪几笔账
第一笔账是片段长度。整理引物、测序方向和前处理方式,明确用于估算的长度是否包含已经去除的部分。对于长度分布较宽的标记区域,应保留足够余量,不能只用一个平均长度代表全部片段。
第二笔账是每一步保留量。建议至少记录输入、过滤、前向去噪、反向去噪、合并及去嵌合体后的数量。若一个样本在某一步突然下降,可以优先检查该步骤的日志和中间表。
第三笔账是记录的计数单位。配对数量、单向读段数量和独特序列数量属于不同对象。本次八个不同序列承载了一千八百七十六个合并片段,不能把两者混为同一种保留率。
第四笔账是参数对照。可以先固定其他条件,只比较少量合理截断组合,再观察最终合并量和长度分布。这样比同时修改多个门槛更容易找到影响最大的因素。
DADA2 能够利用错误率模型推断扩增子序列变体,但整个流程仍需要适合输入的质量处理和配对合并条件。本次小实验的收获是把每一步与具体数量连接起来,让参数选择能够由输入长度和实际输出共同支持。
下载包提供完整驱动、软件包示例获取方式、输入校验值、学习模型的运行步骤以及三组候选合并记录,读者可以从原始示例重新执行并复算上述数量。下载实跑脚本与本次结果
当项目需要统一处理多个扩增子批次,并保存错误模型、参数对照及分析结果时,可了解云生信的生物信息学分析计算服务。


