
同一条环状染色体,只把 FASTA 的起点移到另一个位置,没有增加或删除任何碱基,为什么注释出的蛋白仍可能变化?关键在于软件如何理解序列两端。对于真实环状分子,文件末端与开头相邻,而普通线性序列的两端通常按边界处理。
本文实际运行 Bakta 1.12.2,使用公开大肠杆菌染色体完成四组对照,分别比较原始环状、旋转后环状、旋转后线性,以及允许部分基因的线性模式。我们追踪同一条目标蛋白的坐标、长度与校验值,判断变化来自输入说明还是碱基本身。
本次研究的是编码区,不是全部注释模块
输入为大肠杆菌 K-12 MG1655 的 NC_000913.3,长度为四百六十四万一千六百五十二碱基。本次使用完整染色体,不是截取片段,并在运行前核对序列长度与校验值。NCBI 参考序列
为了集中观察编码区和边界,本次明确跳过 RNA、CRISPR、短开放阅读框、缺口、复制起点和绘图等模块,保留 CDS 预测及相应功能处理。后文的数量均为这个运行范围内的 CDS 数,不能把它当作完整注释流程包含所有特征的总量。
这种范围限定也使四组结果能够比较。若一组跳过某类特征,另一组运行全部模块,再比较最终条目总数,会把运行范围差异混入拓扑问题。完整选项都写入复现脚本,没有在结果出来后临时删选某一组。
软件、主数据库和依赖数据库要分别记录
本次软件实际输出版本为 1.12.2,使用 BioContainers 固定版本镜像,主数据库为 Bakta 6.0 的 light 类型。镜像摘要、数据库元数据和下载归档校验值均保留在复现说明中。
BAKTA_IMAGE='quay.io/biocontainers/bakta:1.12.2--pyhdfd78af_0'
docker pull "$BAKTA_IMAGE"
docker run --rm "$BAKTA_IMAGE" bakta --version
轻量数据库与完整数据库不能混为一谈。它适合需要较小参考规模的场景,但蛋白注释所能使用的信息范围与完整库不同。本例记录的是轻量库结果,没有运行两种库的准确率对比,也没有据此声称轻量库对所有对象都足够。官方数据库类型与安装说明
安装过程中还有一个实际遇到的问题。我们最初给下载文件加上了版本后缀,但安装器据此推导的目录名与归档内的目录不一致,解压后无法定位数据库。将文件名恢复为 db-light.tar.xz 后,安装及依赖数据库更新成功。
bakta_db install -i db-light.tar.xz -o bakta-db
主库的版本文件列出建库时的依赖来源,但安装步骤还更新了 AMRFinderPlus 数据库。本次实际使用的依赖库版本为 2026-10-29.1,不能只照抄主库元数据中较早的日期。正式复现应保存运行时使用的依赖库版本和目录快照,避免后来更新参考却仍声称环境完全相同。
旋转序列时,碱基内容没有发生改变
驱动把原始序列的前一千零二个碱基移到末尾,新的第一位对应原始序列第一千零三位。操作没有丢弃任何碱基,也没有引入随机替换,长度和整体碱基组成保持一致。
可以把这一步理解为为同一个圆环选择不同的编号起点。两个线性字符串的校验值会不同,因为字符排列起点变了,但按已知旋转关系还原后,应得到完全相同的原始字符串。
cut = 1002
rotated = original[cut:] + original[:cut]
assert len(rotated) == len(original)
assert rotated[-cut:] + rotated[:-cut] == original
这个区别很重要。校验值不同只能说明文件或字符串内容不同,不能单独说明发生了生物学突变。对于环状序列,还需要考虑起点、方向和表示方式,建立明确的坐标对应关系后再解释差异。
如何告诉程序这是一条环状染色体
本次通过复制子说明表明确指定序列类型与拓扑。表中的原始编号必须与 FASTA 标题一致,否则不能把设置可靠地关联到目标序列。
printf 'EC_original\tEC_original\tchromosome\tcircular\t-\n' > original.tsv
printf 'EC_rotated\tEC_rotated\tchromosome\tcircular\t-\n' > rotated.tsv
实际 JSON 输出确认,两组环状运行的序列均被标为完整染色体和环状拓扑。两组线性运行没有提供这份拓扑说明,输出记录为非完整、线性的 contig。我们检查了程序理解后的元数据,没有只根据提交的命令猜测设置已经生效。
真实项目中,环状声明必须有组装或其他证据支持。不能为了让某个边界基因看起来更完整,就把普通草图 contig 一律设为环状。本次之所以能这样对照,是因为输入来自已知完整环状参考,并且旋转关系由脚本精确控制。
四组命令保持哪些条件相同
四组使用同一软件环境、同一数据库、相同线程数、相同输出命名规则,以及相同的模块跳过选项。下面的函数集中写出共同设置,随后只改变输入、拓扑表和部分基因选项。
annotate_cds() {
  bakta --db bakta-db/db-light --threads 2 \
    --prefix sample --locus-tag DEMO --keep-contig-headers \
    --skip-trna --skip-tmrna --skip-rrna \
    --skip-ncrna --skip-ncrna-region --skip-crispr \
    --skip-sorf --skip-gap --skip-ori --skip-plot "$@"
}
annotate_cds --output original_circular \
  --replicons original.tsv original.fna
annotate_cds --output rotated_circular \
  --replicons rotated.tsv rotated.fna
annotate_cds --output rotated_linear rotated.fna
annotate_cds --output rotated_linear_partial --partial rotated.fna
完整驱动还会生成输入文件、读取每组 JSON,并为所有输出蛋白计算校验值。读者可以直接运行下载包中的驱动,不需要手工改写上千条注释来完成比较。
| 运行条件 | CDS 数 | 完整目标蛋白 | 边界表现 |
|---|---|---|---|
| 原始起点,环状 | 4310 | 保留 | 目标位于内部 |
| 旋转起点,环状 | 4309 | 保留 | 一条跨边界 CDS |
| 旋转起点,线性 | 4309 | 未保留 | 较短内部起始预测 |
| 线性且允许部分基因 | 4310 | 未保留 | 两条边界片段 |
原始目标怎样定位
原始环状运行中,目标 CDS 位于三百三十七到二千七百九十九,正链,翻译蛋白长度为八百二十个氨基酸。输出产物名称为双功能天冬氨酸激酶与高丝氨酸脱氢酶相关蛋白,基因名字段为空。
这里没有强行为空的基因名补一个符号。功能产物描述、标准基因名和数据库交叉引用是不同字段,有产物名称并不要求每个字段都齐全。实际检查应保留这种区别,避免把整理表格时添加的名称误当成工具原始输出。
目标所在区间跨过我们选择的旋转切点,因此旋转后它的一部分出现在文件末尾,另一部分出现在开头。这正是用来检验拓扑说明能否帮助程序正确处理边界的情形。
环状结果中,起点大于终点不一定是错误
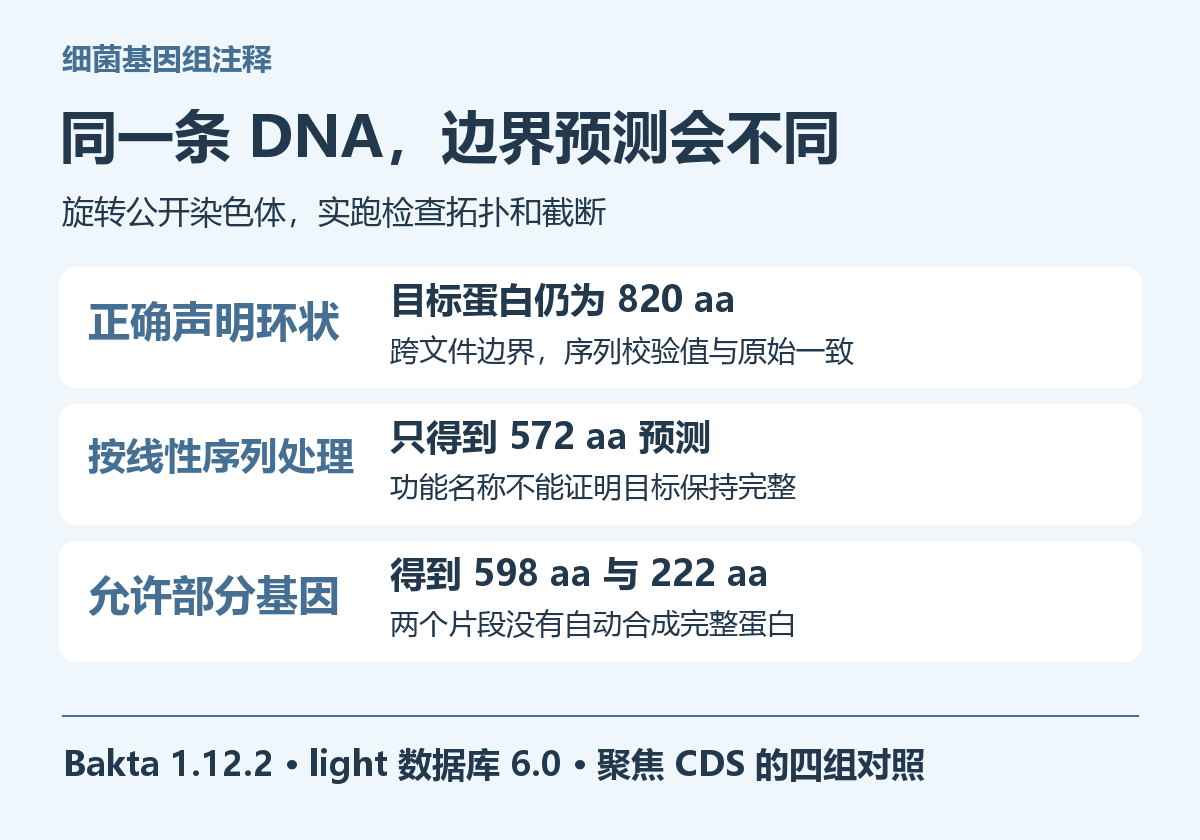
旋转后环状运行把目标记录为从 4,640,987 到 1,797,并带有跨边界标记。其蛋白仍为八百二十个氨基酸,序列校验值与原始目标完全相同。
这组坐标不能按普通线性区间直接计算终点减起点。应先取末尾部分,再接开头部分。末尾长度为六百六十六碱基,加开头的一千七百九十七碱基,共二千四百六十三碱基,与原始 CDS 长度相同。
如果把这条记录当成起止颠倒的数据错误,直接交换坐标或删除,就会破坏正确的跨边界表示。解析这类结果时,应同时读取拓扑、跨边界标记、方向和序列长度,并按相应格式规则提取核酸。
本次查看了固定版本中线性和环状预测的处理逻辑,确认两者对边界候选采用不同路径,但最终判断仍以实际坐标与蛋白序列核对为准。1.12.2 的 CDS 预测实现
按线性输入处理时,短了多少
旋转后线性运行没有输出与原始目标完全相同的蛋白。靠近文件开头的位置被预测为从七十九到一千七百九十七,蛋白长五百七十二个氨基酸,产物名称为天冬氨酸激酶相关描述。
这个结果说明,即使输出有一个看起来合理的功能名称,也不能据此认定目标保持完整。本次已经知道原始完整目标长八百二十个氨基酸,所以必须结合长度、序列和旋转位置判断当前预测覆盖了哪一部分。
它也提示我们,不能只依赖有没有截断标记来判断生物学完整性。程序在当前线性输入中找到了一个内部起始位置,输出规则中的完整预测不必等同于原始环状分子上的完整目标。这个结论来自本例已知序列关系,不是对所有内部起始预测的否定。
允许部分基因,不等于恢复环状连接
第四组在线性输入上开启部分基因选项,实际在文件开头得到一到一千七百九十七的片段,蛋白长五百九十八个氨基酸,并带有五端截断标记。
文件末尾另得到从 4,640,987 到序列末端的片段,蛋白长二百二十二个氨基酸,带有三端截断标记。两条片段的长度之和恰好为八百二十,但它们在输出中仍是两条记录,没有恢复成原始的那条完整蛋白。
因此,允许部分基因解决的是是否保留边界截断候选的问题,不能替代正确的拓扑说明。下游若按每条蛋白独立统计或聚类,两个片段可能产生不同的处理结果,不能只把长度相加就认为后续分析已经等价。
环状设置正确,也不能保证所有注释完全不变
原始环状运行有四千三百一十条 CDS,旋转后环状运行有四千三百零九条。虽然目标蛋白恢复一致,但全体蛋白集合并未完全相同,我们没有把这部分差异省略。
逐条比较后发现,原始结果多出一条位于三到九十八的三十一氨基酸假定蛋白,带有五端截断标记。其余蛋白序列及重复次数与旋转后的环状结果一致。这个额外预测处于原始文件边界附近,提示编号起点仍可能影响部分边界候选。
这里不能把少一条直接解释为工具漏掉真实基因,也不能把多一条解释为发现了新功能。当前实验没有验证这条短预测的真实生物学意义,只能确认它是两次运行之间具体、可定位的差异。
功能证据字段不能简单相加
基线结果中,四千零七十五条 CDS 带有 PSCC 信息,七百八十三条带有专家系统信息。这些是证据字段的出现数量,并不是互斥的基因分类。一个条目可以同时带有多个来源,如果把这些数量直接相加,就可能重复统计。
轻量库结果还需要按其实际信息范围解释。本次没有 UPS、IPS 或 PSC 记录,不能把软件总体介绍中的精确蛋白识别能力,直接写成这一次所有条目都使用过的步骤。应查看每个候选实际带有哪些字段和交叉引用,再决定如何描述其依据。
对于边界变短的目标,即使两次都获得相似的产物名称,匹配范围与蛋白长度仍然不同。报告时可以保留名称作为查找线索,但需要同时列出长度、坐标和证据来源,让读者看出完整蛋白与局部预测之间的区别。
实际项目应如何检查边界候选
如果一个重要基因位于 contig 端部,先检查组装本身是否完整,以及序列的线性或环状属性是否有依据。接着核对软件实际输出的拓扑元数据,再看该基因的坐标、方向、截断标记、长度和序列。
当不同组装版本只改变了环状序列起点时,应建立旋转坐标对应关系,避免直接按原坐标或位点编号求交集。若目标蛋白校验值一致,可以确认序列没有变化,但仍应保留新的位置和编号以便追踪。
本次四组运行也说明,CDS 总数相同并不保证目标蛋白相同。旋转后环状与默认线性都输出四千三百零九条 CDS,但目标一组完整、一组变短。只比较汇总数字,会漏掉对研究问题更重要的局部差异。
复现包提供完整输入生成方式、四组真实输出摘要、全体 CDS 证据字段、蛋白校验值和边界记录,可逐项检查本文结论。结果反映固定环境中的预测行为,不替代对候选功能的实验验证。下载脚本与实跑结果
需要批量注释细菌组装、维护数据库版本并复核关键边界基因时,可了解云生信的生物信息学分析计算服务。


