
转录组定量中,一个容易误导人的目标是尽量提高读段分配比例。如果参考里缺少读段真正对应的非目标序列,程序可能把它分给相近转录本,看起来利用了更多数据,却同时抬高了错误对象的丰度。另一个常见误区是看到某个转录本的 TPM 下降,就直接认为它自身的片段数量下降。
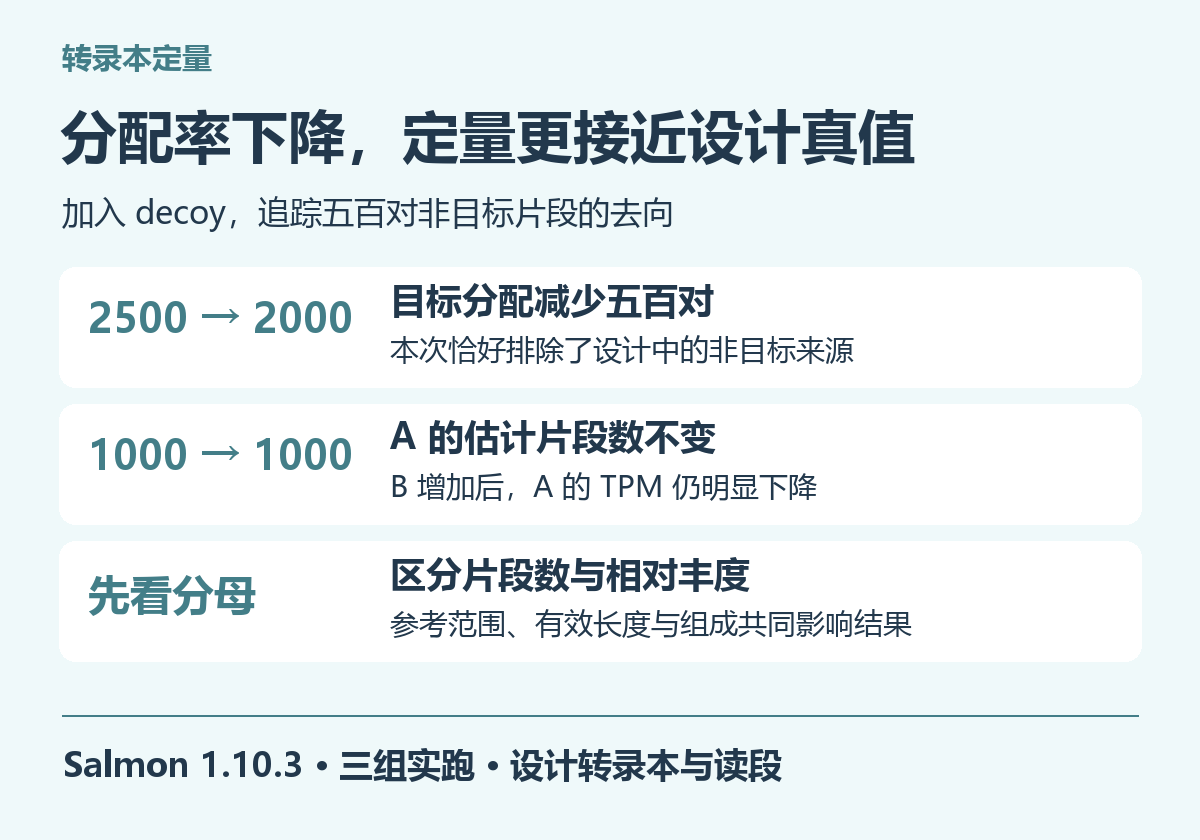
本文实际安装 Salmon 1.10.3,设计三个不同长度的转录本和一个与其中之一相近的非目标序列,完成索引和三组定量。实验同时展示两件事。加入 decoy 后,目标分配比例从百分之百下降到百分之八十,去掉的恰好是设计中的非目标片段。另一个对照中,同一转录本的估计片段数保持一千,TPM 却明显下降。
一、先把定量对象与竞争参考分清
Salmon 的输入参考决定了程序可以将片段分配给哪些目标。对于常见的转录本定量,目标是转录本序列。相似序列可能来自多个转录本,也可能来自目标集合之外的基因组区域。后者若没有被表示在参考中,就可能造成不合理的目标分配。
decoy 是参与匹配竞争、但不作为目标转录本报告丰度的一类参考。它帮助程序识别某些更适合由非目标参考解释的片段。作者说明介绍了部分基因组 decoy 和全基因组 decoy 两种准备思路,实际选择应与研究对象和参考完整性相匹配。Salmon 使用说明
理解这个机制后,就不应把 decoy 看作“降低数据利用率的开关”。它改变了哪些片段被认为适合支持目标定量。某次分配比例下降是否合理,仍需要看输入、竞争序列和过滤原因,不能单凭下降或上升判断质量。
本次采用固定版本和镜像摘要,所有结果都来自同一套软件。在线文档可能随着版本更新,复现时应以包内记录的实际命令和输出字段为准。尤其不要把一个新版本的全部行为自动归到本文使用的版本上。
二、人工数据怎样设计,为什么要这样设计
三个目标转录本分别长三千、一千五百和六千碱基,记作 txA、txB、txC。其序列按固定随机种子生成,彼此不刻意共享片段。我们再复制 txA,并沿序列每隔八十碱基替换一个位置,共改变三十七个碱基,得到 decoyA。
这个非目标序列与 txA 很相近,但并不完全相同。输入片段如果来自 decoyA,在只含目标的参考中仍可能被 txA 接纳,而加入准确的 decoy 后就有了更合适的竞争对象。这个设计用来展示参考缺失的影响,不代表真实样本中的某种具体污染或基因家族。
基线文库由两千五百对无测序错误的读段组成,每端一百碱基,片段长度在二百二十至二百八十之间。生成时先抽取完整片段,再取正向首端和反向互补末端,最后将片段顺序打乱。两个 FASTQ 文件始终成对保存,不能各自独立打乱。
| 片段来源 | 基线文库 | 增加 B 的文库 |
|---|---|---|
| txA | 1000 对 | 1000 对 |
| txB | 500 对 | 1000 对 |
| txC | 500 对 | 500 对 |
| decoyA | 500 对 | 500 对 |
| 总计 | 2500 对 | 3000 对 |
第二个文库保持 A、C 和非目标片段数量不变,只增加 B 的数量,用来观察组成变化。两个文库各自重新抽取片段位置,因此它们不是逐条读段完全相同的复制。我们固定的是来源数量与生成规则,而不是假装所有其他观测细节都完全不变。
三、索引文件怎样组织,避免 decoy 没有真正生效
实验建立了两个索引。第一个只包含三个目标转录本,第二个在目标后追加 decoyA,并通过独立名单声明它的名称。仅把序列追加到 FASTA 而不正确声明,就可能把它当作普通目标,改变定量对象的含义。
salmon index -t transcripts.fa -i index_plain -k 31 -p 2

salmon index -t gentrome.fa -i index_decoy \
  --decoys decoys.txt -k 31 -p 2

salmon quant -i index_decoy -l ISF \
  -1 baseline_1.fq -2 baseline_2.fq \
  -p 2 --validateMappings --dumpEq \
  -o with_decoy
这组读段的方向是我们主动设计的,因此使用与设计一致的 ISF。本文没有依赖自动推断文库类型,也没有对不同方向设置做性能比较。真实文库应根据实验方案和输出检查确定方向,不能因为某个示例用了这个值就直接复制。
输入参考名称也必须仔细检查。名单中的名称要能精确对应 FASTA 中的序列标识,目标转录本与 decoy 不应因为命名处理产生混淆。对于来自不同数据库的参考,标题裁剪、版本后缀和重复标识都值得在建立索引前核对。
两套索引共用相同的目标序列,因此基线文库的前两组差异主要对应 decoy 是否参与竞争。若同时换了目标转录本版本,就无法将结果变化简单归因于 decoy。可解释的对照需要尽量减少同时改变的条件。
本次还核对了文库格式诊断文件,三组已经分配的片段都与所指定方向兼容,没有出现不一致方向或孤立端映射计数。这项检查帮助确认本次对照没有同时混入明显的配对方向问题,但它不构成对所有真实文库质量的保证。
在自己的项目中,可将这类诊断与样本清单关联保存。每个样本记录文库类型、两个输入文件、目标索引和实际命令,发现异常时先定位到具体样本。把不同样本的两个末端误配成一组,也可能产出文件,单纯检查文件是否存在无法发现这种输入错误。
四、实际分配结果,少了五百对意味着什么
只含目标的索引将基线文库的两千五百对片段全部分配给了目标,其中 A 得到一千五百,B 和 C 各五百。加入 decoy 后,A 回到一千,B、C 仍各五百,另有五百对被记为 decoy 片段。
| 条件 | A 片段 | B 片段 | C 片段 | decoy |
|---|---|---|---|---|
| 基线,不含 decoy | 1500 | 500 | 500 | 0 |
| 基线,含 decoy | 1000 | 500 | 500 | 500 |
| 增加 B,含 decoy | 1000 | 1000 | 500 | 500 |
这里可以明确判断五百对的去向,是因为设计时保存了来源真值。目标分配比例下降并不意味着随机丢失了五百对目标片段,而是正确识别了本次特意加入的非目标来源。这是一个受控实验的结论,不能推广成“任何分配率下降都代表结果更好”。
实际项目中,应同时查看处理片段总数、分配到目标的片段数、被 decoy 吸收的片段数及其他过滤信息。若比例突然改变,可以先检查参考是否变化、名单是否正确以及输入是否来自相同文库。单独截取一个百分比用于比较,会掩盖这些不同原因。
还要区分读段端数与片段数。基线有两千五百对,也就是五千条单端读段。在这个双端定量实验中,结果中的数量对应配对片段的估计分配,不能再因为有两个 FASTQ 就把每个目标的数量乘二。
五、为什么两个目标片段数相同,TPM 差很多
加入 decoy 后,B 与 C 都得到五百个估计片段,但 TPM 分别约为四十七万和十万。原因可以从它们的有效长度看出来。本次 B 的有效长度约为 1249.937,C 约为 5749.937,相同片段数并不意味着相同的长度校正丰度。
有效长度与参考序列的实际长度相关,但不是简单复制那一列。它还反映当前模型对可产生观测片段机会的处理。阅读输出时应同时保留 Length、EffectiveLength、NumReads 和 TPM,不能将它们当作可以相互替换的不同名字。输出格式说明
在本次未启用额外偏倚校正的简化实验中,可以用估计片段数除以有效长度,再将所有目标的结果归一到一百万,复查输出 TPM。这样做的价值在于理解分母,而不是鼓励在任何复杂模型下都手工替代软件的计算。
import csv

with open("with_decoy/quant.sf") as handle:
    rows = list(csv.DictReader(handle, delimiter="\t"))

rates = [float(r["NumReads"]) / float(r["EffectiveLength"]) for r in rows]
denominator = sum(rates)

for row, rate in zip(rows, rates):
    print(row["Name"], rate / denominator * 1_000_000, row["TPM"])
由于输出中的有效长度已经经过格式化,手算末尾可能出现很小的差异,应使用合理误差范围比较。若差异很大,优先检查读错列、字符串转数字、遗漏目标或将实际长度误当有效长度等问题,不必立刻怀疑模型失效。
六、A 的片段数没有变,TPM 为什么下降
在含 decoy 的基线结果中,A 的 TPM 为 427504.313640。增加 B 的文库中,A 仍得到一千个估计片段,但 TPM 降到 290748.918588。C 同样保持五百个片段,TPM 也从 102228.076478 降到 69523.119148。
这并不矛盾。TPM 表示当前目标集合内的相对丰度,其他对象增加会改变归一化分母。A 自己的片段数保持不变,仍然可能占据更小的比例。每个结果文件的 TPM 总和都接近一百万,并不能证明每个目标都具有相同的绝对表达背景。
| 含 decoy 的文库 | A 的片段数 | A 的 TPM | B 的片段数 |
|---|---|---|---|
| 基线 | 1000 | 427504.313640 | 500 |
| 增加 B | 1000 | 290748.918588 | 1000 |
在真实生物学数据中,我们通常没有这种逐来源的设计真值,因此更需要谨慎解释。仅凭 TPM 下降,不能单独推出细胞内该转录本的绝对分子数下降。实验设计、取样量、整体 RNA 组成和所采用的统计分析会共同影响能够回答的问题。
同样不能用本次人为保持片段数不变的设计,去推断所有真实样本都存在相同变化机制。这个对照展示的是一个可能发生且能够计算清楚的组成效应,提醒读者检查自己的结论是否超出了相对量所支持的范围。
七、从转录本结果进入下游分析时,先核对标识与单位
Salmon 的目标标识来自参考转录本。如果后续需要按基因汇总,就要准备与这套参考相对应的转录本到基因关系。随意删除版本后缀、混用另一个注释版本或重复匹配同一转录本,都可能制造错误合并或漏项。
对于基因水平差异分析,可阅读 tximport 的正式导入流程,明确怎样同时处理估计计数、丰度和长度信息。tximport 教程 不应看到输出有小数就随意四舍五入,更不应把 TPM 列改名为原始计数后直接送入要求计数输入的流程。
本次没有执行差异表达检验,没有生物学重复,也没有给出显著性结论。三个条件是机制对照,不能包装成处理组与对照组的真实实验。它们的作用是帮助读者理解输入参考和归一化如何改变定量结果。
如果只是制作探索图,可以使用清晰注明单位的相对丰度。但图注仍应交代参考、定量工具版本和数据来源。一个漂亮的热图不会自动说明目标是否相同、样本是否可比,以及颜色变化是否对应绝对数量变化。
八、怎样评价 Salmon,并把小实验经验用于正式项目
Salmon 的优势是能直接从读段得到转录本丰度及相关诊断信息,适合在固定参考下批量处理样本。它也提供竞争参考和多种模型选项,让定量不只依赖最简单的序列匹配。对于读者来说,真正的收益是能够保留输入与输出之间的解释链条。
它的局限同样清楚。目标不在参考中,就无法按正确目标报告。相似转录本的信息不足,不会因为输出保留很多小数而消失。decoy 不完整或不合适,也可能留下问题。本次没有加入复杂同源家族、测序错误或真实偏倚,因此结果不能作为所有场景的准确率证明。
实际工作中可先抽取少量样本,比较合理的参考方案,并逐项检查目标数、片段去向、有效长度和关键转录本变化。确认解释一致后再扩展到完整队列。所有样本最好使用同一套参考和参数,确需变更时保留版本并重新评估可比性。
下载本组复现材料可获得固定镜像、三个目标和 decoy 的生成规则、片段来源数量、两套索引命令与三组完整结果,读者可以重新核对文中的每个数字。
当转录本定量需要覆盖更多样本,并持续固定参考、记录参数和保存结果版本时,可以了解云生信生物信息分析环境服务。


