
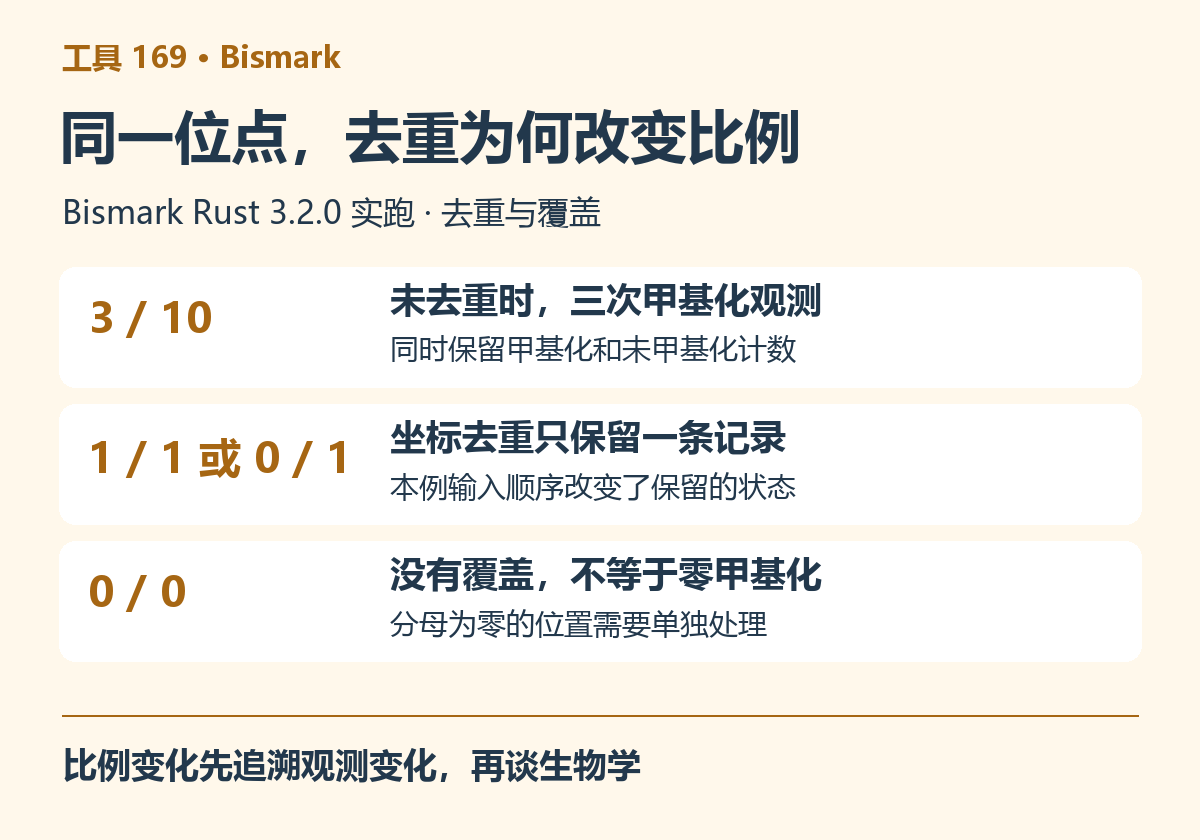
一个位点有三条甲基化读段、七条未甲基化读段,比例是百分之三十。把同一份比对按坐标去重,只剩一条以后,比例可能成为百分之百。将输入记录顺序反过来,再做相同去重,又可能成为零。本次人工实验实际出现了这三种结果。它们并不代表样本发生了变化,而是分析保留了不同的观测。
本文使用 Bismark Rust 3.2.0、Bowtie 2 2.5.5,实际完成参考准备、单端比对、甲基化提取、去重和结果核验。当前项目已经区分 Rust 套件与旧 Perl 分支,版本信息可查阅官方仓库。本文所有输入均为自编数据,不评价真实文库的转化效率、准确率或运行性能。
一、从能够核对答案的小文库开始
我们构造一条一万二千碱基的虚构参考,并生成二十条有确定来源的单端读段,每条一百五十碱基。第一组十条来自同一个起点,在设定的 CpG 位置上,前三条保留胞嘧啶,后七条转换为胸腺嘧啶。第二组十条的起点依次错开一个碱基,部分 CpG 保留,另外特意让读段开头的若干非 CpG 胞嘧啶保持未转换。
随后增加四条全为未知碱基的阴性对照,输入总数为二十四。这里的人工转换规则保存在脚本中,软件运行前就能逐条算出预期的序列、位置和甲基化标记。我们没有给第一组十条读段附加分子条形码,因此仅凭相同坐标,不能从本例输入判断它们是否来自同一个原始分子。
这套设计有两个目的。一个是核对比对与提取是否忠实保留了设定的信息,另一个是观察去重和读端忽略怎样改变统计。它不是对真实测序的完整模拟,没有测序错误、复杂重复区域或配对异常,也不支持将得到的百分比当成真实样本质量标准。
二、比对率先看分母,再看是否符合输入设计
实际运行先为参考建立亚硫酸氢盐转换索引,再用默认方向性文库设置进行单端比对。下面是本例主要命令,参考和读段都由复现脚本创建。
bismark prepare --bowtie2 genome

bismark align --bowtie2 \
  --unmapped --ambiguous \
  -o align genome reads.fq
结果二十条读段具有唯一最佳比对,四条全未知碱基读段没有比对,比对率显示为百分之八十三点三。这个数字完全符合本例设计,不能因为没有达到某个想象中的高比例就认定运行失败。反过来,即使一个人工文库全部比对成功,也不能据此说明复杂真实样本同样容易处理。
脚本逐条检查了二十条比对的起点、长度和输出序列,还检查每条读段的甲基化标记字符串是否等于生成时预期。所有读段均为完整的一百五十碱基匹配,没有插入缺失。这个核验比只看比对率更具体,因为总数一致仍然可能掩盖位置或方向错误。
真实数据的方向性设置应来自文库制备信息。默认方向性、非方向性和其他建库方式不是为了提高比对率可以任意切换的按钮。官方比对说明给出了相应模式。本文只运行所构造的方向性单端案例,没有用这个结果验证其他文库模式。
三、提取表中的正负号,不一定是基因组链方向
Bismark 比对记录中的甲基化标记会区分 CpG、CHG 和 CHH 上下文,并区分大小写所表达的状态。本次全部有效读段来自设定的同一类原始链,但提取后的逐观测文件中仍同时出现正号和负号。原因是该输出中的符号用于区分甲基化与未甲基化标记,不能直接套用普通 BED 的链方向解释。
例如,第一组同一位点的前三条记录显示甲基化状态,后七条显示未甲基化状态。它们并没有因此变成来自两条相反的基因组链。如果整理时看见负号就把坐标反向转换,或者按照这个符号统计正反链覆盖,结果会从字段解释阶段开始出错。
逐观测提取文件、覆盖表和全参考胞嘧啶报告也不是同一种表。逐观测文件的一行对应读段在一个位置提供的观测,覆盖表把同一位置的观测合并,胞嘧啶报告则进一步按参考列出位置和上下文。官方提取文档分别描述了这些格式,使用之前应先确认自己打开的是哪一种。
本次启用所有上下文输出后,覆盖表有八十五个被观测的胞嘧啶位置,总计九十九次甲基化标记和七百零八次未甲基化标记。这里的八十五不是 CpG 位点数,也不是读段数。把八十五行与二十条读段直接比较没有意义,因为每条读段可以跨过多个胞嘧啶位置。
四、去重改变了哪些观测
第一组十条读段具有相同起点和方向,默认按坐标去重时只保留一个。第二组十条起点各不相同,都被保留。实际报告显示从二十条有效比对中删除九条,剩余十一条。我们随后对这份结果重新提取甲基化,而不是只修改原来的覆盖表。
在参考的一起点位置一千零三十一,去重前为三次甲基化和七次未甲基化,比例三成。原始顺序中首先保留的是甲基化读段,去重后变成一次甲基化、零次未甲基化,比例百分之百。将相同的比对记录反序后再次去重,保留的则是未甲基化读段,比例变为零。
| 处理方式 | 甲基化计数 | 未甲基化计数 | 该位点比例 |
|---|---|---|---|
| 未去重 | 3 | 7 | 30% |
| 原顺序去重 | 1 | 0 | 100% |
| 反序后去重 | 0 | 1 | 0% |
这不是软件在随机制造甲基化状态,而是默认保留规则与输入顺序共同决定了留下哪条记录。官方去重说明明确描述首先保留的记录及文库适用范围。实验中两次去重都删除九条,但最终保留的甲基化信息不同,所以“去重率一样”也不等于结果逐位点相同。
这个例子不能用来证明真实分析应该一律不去重。对于由扩增产生的重复观测,合理去重有其必要性。但当相同起止位置由实验设计本身造成,或者测到的片段范围受到限制时,按坐标合并可能删除不同分子的观测。是否使用分子条形码、条形码位于哪里、是否需要纠错,都应由实际文库决定,不能从文件中有多少相同坐标倒推出答案。
本例还有一个值得养成的记录习惯,比较去重结果时,同时报告保留数量、位点覆盖和比例。三成与百分之百看起来差异很大,但后者只有一次观测。若在图中都画成同样大小、同样透明度的点,读者很容易误以为证据量相当。
五、忽略前五个碱基,既能去掉偏差,也会减少有效信息
第二组读段被故意设置了读端未转换信号,因此全量结果中出现二十五次 CHH 甲基化标记。我们保持同一份比对文件,只在提取时忽略每条单端读段最前面的五个碱基,观察输出发生什么变化。
bismark extract -s --comprehensive --bedGraph --CX \
  --buffer_size 64M --ignore 5 \
  -o trim5 align/reads_bismark_bt2.bam
这一次二十五次人工设置的 CHH 甲基化标记全部被排除。但被排除的并不只有它们,第一组读段靠近开头的一个真实设定 CpG 也落在忽略范围内,因此同时减少了三次 CpG 甲基化和七次 CpG 未甲基化观测。所有上下文的总计数从八百零七下降到七百七十二,被覆盖位置由八十五降到八十一。
| 指标 | 不忽略读端 | 忽略前五碱基 |
|---|---|---|
| CHH 甲基化标记次数 | 25 | 0 |
| CpG 甲基化标记次数 | 74 | 71 |
| CpG 未甲基化标记次数 | 106 | 99 |
| 所有上下文观测总数 | 807 | 772 |
这说明读端裁剪是一个带代价的选择,不能因为处理后曲线更平,就宣布所有真实信息都得到保留。实际项目应结合读段位置上的甲基化分布、建库步骤和重复之间的一致性,选择有依据的范围,并记录因此损失多少覆盖。不同文库没有理由统一套用本例的五个碱基。
本次保存了位置偏倚统计文件,可以检查异常是否集中在预期读端。但我们没有把人工设置的非 CpG 信号当作真实转化效率估计,也没有提供真实样本的偏倚阈值。观察到非 CpG 状态以后,应先区分实验背景与技术处理,不应直接用一个通用比例代替具体判断。
六、相同位置在两个文件里,为什么起点差一
本例的一千零三十一位点,在普通覆盖文件中写为起点一千零三十一、终点一千零三十一。在浏览器轨道文件中,则写为起点一千零三十、终点一千零三十一。前者是一起点、两端包含的单位置记录,后者采用零起点、右端不包含的区间表达,指向同一个碱基。
如果把普通覆盖表直接当作 BED,起点与终点相同就会形成零长度区间。有些下游程序会拒绝,有些会特殊处理,有些可能继续运行但不符合预期。不能因为表格看起来都有染色体、起点和终点,就忽略它们的坐标约定。
我们还实际运行了零起点输出选项。本次版本仍保留普通覆盖文件,同时另外生成带零起点标识的覆盖文件,后者在该位点使用一千零三十到一千零三十一。这个细节很容易漏掉,若下游仍按旧文件名读取普通覆盖表,就会误以为参数没有生效,或者误把仍然一起点的数据再次转换。
因此,转换以后应核对实际产物名称与至少一个已知位点,不要仅凭命令中出现了某个选项就给所有文件贴同一种坐标标签。将数据交给区间注释、浏览器或差异分析工具时,也应分别确认它们接受的坐标格式,尤其避免重复减一。
七、零覆盖不是零甲基化
本次还生成了全参考胞嘧啶报告,输出五千八百八十五行,其中八十五个位置有覆盖,五千八百个位置没有覆盖。没有覆盖的位置,其甲基化和未甲基化计数都是零。这两列同时为零意味着没有观测,比例分母为零,不是已经观察到百分之零甲基化。
相反,一个被十条未甲基化读段覆盖的位置,计数为零和十,才支持当前观测比例为零。两者在某些绘图函数中都可能被填成零,但统计意义完全不同。做区域平均或样本比较时,如果把未覆盖位置当作零纳入平均,会把测序覆盖差异转变成看似的甲基化差异。
保留两类计数比只保留百分比更有用。同样为一半,一次对一次与五十次对五十次的观测量相差很大。后续差异方法需要据此处理不确定性,而不是把所有比例当成精度一样的连续测量。本文没有执行差异甲基化检验,不能从这个流程验算直接得到组间结论。
八、怎样把小案例的检查迁移到真实任务
首先保留参考版本、文库类型、原始命令和实际工具版本,再检查比对的分母与被排除类别。随后抽取少量位置,确认读段序列、甲基化标记、覆盖计数和坐标能互相对应。最后比较去重及读端处理前后,有多少读段、位点和观测被保留。这个顺序能把“比例为什么变了”追溯到具体处理。
Bismark 的优势是把比对与胞嘧啶状态解释连接起来,并提供多个层级的输出方便检查。它的限制在于,任何一个最终比例都继承了文库方向、重复处理、读端选择和覆盖范围的影响。流程完整不等于每一步设置都适合当前实验,也不意味着一个高比例位点拥有充分证据。
下载本组脚本和结果记录,在本篇目录执行下面命令,可重新生成参考、二十四条读段和全部对照。脚本固定镜像摘要,运行容器限制两核、四 GiB 内存,另外使用 Samtools 读取比对并逐条核验。原始顺序与反序去重、读端忽略、坐标及未覆盖位置均保留实际输出,建议每次使用新的目录。
python3 run.py output
当项目扩展到全基因组甲基化和多个样本,需要持续保存比对、覆盖及处理记录时,可通过云生信生物分析服务器服务组织可追溯的批量分析。


