生信论文返修实战20讲 · 第01讲 · 建立返修起点
系列目录:生信论文返修实战20讲(当前第1讲)
- 第01讲:收到返修意见后怎么办?把审稿问题拆成可执行任务(本篇)
- 第02讲:返修前先冻结分析:输入、版本与结果怎样重放
- 第03讲:样本量为什么对不上?核查纳入、排除与重复测量
- 第04讲:样本太少怎样回应?报告效应、区间与真实限制
- 第05讲:差异分析被质疑:模型、方向和多重检验逐项核查
- 第06讲:要求校正年龄和批次?先判断资料是否支持
- 第07讲:换个阈值还成立吗?做有边界的敏感性分析
- 第08讲:独立验证不一致怎么办?保留全部候选与证据
- 第09讲:富集结果怎样返修?检查背景、方向和贡献成员
- 第10讲:单细胞显著性可靠吗?先认清细胞、文库与供体
- 第11讲:细胞注释与比例被质疑:标记依据和分母怎样交代
- 第12讲:拟时序和通讯怎样改写?避免把推断写成机制
- 第13讲:模型性能过高先查什么?用随机标签识别数据泄漏
- 第14讲:只有ROC不够:校准、误差与简单基线一起评价
- 第15讲:生存分析怎样返修?事件、截点与模型假设核查
- 第16讲:审稿人要求补实验:公共数据能支持到哪一层
- 第17讲:图形与图注怎样修改?展示样本、效应与不确定性
- 第18讲:方法写到哪里才够?参数、版本与数据代码可用性
- 第19讲:逐条回复怎么写?把动作、证据和修改位置对应起来
- 第20讲:提交返修前最后一查:正文、回复与附件保持一致
点击目录按篇次顺序学习;文末复现包包含全系列代码与起始数据。
收到返修意见,先把“补分析”变成可验收的任务
一封返修信里经常同时出现样本量、统计方法、独立验证、机制解释和语言修改。初学者很容易打开软件,先完成自己最熟悉的那张图,几天后却发现真正决定论文结论的问题还没有处理。本系列从这个入口开始:怎样把审稿意见转成有输入、有判断、有交付物的工作,再把结果写回论文。二十篇围绕同一批公开资料递进,读者可以看到一次修改怎样影响后续图表、方法和回复。
下面的审稿意见、原稿句子和回复信均为教学情景,不来自某篇真实投稿。贯穿案例使用结肠组织公开表达数据,发现分析为GSE75214中按规则选出的八十五个样本,独立研究资料为GSE87466的一百零八个样本。单细胞部分使用GSE116222的上皮教学子集。实际完成的是公共数据二次分析与教学演示;没有获得新的患者样本,也没有完成干预实验。
教学审稿意见:作者应说明样本纳入标准,重新核查差异分析,并提供独立证据支持关键结论。目前的机制表述可能超过数据能够支持的范围。
这段意见看似只有一句话,实际上至少包含四个任务。如果只回复“感谢建议,我们已增加生信分析”,审稿人仍然无法判断问题是否解决。最有效的第一步是拆开动词:说明、核查、验证、收窄。每个动词对应不同的完成标准,也对应不同的证据成本。
用五个问题拆解一条意见
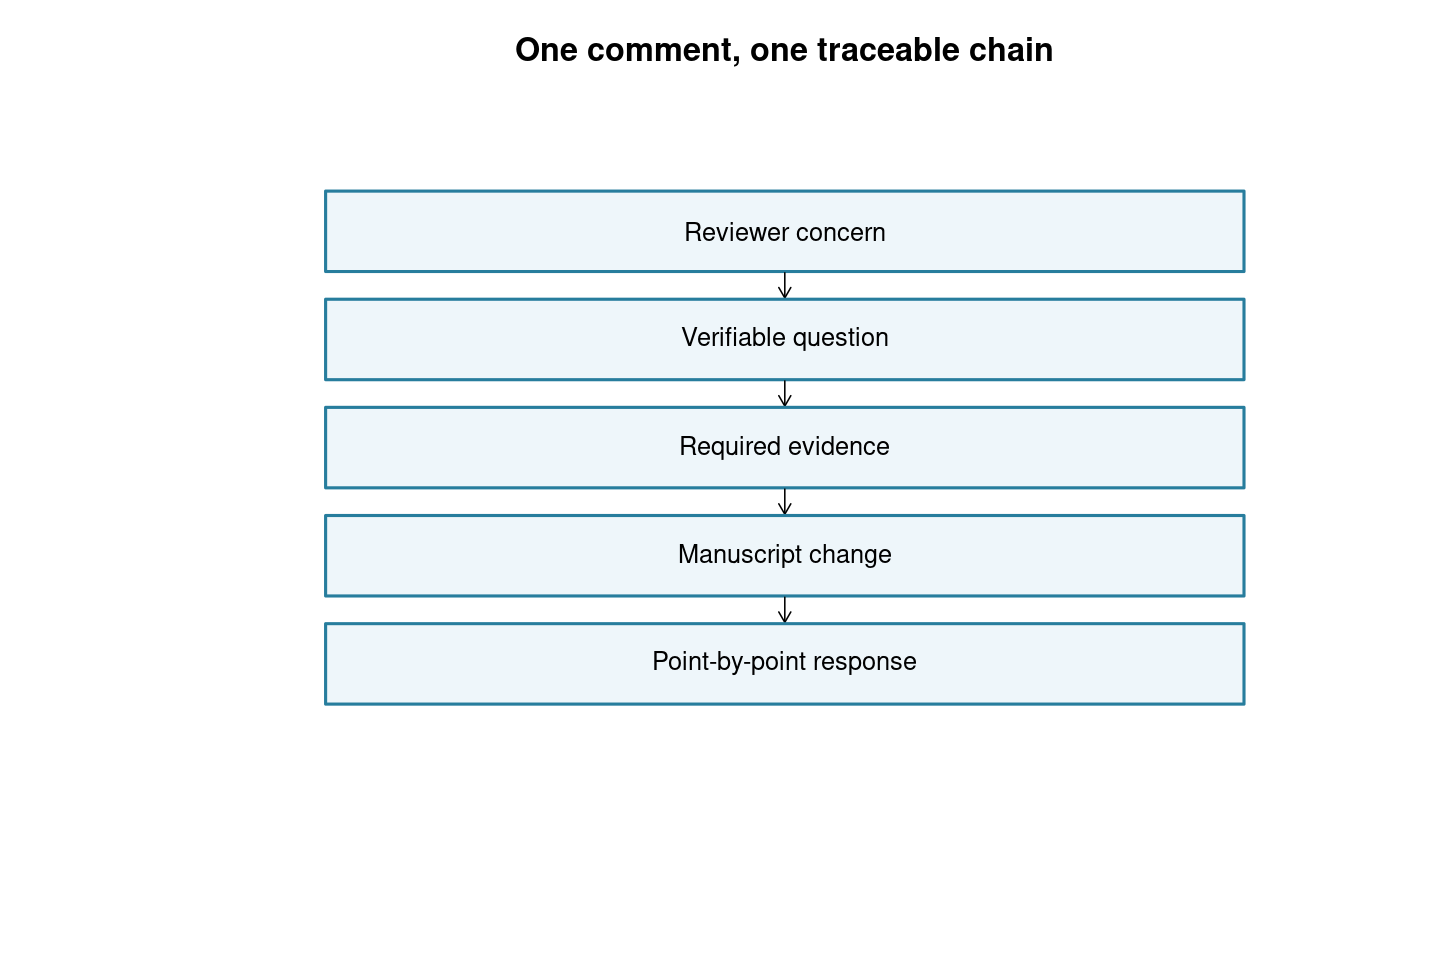
第一个问题是对方质疑了什么:资料来源、计算正确性、结论稳定性,还是因果解释?第二个问题是现有文件能否回答。第三个问题是需要执行什么具体动作。第四个问题是动作完成后怎样判断结果。第五个问题是哪些位置必须同步修改。将这五项写下来,比立即寻找新的分析工具更容易控制返修范围。
例如“独立验证不足”不能直接翻译成“再下载一个数据集”。先确认审稿人希望重复的是表达方向、预测性能、细胞来源还是功能作用。另一个组织表达队列可以帮助核查表达关联,却不能自动证明某种细胞中的功能机制。如果问题类型没有对齐,新增十张图也可能没有回应核心质疑。
本篇脚本建立八条教学任务,保存编号、主题、动作、优先级和状态。初始状态统一为计划中,避免刚创建表格就把工作标记完成。编号采用审稿人与条目组合;当同一句意见拆出多个动作时,可以继续添加子编号。编号在后续图表、回复账本和提交前审计中保持不变。
| 意见类型 | 可以执行的动作 | 完成时需要的证据 | 主要修改位置 |
|---|---|---|---|
| 样本不清楚 | 重建纳入排除表 | 每个样本的去留与原因 | 方法、流程图 |
| 统计不清楚 | 核对模型、比较方向和校正范围 | 脚本、完整结果表 | 方法、结果、图注 |
| 验证不足 | 按固定候选检查另一研究 | 全部候选的效应与区间 | 结果、补充材料 |
| 机制过强 | 逐句检查观察与因果措辞 | 证据缺口表 | 摘要、讨论、结论 |
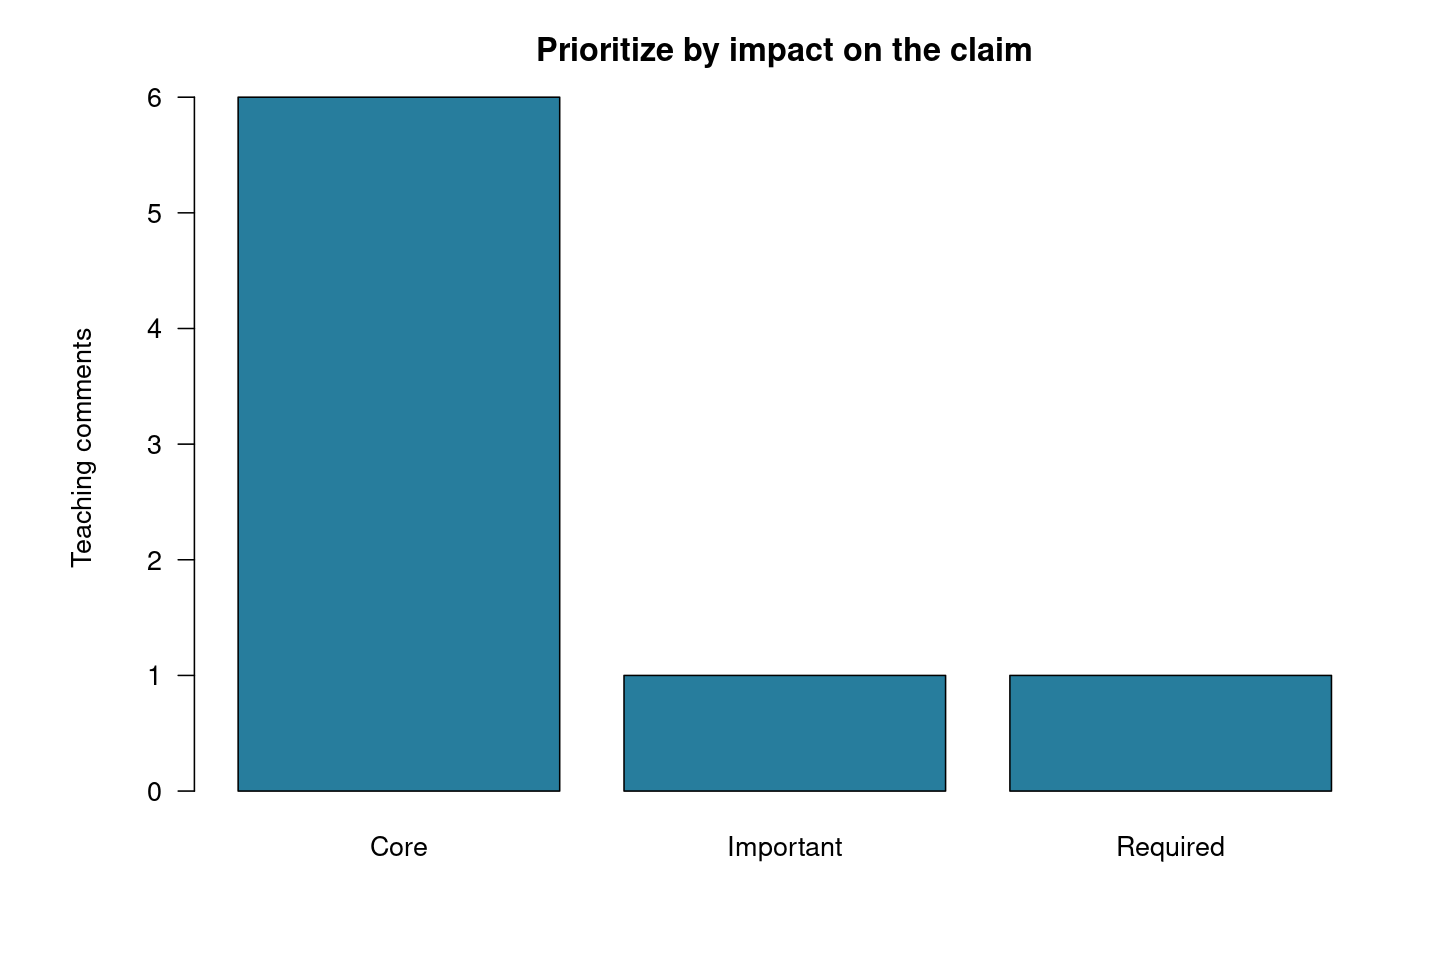
优先级由结论依赖决定
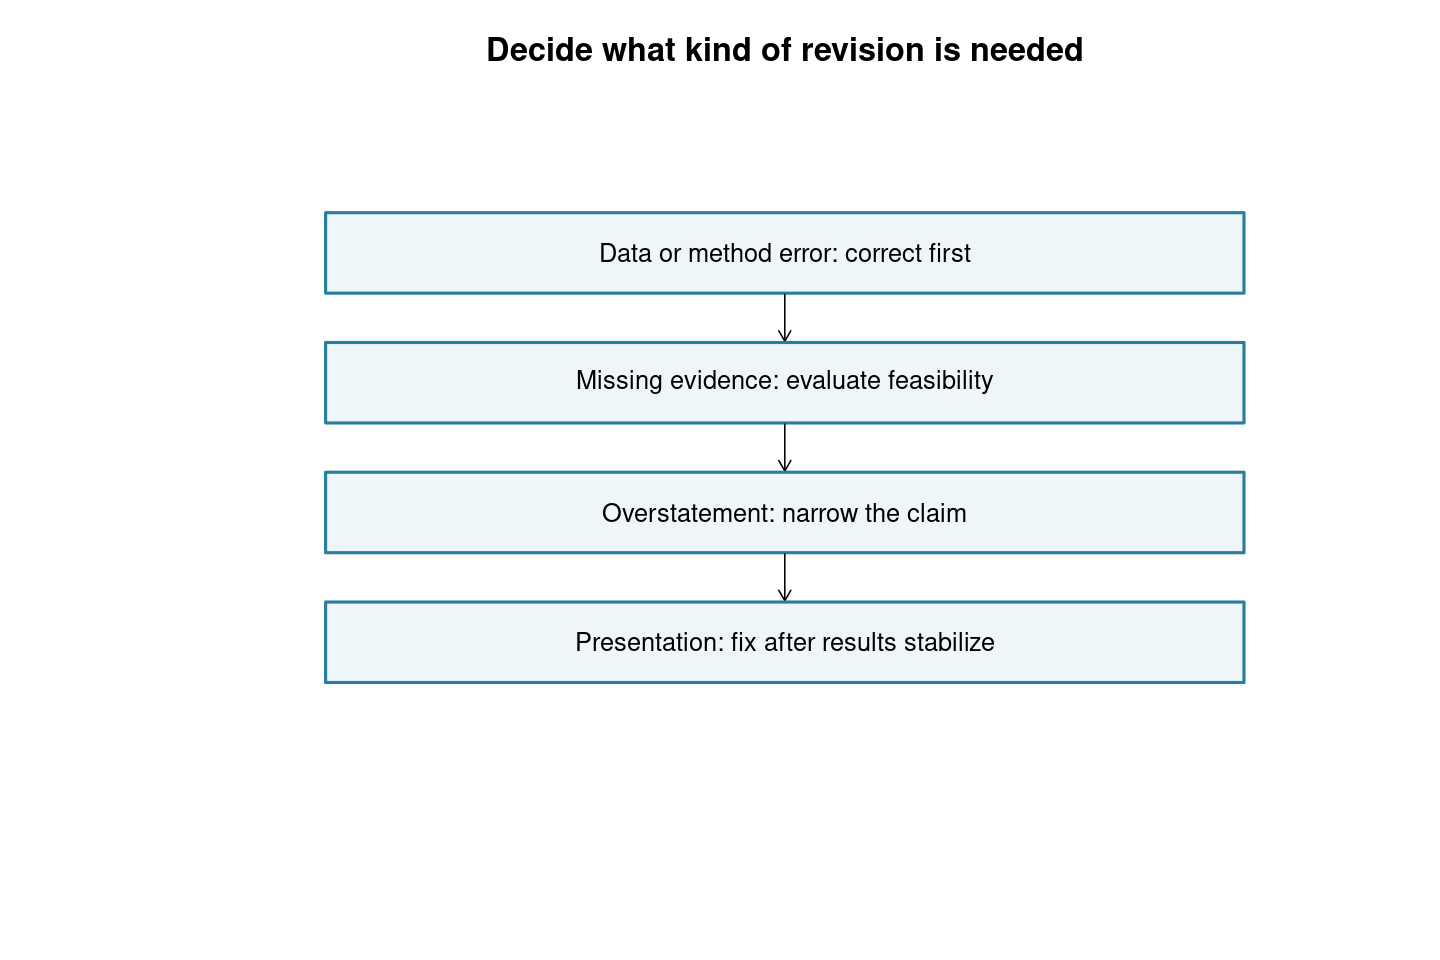
样本是否正确、独立分析单位是否正确、模型能否识别目标效应,这些问题应排在美化图形之前。原因很具体:如果样本或模型发生变化,后面的富集、候选和验证解释可能都要更新。先排版再修正输入,会制造大量重复工作,也容易让旧数值残留在摘要与图注里。
把任务分成“会改变主要结论”“补足报告透明度”“表达和格式”三类只是方便安排,并不意味着第三类可以忽略。审稿人要求明确坐标含义,看似格式问题,也可能暴露结果尺度写错。判断优先级时应看错误影响,不要仅凭意见字数或语气判断重要程度。
时间安排也要根据依赖关系。第一个工作日可以冻结原稿、整理意见、检查输入;随后先解决样本和模型;结论稳定后再完善图片和回复。在真实项目里应把实验周期、数据申请时间和合作者反馈时间放入计划。这里不替读者设定固定完成天数,因为不同任务的可行性差异很大。
怎样定义“已经完成”
完成不是“代码运行过”,而是动作、证据和稿件三者相符。例如重跑差异分析后,应保存模型公式、比较方向、全部基因结果以及使用该结果的图表版本;正文里相应的方法与数字也要更新。只有图变了、方法没变,任务仍然没有闭合。
建议为每项任务保留一个可检查的交付物。样本核查交付样本表,敏感性分析交付完整情景表,回复修改交付带定位信息的段落。截图可以辅助沟通,但不应替代可检索的数据表。不要在任务表里写“分析没问题”这种无法复核的状态说明,应写“样本顺序检查通过,输入与矩阵列名一致”。
有些任务只能部分完成。比如公开资料缺少对照年龄,无法实施可信的疾病效应年龄调整;这时可以完成缺失审计和结论收窄,但不能把“年龄混杂已排除”标为完成。部分完成要写清解决了哪一层问题、剩余什么缺口,以及缺口如何影响主要结论。
代码如何帮助管理返修
代码在本篇承担的是生成账本和检查结构,不是自动判断科学问题。脚本输出任务清单与三张示意图。读者可以修改意见内容,再检查是否存在空动作、重复编号、没有交付物的条目。正式项目可增加负责人、依赖任务、证据文件和稿件位置,但不要为了表格完整而编造不存在的信息。
运行方法与交付文件
下载文末完整复现包,先解压并保留目录结构,将R的工作目录切换到workbook目录。输入位于data,公共函数位于scripts/common.R,分篇结果位于results。附件保留前序输出,便于单篇学习;如果改变输入、模型或前序参数,应顺序重跑所有受影响步骤,避免新数据与旧结果混用。
Rscript scripts/01.R
本篇脚本会生成三张图和对应表格。先检查日志是否正常结束,再核对实际输出的样本、字段、尺度与正文,不要仅凭文件存在判断运行成功。环境记录来自实际验证,包版本不是自动锁定;安装时需保持R与依赖相容。完整顺序运行入口和原始公开数据整理方法见包内说明,模拟与公开观测数据分别标注。
下面列出本篇完整R脚本。初学者可先原样运行,再在副本中改变一个参数观察影响。保留原始输入,不通过改组别、补造临床字段或删除不合预期的样本来解决报错。遇到缺少文件,首先检查工作目录和前序依赖;遇到数值差异,先核查版本与输入,再解释科学含义。
source("scripts/common.R")
o<-start(1)
# 教学审稿意见:不是来自真实投稿,也不代表已经完成返修
issues<-data.frame(id=sprintf("R1.%02d",1:8),topic=c("Reproducibility","Sample flow","Model/FDR","Confounding","External check","Single-cell unit","Interpretation","Files"),priority=c("Core","Core","Core","Core","Core","Core","Important","Required"),action=c("Replay original","Trace exclusions","Refit model","Audit metadata","Test fixed panel","Preserve sample hierarchy","Revise claims","Check consistency"),status="Planned",evidence="Not yet attached")
tab(issues,paste0(o,"/revision_tasks.csv"))
fig(paste0(o,"/fig1.png"),barplot(table(issues$priority),col="#277D9D",ylab="Teaching comments",main="Prioritize by impact on the claim"))
fig(paste0(o,"/fig2.png"),flow(c("Reviewer concern","Verifiable question","Required evidence","Manuscript change","Point-by-point response"),"One comment, one traceable chain"))
fig(paste0(o,"/fig3.png"),flow(c("Data or method error: correct first","Missing evidence: evaluate feasibility","Overstatement: narrow the claim","Presentation: fix after results stabilize"),"Decide what kind of revision is needed"))
打开生成的任务表时,先选一条意见尝试交接给没有参与讨论的同事。如果对方不知道输入文件在哪里、要比较什么、何时算完成,说明任务描述还不够具体。把“补充稳健性”改成“逐一省略对照样本,保存目标基因效应并比较方向”,就能显著减少理解偏差。
原稿和回复怎样同步改变
教学原稿:“我们通过多种生信方法证明该基因参与疾病发生。”这句话把计算工具数量当作证据强度,也把关联直接写成了作用机制。当前数据条件下,更合适的修改稿是:“我们在公开组织表达数据中观察到该基因与疾病分组相关,并在另一研究中检查表达方向;其功能作用仍需干预实验验证。”
中文回复示例:“感谢审稿人指出证据层级不清的问题。我们已将意见拆分为样本、统计、独立研究核查和结论措辞四项任务。本文展示的任务账本仍为执行起点,各项分析结果将在相应章节报告;尚未完成的实验不会写成已完成。”这份回复用于教学计划说明,不应直接冒充最终提交信。
英文示例:“We have separated the concerns into sample eligibility, statistical analysis, independent-study assessment, and interpretation. The task ledger identifies the required evidence for each item. Pending experimental work is not described as completed.”英文不需要堆砌客气表达,重点是动作和状态准确。
把这套方法用到自己的稿件
先复制完整审稿意见,保留上下文,再写自己的解释。只截取容易回应的半句话,可能忽略另一半对结论的限制。若同一问题由两名审稿人提出,可以共享分析证据,但在两处分别回应,并注明相关修改位置。不要让审稿人自行搜索另一段回复才能找到答案。
遇到意见之间存在冲突时,应把冲突写成具体选择。例如一位要求扩大分析范围,另一位要求聚焦主线,可以保留主分析范围,将必要的补充核查放入附录,并解释这样安排如何服务研究问题。若冲突影响论文定位或必需实验,应向编辑说明具体分歧和可行方案,不能自行假定某条意见可以忽略。
返修账本也应记录否定结果。一个候选没有在独立研究复现,可能意味着需要收窄结论,而不是悄悄删掉验证任务。把不支持原假说的结果保留下来,能够帮助团队在修改讨论时形成共同认识,避免回复信和正文分别讲出两个故事。
实际开始时,可以先处理五条最影响结论的意见,逐条检查是否具备问题、动作、输出和定位。完成这一轮后再扩展到全部条目。下一篇将冻结原始分析和运行环境,让后续每次变化都有可比较的起点;这也是账本里“重新核查”能够落到实处的基础。
实操练习:把一条模糊意见改成可交接说明
假设收到“建议加强结果可靠性”的意见,先不要给它分配软件名称。写出你认为它可能指向的三件事:样本是否可信、分析是否稳定、另一资料是否支持。接着回到意见上下文,确认对方主要担忧的是哪一件。如果上下文仍不足,可在回复中说明自己的理解和处理范围,必要时向编辑提出具体澄清,而不是替对方想象一个无止境的补分析清单。
将“检查样本”改写为:“读取原始样本注释与当前分析名单,逐个核对组织、状态和标识,输出纳入排除表;若数量不一致,停止后续结果更新并查明原因。”这句话给出了输入、动作、输出与异常处理。再将“做独立验证”改成固定候选、指定研究、统一方向和完整结果要求,执行者就能判断自己是否完成任务。
随后做一次依赖排序。独立验证需要候选名单,候选名单依赖差异模型,模型又依赖样本表。因此样本核查没有结束时,可以先检查验证资料可用性,但不应锁定最终验证结论。并行准备与依赖执行可以同时存在,关键是区分哪些工作不会因前一步改变而失效,哪些必须等待。
最后给每条任务写一个失败分支。例如无法获得协变量时,交付应是缺失审计与结论范围调整;验证方向不一致时,交付应包含可比性检查和保留冲突的解释。只有成功分支的任务计划,容易诱导团队不断尝试直到得到预期结果。返修工作应允许证据改变原有判断。
完成练习后,请同事只读任务表,复述每项工作要解决什么以及不能解决什么。若对方把表达验证理解成机制证明,或者把文库数量理解成供体数量,说明任务边界仍需修改。这个小检查能在真正分析之前发现沟通误差,减少最后写回复时才暴露的概念冲突。
代码、数据与继续阅读
下载完整返修复现包:20篇R脚本、整理输入、起始结果、运行说明与版本记录。包含公共观测数据、明确标注的模拟与教学模板;不包含新实施的功能干预实验。解压后先阅读README。
下一篇第02讲:返修前先冻结分析:输入、版本与结果怎样重放。
数据与方法来源
数据与方法核查日期:2026年11月16日。本文为教学二次分析;具体适用范围见正文。
需要把方法用到自己的数据中?
如果你需要把审稿意见转成具体分析任务,可以准备去标识的意见摘要、数据类型、当前脚本和主要证据缺口,沟通适合的核查范围与交付材料。 联系云生信,说明当前研究任务。