生信论文返修实战20讲 · 第18讲 · 整理稿件与提交材料
系列目录:生信论文返修实战20讲(当前第18讲)
- 第01讲:收到返修意见后怎么办?把审稿问题拆成可执行任务
- 第02讲:返修前先冻结分析:输入、版本与结果怎样重放
- 第03讲:样本量为什么对不上?核查纳入、排除与重复测量
- 第04讲:样本太少怎样回应?报告效应、区间与真实限制
- 第05讲:差异分析被质疑:模型、方向和多重检验逐项核查
- 第06讲:要求校正年龄和批次?先判断资料是否支持
- 第07讲:换个阈值还成立吗?做有边界的敏感性分析
- 第08讲:独立验证不一致怎么办?保留全部候选与证据
- 第09讲:富集结果怎样返修?检查背景、方向和贡献成员
- 第10讲:单细胞显著性可靠吗?先认清细胞、文库与供体
- 第11讲:细胞注释与比例被质疑:标记依据和分母怎样交代
- 第12讲:拟时序和通讯怎样改写?避免把推断写成机制
- 第13讲:模型性能过高先查什么?用随机标签识别数据泄漏
- 第14讲:只有ROC不够:校准、误差与简单基线一起评价
- 第15讲:生存分析怎样返修?事件、截点与模型假设核查
- 第16讲:审稿人要求补实验:公共数据能支持到哪一层
- 第17讲:图形与图注怎样修改?展示样本、效应与不确定性
- 第18讲:方法写到哪里才够?参数、版本与数据代码可用性(本篇)
- 第19讲:逐条回复怎么写?把动作、证据和修改位置对应起来
- 第20讲:提交返修前最后一查:正文、回复与附件保持一致
点击目录按篇次顺序学习;文末复现包包含全系列代码与起始数据。
方法写到什么程度,审稿人才知道你实际做了什么
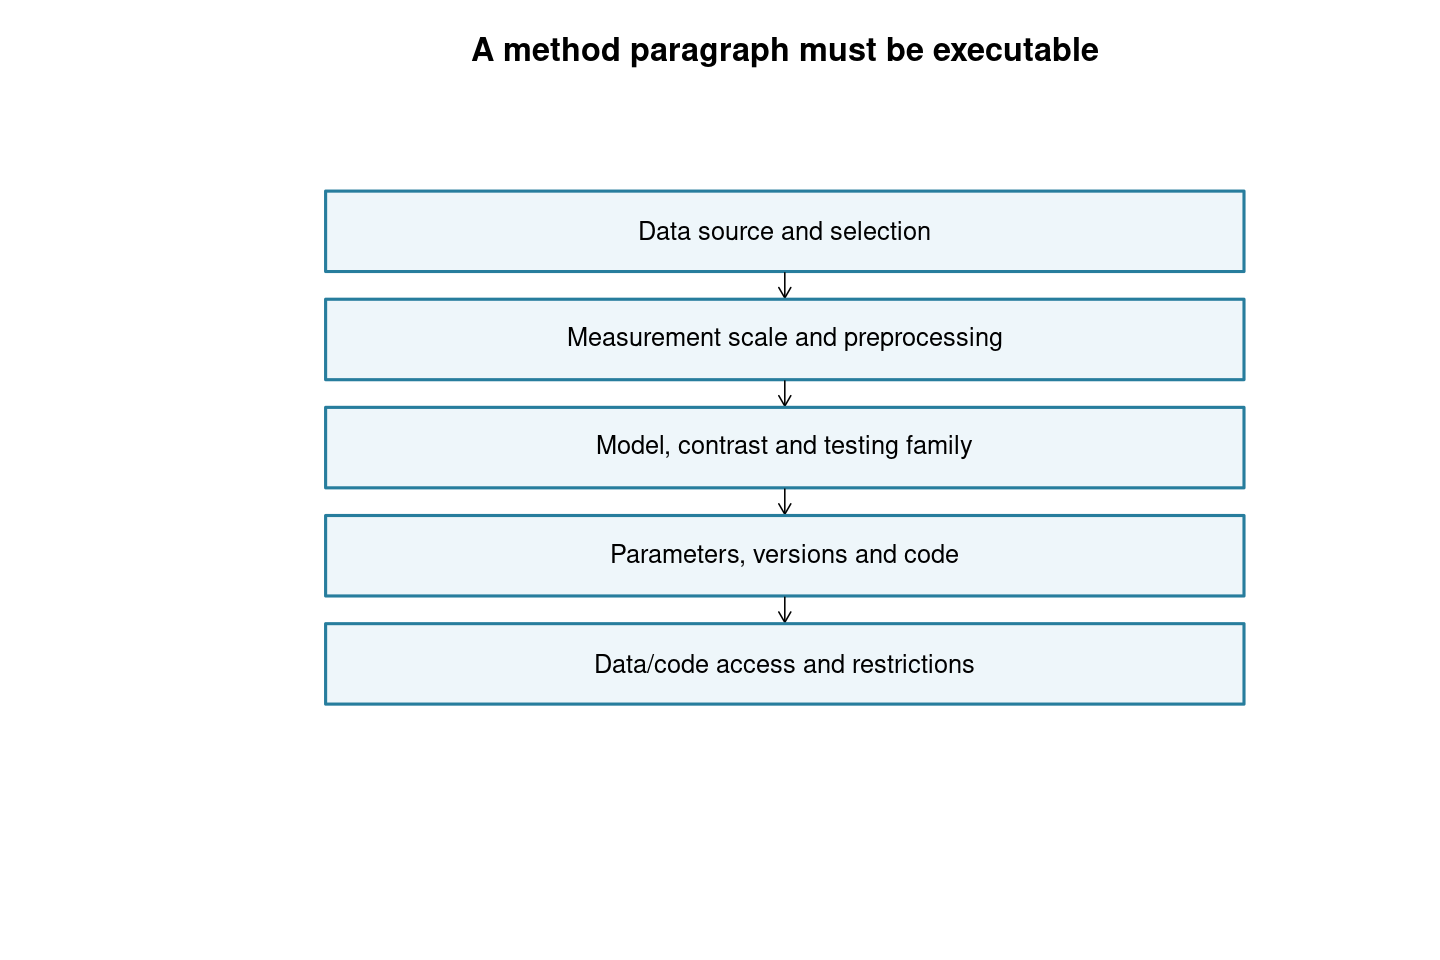
方法段经常写着“采用标准流程分析”,却没有说明标准来自哪里、使用什么输入、哪些参数与默认值不同。返修要求补充可重复性时,最有效的做法是从实际脚本与文件反向生成事实清单,再据此写方法。本篇把前面完成的分析整理为数据、尺度、模型、参数和软件环境五类信息。
教学审稿意见:请补充关键参数、软件版本及数据代码可用性,使读者能够复现主要分析。
本系列有公开组织表达、上皮教学子集、随机模拟和两项公开临床教学数据。它们不是同一批患者,也不能统一写成一个研究队列。方法首先要把资料来源和用途分清,再说明每部分实际完成的处理。某篇引用官方工具文档,不等于本篇已经运行了该工具全部流程。
从真实执行记录提取事实
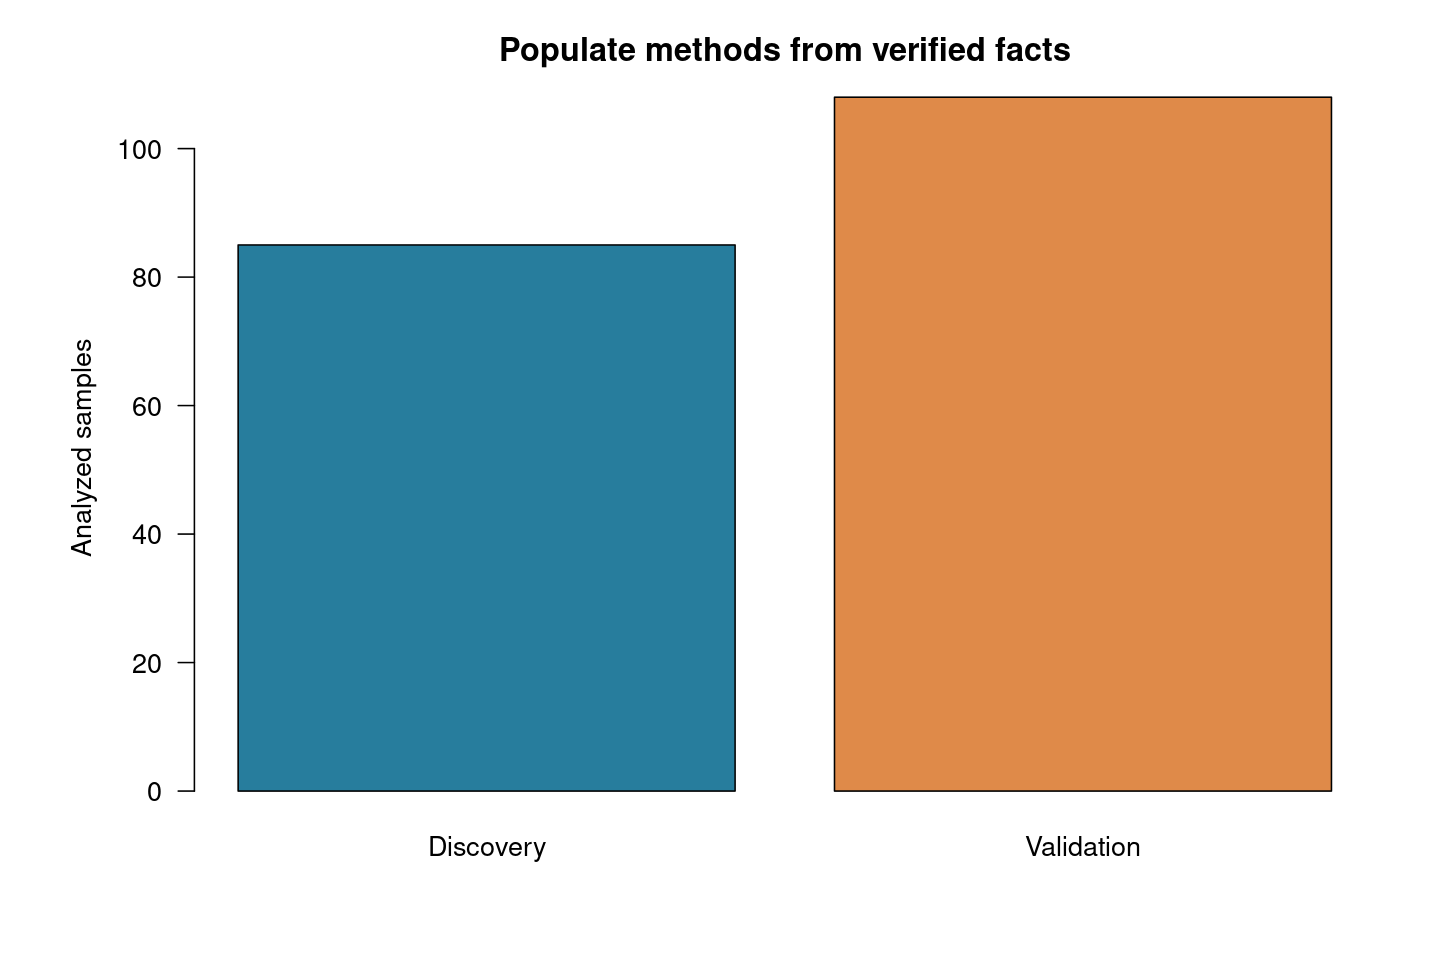
代码输出一张方法事实表,记录发现与验证样本数、比较方向、模型与单细胞范围;另保存包版本、输入清单和会话信息。这些记录来自实际运行环境,不根据网页最新版本猜测。官方页面可能展示更新版本,论文应报告自己真正使用的版本,并引用对应方法。
版本记录不是完整环境锁定。本包提供脚本、数据和实际版本,但不是容器镜像,也不保证未来任意软件组合都能逐位重现。读者安装时需要保持R与Bioconductor依赖相容。诚实说明这一边界,比写“任何电脑均可一键复现”更准确。
方法中还应区分原研究处理与本次二次分析。芯片输入已经经过提交者处理,本次完成基因映射、样本筛选和模型分析;单细胞输入已经归一化取对数,本次选取教学子集并进行描述。不能把原研究执行的测序、质控或实验步骤写成本次新完成。
| 方法部分 | 需要交代的事实 | 对应可检查文件 |
|---|---|---|
| 来源与纳入 | 登录号、组织、分组、筛选 | 样本表与来源记录 |
| 测量与整理 | 尺度、映射、重复汇总 | 整理脚本与输入清单 |
| 统计分析 | 公式、方向、校正范围 | 分篇脚本与完整结果 |
| 软件环境 | R与实际包版本 | 版本表和会话信息 |
| 可用性 | 下载位置、运行入口、限制 | 说明文件与复现包 |
参数不是越多越好,而是能重建关键选择
方法段不必逐行翻译代码,但必须覆盖会影响结论的选择。例如过滤阈值、参考组、随机种子、基因集版本、模型公式和验证分割都很重要。纯粹影响图形字体的参数可以放在脚本中。正文的目标是让读者理解设计与判断,代码则提供完整执行细节。
如果使用默认参数,也应结合软件版本说明,因为默认行为可能变化。若方法名称相同但实现不同,需要明确实际函数和主要设置。引用一个软件包不能替代说明输入类型;尤其是原始计数与归一化表达,错误输入即使用正确函数也可能产生不合适结果。
本系列富集只检查八个固定集合,单细胞只做文库描述,轨迹图是根节点模拟,通讯图是表达可行性。这些范围限制应写进方法,而不是只放在讨论末尾。读者只有先知道做了什么,才能正确理解没有做什么以及结果可以支持多强的结论。
数据可用性不只是放一个链接
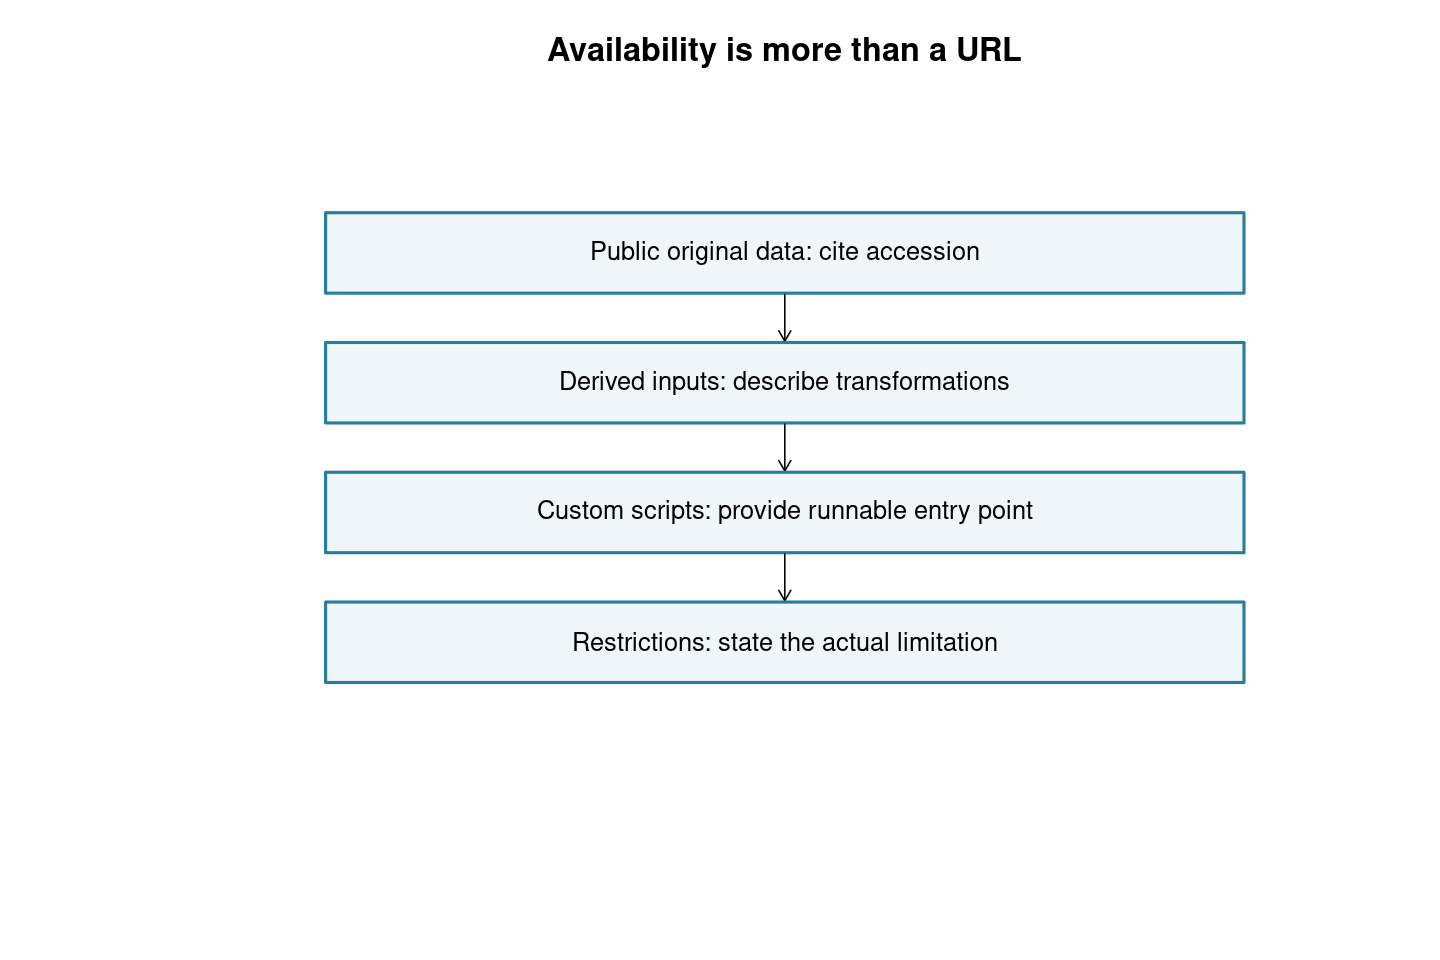
对于公共资料,需要提供准确登录号和实际使用文件,说明筛选与转换;对于派生输入,应给出生成规则和字段含义;对于受限制资料,应说明真实获取路径与限制。不能承诺开放自己没有权限分享的个体信息,也不能把一个无法访问的内部目录写成公开可用。
本包包含整理输入、教学子集、完整分篇结果和原始下载整理代码。用户可直接从整理输入运行,也可按说明重新下载公开资料并整理。两条路径应区分:从整理输入重放主要分析,与完整重建原始处理链,不是同一层级的验证。当前日志记录的是前者的实际运行。
下载包应有清晰目录说明,指出哪些文件是输入、哪些是输出、哪些是教学模拟。若一个文件只是示意模板,应在文件内外都标注。文件名包含“真实”并不能证明来源,仍需要可追踪记录;相反,明确的模拟标识能防止教学资料在转发后被误当作实验结果。
代码可用性应包含可执行入口
一堆脚本没有运行顺序,仍然很难复现。本系列提供完整入口,也保留分篇入口和前序结果。若只运行第八篇,需要第五篇差异结果;若改变发现样本,就要重跑依赖链。说明文件应告诉读者这些关系,而不是让他们通过报错逐个猜测。
实际代码目录使用两位篇次,明确对应第五篇输出。把目录与正文编号统一,是小成本却很有用的可复现改进。
运行日志能够证明某次执行到哪里,却不能单独证明科学正确。需要同时核查输入、结果和图形。异常退出后残留的旧图尤其容易误导,因此应记录运行状态,并在必要时使用新的结果目录。不能仅因为文件存在,就声称所有步骤都已经成功重跑。
运行方法与交付文件
下载文末完整复现包,先解压并保留目录结构,将R的工作目录切换到workbook目录。输入位于data,公共函数位于scripts/common.R,分篇结果位于results。附件保留前序输出,便于单篇学习;如果改变输入、模型或前序参数,应顺序重跑所有受影响步骤,避免新数据与旧结果混用。
Rscript scripts/18.R
本篇脚本会生成三张图和对应表格。先检查日志是否正常结束,再核对实际输出的样本、字段、尺度与正文,不要仅凭文件存在判断运行成功。环境记录来自实际验证,包版本不是自动锁定;安装时需保持R与依赖相容。完整顺序运行入口和原始公开数据整理方法见包内说明,模拟与公开观测数据分别标注。
下面列出本篇完整R脚本。初学者可先原样运行,再在副本中改变一个参数观察影响。保留原始输入,不通过改组别、补造临床字段或删除不合预期的样本来解决报错。遇到缺少文件,首先检查工作目录和前序依赖;遇到数值差异,先核查版本与输入,再解释科学含义。
source("scripts/common.R")
o<-start(18)
# 从真实输入与软件环境生成方法表,不生成未实施的实验方法
meta<-data.frame(item=c("Discovery data","Validation data","Primary contrast","Array model","Multiplicity","Single-cell scope"),value=c("GSE75214: 74 UC + 11 controls","GSE87466: 87 UC + 21 controls","UC minus Control","limma: expression ~ group","BH over tested genes","1800 epithelial teaching cells; library summaries"));tab(meta,paste0(o,"/methods_facts.csv"))
pk<-c("limma","fgsea","org.Hs.eg.db","MASS","pROC","survival");tab(data.frame(package=pk,version=sapply(pk,function(p)as.character(packageVersion(p)))),paste0(o,"/package_versions.csv"));writeLines(capture.output(sessionInfo()),paste0(o,"/sessionInfo.txt"))
files<-list.files("data",full.names=TRUE);tab(data.frame(file=basename(files),bytes=file.info(files)$size,md5=unname(tools::md5sum(files))),paste0(o,"/data_manifest.csv"))
fig(paste0(o,"/fig1.png"),flow(c("Data source and selection","Measurement scale and preprocessing","Model, contrast and testing family","Parameters, versions and code","Data/code access and restrictions"),"A method paragraph must be executable"))
fig(paste0(o,"/fig2.png"),barplot(c(Discovery=nrow(read_m("discovery")),Validation=nrow(read_m("validation"))),col=c("#277D9D","#DF8A49"),ylab="Analyzed samples",main="Populate methods from verified facts"))
fig(paste0(o,"/fig3.png"),flow(c("Public original data: cite accession","Derived inputs: describe transformations","Custom scripts: provide runnable entry point","Restrictions: state the actual limitation"),"Availability is more than a URL"))
本篇脚本从当前环境生成版本与清单。读者在自己的环境运行后会得到自己的版本记录,这可能与本包原始记录不同。不要为了使表格看起来一致而手动改版本号;应记录差异,并在结果改变时评估其影响。
方法与回复怎样修改
教学原稿:“利用R进行生信分析,代码可根据要求提供。”修改稿:“各分析按随附脚本执行,公开资料登录号、筛选规则、输入尺度、模型公式、检验范围及实际版本均记录。复现包提供整理输入、运行入口和结果,原始资料重建方式另见说明。”若数据有访问限制,应据实补充,不能照抄开放承诺。
中文回复示例:“我们补充方法事实表、软件版本、输入清单和运行说明,并区分原研究处理与本次二次分析。下载包包含本系列实际脚本和结果;模拟与未实施实验均有明确标记,未将环境记录描述为完整容器锁定。”
英文示例:“We added verified method details, software versions, input manifests, and execution instructions. Original-study processing is distinguished from our secondary analyses. The package includes the actual scripts and outputs, with simulations and unperformed experiments explicitly identified.”
让一个新读者试着接手
最有价值的检查是让未参与分析的人按说明找到输入、运行一篇并定位结果。若必须通过口头解释才能继续,就把这段解释写回说明。再检查所有路径是否公开或可在解压目录内解析,避免个人绝对路径和临时文件成为隐性依赖。
最后核对方法里的每个动词是否有对应脚本或实验记录。没有执行的步骤不能因为某个模板里写着就保留。下一篇将这些事实组织成逐条回复,练习如何明确说明完成、部分完成和无法完成的事项,并把证据指向稿件中的具体位置。
实操练习:从方法段反向寻找执行证据
逐句阅读方法,每遇到一个动作就寻找对应脚本、参数或实验记录。“进行了批次校正”应有真实批次字段与处理代码,“进行了独立验证”应有冻结对象和评价输出,“排除了双细胞”应有适合的输入与实际执行记录。找不到时先核实是否遗漏文件,不能直接保留模板中的说法。
反过来阅读代码,检查是否存在影响结果却没有在方法中说明的重要选择。例如只纳入某种组织、删除歧义映射、按中位数汇总探针、固定候选面板或仅检查八个集合。方法与代码应互相补足,正文不必包含每一行,但读者应能够理解这些选择为何改变分析范围。
对版本表,区分实际执行版本与官方当前版本。引用方法时使用合适的软件与论文来源,报告运行时版本,不为了显得更新而改成网页上的新版本。若返修升级软件,应重新核查输出并记录变化,而不是假定版本更新只影响速度。环境记录应随最终结果一起冻结。
对数据可用性,尝试在没有个人登录和本地路径的条件下打开公开链接,确认它指向正确资料。受控资料则应说明申请方式和实际限制,不能假称公开下载。派生输入需要字段说明和生成规则,尤其是模拟与教学子集,避免别人误以为它们就是原研究全部数据。
对代码包,确认公共函数、前序对象和依赖说明都在包内。若某个脚本需要先运行其他章节,写出顺序;若包内保留了前序结果,说明修改输入后必须重跑。不要让旧对象成为隐藏捷径,否则读者可能在新输入上得到旧结果,却不知道执行链没有更新。
最后从新目录进行一次交接演练。运行一篇并检查输出,再查看完整入口是否能找到所有脚本。把遇到的问题写回说明,而不是通过临时手工复制文件解决后不留记录。这样形成的方法和代码可用性段落,才能支持真实复核,而不只是满足形式上的一句声明。
对于本系列未实施的内容,也应在方法或限制中清楚说明:没有新功能干预,没有完整通讯网络,没有真实轨迹重建,也没有供体级原始计数差异分析。准确的范围说明可以防止读者根据工具名称自行补出不存在的工作。
代码、数据与继续阅读
下载完整返修复现包:20篇R脚本、整理输入、起始结果、运行说明与版本记录。包含公共观测数据、明确标注的模拟与教学模板;不包含新实施的功能干预实验。解压后先阅读README。
承接第17讲:图形与图注怎样修改?展示样本、效应与不确定性。
下一篇第19讲:逐条回复怎么写?把动作、证据和修改位置对应起来。
数据与方法来源
- PLOS Biology:返修与逐条回复要求
- 发现资料GSE75214
- 验证资料GSE87466
- limma官方文档
- 上皮单细胞GSE116222
- 原研究单细胞处理代码
- Seurat官方:伪重复与样本层级
数据与方法核查日期:2026年11月16日。本文为教学二次分析;具体适用范围见正文。
需要把方法用到自己的数据中?
如果你需要把审稿意见转成具体分析任务,可以准备去标识的意见摘要、数据类型、当前脚本和主要证据缺口,沟通适合的核查范围与交付材料。 联系云生信,说明当前研究任务。