
把外部分箱结果导入 anvi’o 时,一个常见问题是片段名称明明来自同一份组装,程序却提示名称无法匹配。排查时,需要同时理解原始片段、数据库中的分割单元和分箱集合三者之间的关系。掌握这层映射以后,覆盖统计、人工调整和最终序列导出都更容易核对。
本文实际安装 anvi’o 9,用一段公开参考序列构造两个片段,再生成九百条可精确核算的比对记录,完成建库、覆盖分析、分箱导入、集合导出和完整结果汇总。实验保存了真实的分割坐标、平均覆盖深度及最终导出序列的校验结果,读者可以沿着同一套文件逐项复查。
三类文件各自保存什么信息
序列数据库保存片段、基因预测、序列组成以及后续可以加入的注释。覆盖数据库保存样本的比对统计和相关分析结果。分箱集合则描述哪些项目属于同一个箱。把它们配合使用,可以将外部自动分箱结果与覆盖、序列组成等证据放到同一个分析环境中。官方序列数据库说明
其中容易混淆的是,数据库会把较长片段组织成更小的分割单元,也就是 split。外部分箱器通常按原始片段输出归属表,而 anvi’o 的集合经常以这些分割单元为记录对象。因此,一个原始片段可以对应多行集合记录。
建立自己的文件目录时,可以把参考序列、序列数据库、每个样本的覆盖数据库和集合归属表分别保存,并用同一份项目记录关联起来。文件名可以帮助识别用途,实际对应关系还应由参考校验值、数据库信息和原始名称映射共同确认。
本次安装与输入怎样固定
本次从官方发布页安装第九版源码包,在独立的 Python 3.10 环境中运行,读取比对文件的 pysam 版本为 0.24.1。软件包页面和当前开发文档的内容可能继续变化,复现时应同时记录实际版本与运行帮助输出。官方 Linux 安装说明
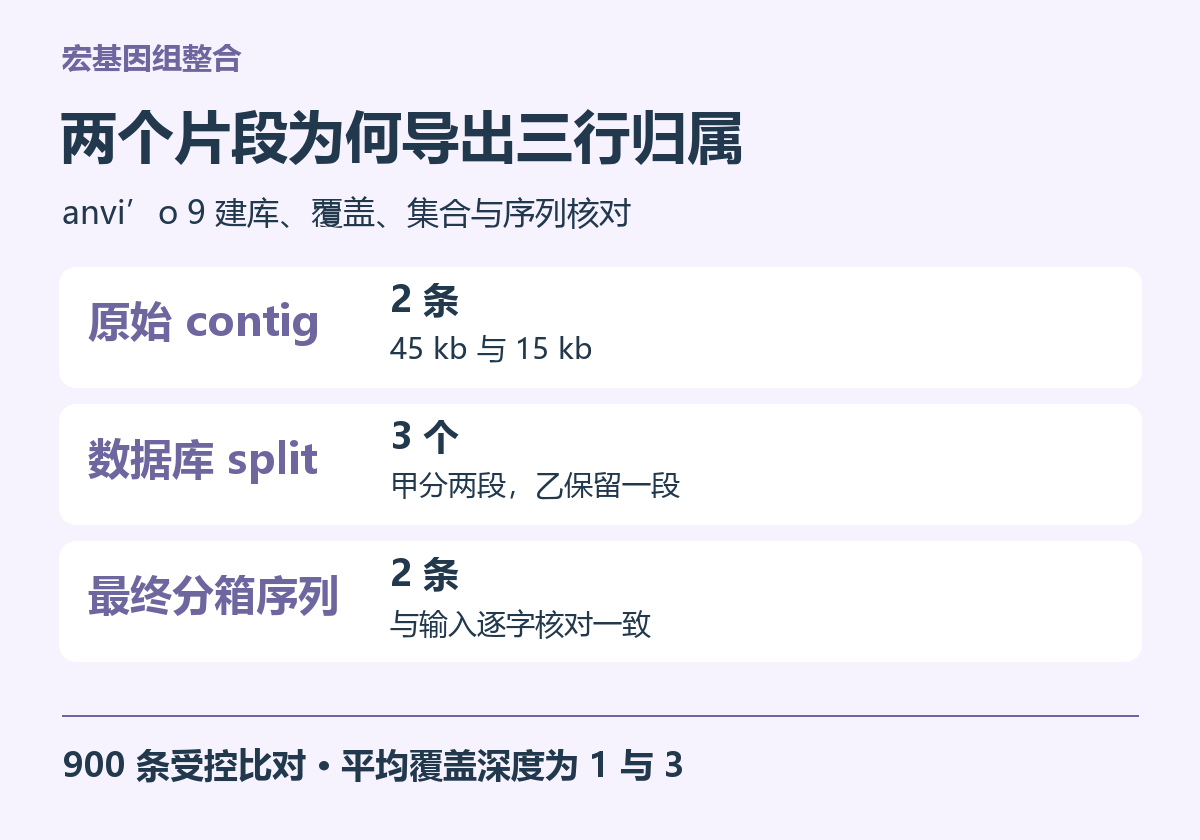
实验使用大肠杆菌参考序列 NC_000913.3 的前六万碱基。前四万五千碱基命名为 contig_A,后面一万五千碱基命名为 contig_B。两个片段都来自固定区间,内容和名称在整个实验中保持一致。
覆盖输入专门设计为可手算的数据。甲片段每一百碱基放置一条完整匹配读段,共四百五十条,因此覆盖深度为一。乙片段每一百碱基放置三条完整匹配读段,也有四百五十条,覆盖深度为三。两者所有位置都有覆盖,合计九百条读段。
这些数据用来验证数据库和集合的对应关系。实际宏基因组分析还会遇到错配、低覆盖、重复区域及多重比对等问题,可以在理解本例之后继续加入相应过滤和诊断步骤。
建库后,两条片段形成三个 split
本次使用正常建库命令,启用默认基因预测,将目标分割长度设为两万,并使用两个线程。程序实际预测了五十六个基因,随后生成序列数据库。官方建库命令说明
anvi-gen-contigs-database \
  -f contigs.fna \
  -o CONTIGS.db \
  -n collection_practice \
  -L 20000 \
  -T 2
数据库中实际出现三个分割单元。甲片段被分成两部分,长度分别为二万二千三百八十四和二万二千六百一十六碱基。乙片段保留为一个一万五千碱基的单元。
| 原始片段 | 数据库中的 split | 起点 | 终点 | 长度 |
|---|---|---|---|---|
| contig_A | contig_A_split_00001 | 0 | 22,384 | 22,384 |
| contig_A | contig_A_split_00002 | 22,384 | 45,000 | 22,616 |
| contig_B | contig_B_split_00001 | 0 | 15,000 | 15,000 |
表中坐标来自数据库,采用从零开始、终点不包含在区间内的表示方式,因此长度可以用终点减起点核对。甲的两个区间相接,总长度恰好四万五千碱基,乙的区间覆盖完整片段。
目标分割长度是组织片段的参数,实际输出还会受到分割逻辑和基因位置的影响。官方建库说明指出,默认分割会考虑预测基因的位置。因此,生成集合时应使用程序实际写出的名称和坐标,避免根据目标长度自行猜测分割数量或拼出名称。
覆盖数据库如何与这些单元连接
接下来对排序并建立索引的 BAM 运行覆盖分析。为了集中检查覆盖与名称映射,本次关闭单核苷酸变异分析,将最小片段长度设为一千,样本名称设为固定值。官方覆盖分析说明
anvi-profile \
  -i sample.bam \
  -c CONTIGS.db \
  -o PROFILE \
  -S CASE1 \
  -M 1000 \
  --skip-SNV-profiling \
  -T 2
实际保存的覆盖结果与设计一致。甲的两个分割单元平均深度均为一,乙的分割单元平均深度为三,三个单元的覆盖检测比例均为一。这个结果说明比对记录、原始片段与数据库分割单元正确连接起来了。
如果实际项目中某些单元完全没有覆盖,应先检查对应片段是否存在于 BAM 参考头、是否通过最小长度条件以及读段过滤要求,再考虑真实的低丰度或缺失。分析顺序可以从原始名称对应关系开始,逐步缩小到覆盖和生物学原因。
同一个组装对应多个样本时,每个样本的覆盖分析都应使用配套的序列数据库。样本之间的名称或输入参考若存在差异,需要先确认来源,再考虑合并覆盖数据库。保留每次比对使用的参考校验值,可以在这里提供直接依据。
错误导入与正确导入的实际差别
我们准备一张两行的外部分箱表,把甲片段放入甲箱,把乙片段放入乙箱。表中第一列采用原始片段名称,第二列采用箱名称。
printf 'contig_A\tBin_A\ncontig_B\tBin_B\n' > contig_bins.tsv
第一次导入时使用默认设置,程序返回错误状态,日志明确指出输入名称与数据库中的项目名称没有交集,并提示检查片段模式。这个错误没有要求重新比对数据,原因可以直接从名称层级找到。
第二次导入加入片段模式参数,程序成功将原始片段归属转换成三个分割单元的归属。甲的两个分割单元进入同一个箱,乙的分割单元进入另一个箱。官方集合导入说明
anvi-import-collection contig_bins.tsv \
  -c CONTIGS.db \
  -p PROFILE/PROFILE.db \
  -C CORRECT \
  --contigs-mode
随后通过正常导出命令核对集合内容。实际导出的表有三行,第一列是分割单元名称,第二列是箱名称。甲对应两行,乙对应一行,与数据库中的分割关系完全一致。
anvi-export-collection \
  -p PROFILE/PROFILE.db \
  -C CORRECT \
  -O exported_collection
这里可以设置一个明确的核对目标。对每个已经分箱的原始片段,查出它在数据库中的全部分割单元,确认这些单元都进入预期的箱。对导出集合中的每个分割单元,再反向查找原始片段,确认没有多出来源不明的项目。
结果汇总怎样回到原始序列
集合导入以后,本次运行完整汇总命令,输出每个箱的序列、覆盖统计、长度指标和可打开的结果索引。官方汇总功能也适合生成供协作者阅读的平面文件。官方结果汇总说明
anvi-summarize \
  -c CONTIGS.db \
  -p PROFILE/PROFILE.db \
  -C CORRECT \
  -o SUMMARY
实际汇总中,甲箱总长度为四万五千碱基,包含一个原始片段,平均深度为一。乙箱总长度为一万五千碱基,包含一个原始片段,平均深度为三。我们读取导出的两个序列文件,将序列逐字与输入比较,均完全一致。
这项核对还说明,集合中的三行分割单元归属,与最终两个原始片段的导出数量能够同时成立。统计结果时,应注明自己数的是原始片段、分割单元还是箱。若在同一张报告里混用这些数量,容易让人误以为分析过程中增加或丢失了片段。
本次汇总关注成员、序列和覆盖。功能注释、分类和基于标记的质量评价,需要相应证据加入数据库后再解释。拿到一个汇总目录时,可以先检查它实际包含哪些结果文件,再据此组织后续分析。
如何区分深度、覆盖范围和成员数量
本例还可以用来训练三个指标的读法。甲乙两个片段的覆盖检测比例都是一,因为每个位置至少被一条读段覆盖。它们的平均深度分别是一和三,因为乙的每个位置都有三条重叠读段。同样的覆盖范围可以对应不同深度,所以汇总表中的两个字段应该同时保留。
计算总量时还要保留长度权重。甲片段有四万五千个位置,每个位置深度一,累积深度为四万五千。乙片段有一万五千个位置,每个位置深度三,累积深度同样为四万五千。因此两个片段虽然平均深度不同,本次消耗的比对碱基数相同,这也与各自四百五十条一百碱基读段相符。
这组关系可以形成一个很小的验算链。先用片段长度乘平均深度,得到覆盖的碱基总量,再与比对记录的有效对齐长度相加结果比较。本次采用完整匹配,计算过程十分直接。真实数据若包含软剪切、缺口、重复比对及不同过滤口径,需要按照实际保留的对齐部分重新定义这条核对关系。
项目规模扩大后,可以给每个原始片段保留一行基本信息,记录名称、长度、序列校验值和最终箱名称。另外单独保存分割映射表,用父片段名称连接两个层级。这样既能按原始片段统计最终序列,也能按分割单元检查局部覆盖异常,成员数量变化发生在哪一层会更加清楚。
自己的数据遇到名称不匹配时怎样排查
第一步,取出输入归属表中的几个名称,和数据库实际保存的名称比较。如果输入是原始片段,数据库项目是带分割后缀的名称,可以核对是否需要片段模式。如果两边的前缀都完全不同,则应继续检查是否用了另一份组装或另一版重命名文件。
第二步,检查归属表是否为正确的两列表格,以及每行表示什么对象。片段名与箱名放反、空格替代制表符、给数据增加表头后忘记查看格式要求,都可能影响导入。可以先用少量明确可核对的成员形成小表,再确认完整表的数据组织方式。
第三步,核对同一个项目是否被重复赋值到不同箱。外部结果合并之后,这类冲突可能来自不同分箱器或不同人工版本。需要先确定采用哪套成员归属,再导入对应集合。每次修改保存独立集合名称和成员变化表,可以帮助回查一个片段为何被移动。
第四步,导入成功后实际导出一次集合,再检查成员数量和分割映射。运行完成状态只能说明命令接受了输入,导出的实际成员才能回答哪些对象进入了哪个箱。最后对需要用于后续分析的序列做长度和校验值核对,可以把整个过程连成可追溯的链条。
anvi’o 的价值在于能把多种证据与分箱集合放到同一个数据体系里。相应的学习成本也来自这些对象之间的对应关系。先用一份小数据把名称、坐标、覆盖和导出序列全部连通,再扩大到复杂项目,能够更快定位真实问题。
本次实跑脚本会生成全部教学输入,保存错误导入的日志、正确集合的实际成员、三个分割单元的坐标和最终序列校验结果,读者可以照着复现完整过程。下载实跑脚本与本次结果
当分析需要同时管理多个样本的覆盖数据库、注释和精修结果时,可了解云生信的生物信息学分析计算服务。


