
把多个分箱结果整合起来以后,同一条组装片段可能同时出现在两个候选箱中。接下来应该把它保留给哪个箱,或者是否应当从两个箱里都删除,会直接影响最终序列集合。只看输出目录里还有多少个文件,很难发现这种变化。
本文围绕 metaWRAP 精修流程中的共享片段处理环节展开。我们安装独立的 Python 2.7.15 环境,运行作者仓库未经修改的原始脚本,用六条可逐字核对的教学序列完成三组对照。实验实际改变了共享片段的去向,也测量了每组输出的成员、长度、重复归属和丢失情况。
本次完整执行的是共享片段去重阶段。输入完整度和污染度是专门设计的教学数值,用来控制候选排序。本例没有运行完整的原始读段处理、组装及 CheckM 质量评估,下面的结果用于解释成员选择规则。
先弄清楚精修在处理哪一层问题
同一份组装可以交给不同分箱器,得到多套候选基因组。它们可能对大部分片段达成一致,也可能把边界片段放进不同的箱。整合流程需要同时处理候选之间的重叠、质量评价和最终成员归属。
metaWRAP 提供从读段处理到宏基因组分析的一组模块,其中分箱精修模块可以接收多套候选分箱,结合质量统计进行整合。使用时应区分候选版本的选择与某条共享片段的处理,这两个动作都会改变最终输出。项目主页
本文聚焦后一个动作。进入这个阶段以后,程序已经拿到一组候选箱和对应统计表,接下来根据片段名称查找重复成员,再决定输出时保留哪份归属。理解这个局部步骤,能帮助读者解释完整流程结束后某条片段为何消失,或者为何只留在另一个箱中。
准备输入时,几套分箱应保持与原始组装的名称对应关系。如果同一条片段在不同候选目录里使用了不同名称,就需要先恢复统一映射。对于来源不同的独立组装,即使某些序列相似,也需要先明确如何建立同一性的证据和对应关系。
六条序列怎样形成七条成员记录
本次驱动使用固定随机种子生成六条序列,每条都是一千碱基,名称分别为三个甲类片段、两个乙类片段以及一条共享片段。共享片段在两个输入箱中具有完全相同的名称和内容。
甲箱包含四条序列,总长度四千碱基。乙箱包含三条序列,总长度三千碱基。如果把两个文件的记录数直接相加,会得到七条记录。如果按名称和序列内容核对并集,则只有六条唯一片段,总长度六千碱基。
| 输入箱 | 片段名称 | 文件内总长度 | 教学完整度 | 教学污染度 |
|---|---|---|---|---|
| Alpha | A1、A2、A3、shared | 4000 bp | 92 | 2 |
| Beta | B1、B2、shared | 3000 bp | 90 | 1 |
这个简单输入提供了两个核对基准。第一,合理的去重输出可以保留六条唯一片段,同时消除重复归属。第二,如果选择将歧义成员全部删除,输出会少掉共享片段,唯一序列总长度降到五千碱基。两种结果都能由实际成员列表直接计算。
教学完整度和污染度只负责触发预期的排序差异。这些短随机序列没有被赋予真实基因组质量含义,也不能据此判断哪一个箱在生物学上更正确。复现时保留这一输入说明,才能把算法行为和质量测量区分清楚。
原始脚本用什么数值决定归属
本次固定作者仓库提交 08d8379d0193b0e29785b256b00602f4fdf4b601,运行其中的 dereplicate_contigs_in_bins.py。脚本校验值记录在下载包中,方便确认读取的是同一个版本。
在该脚本中,每个箱的评分由完整度、污染度和一个很小的连续性项组成。实际输入统计表的第六列是长度指标,因此使用时还应核对文件列顺序。本次运行的原始脚本
score = completeness - 5 * contamination + 1e-10 * N50

Alpha = 92 - 5 * 2 + 1e-10 * 1000 = 82.0000001
Beta  = 90 - 5 * 1 + 1e-10 * 1000 = 85.0000001
甲的完整度输入更高,但乙的污染度输入更低。按照本次评分公式,乙的总分高出三分,因此共享片段会留在乙箱。这个结果说明,在解释成员选择时,应把完整评分列出来,单独比较完整度很容易误判程序行为。
本例两个箱的连续性指标相同,因此最后一项对排序没有影响。复查自己的项目时,可以分别列出三项的贡献,检查究竟是哪一项决定了差距。如果候选评分很接近,还需要结合原始成员、覆盖和注释证据理解这种微小差异。
脚本针对重复的片段名称处理归属。它本身没有在这个步骤重新进行序列比对,也没有逐一测量共享片段与各个箱的生物学一致性。因此,在它前面保持正确的名称与序列映射,是后续解释成立的条件。
第一组实跑,保留给分数更高的箱
下载包中的驱动先生成输入序列和统计表,然后通过 Python 2.7 调用原始程序。下面展示实际使用的调用形式,统计文件和输入目录均由驱动创建,输出放入独立目录。
python2.7 dereplicate_contigs_in_bins.py \
  best_score.stats input best_score
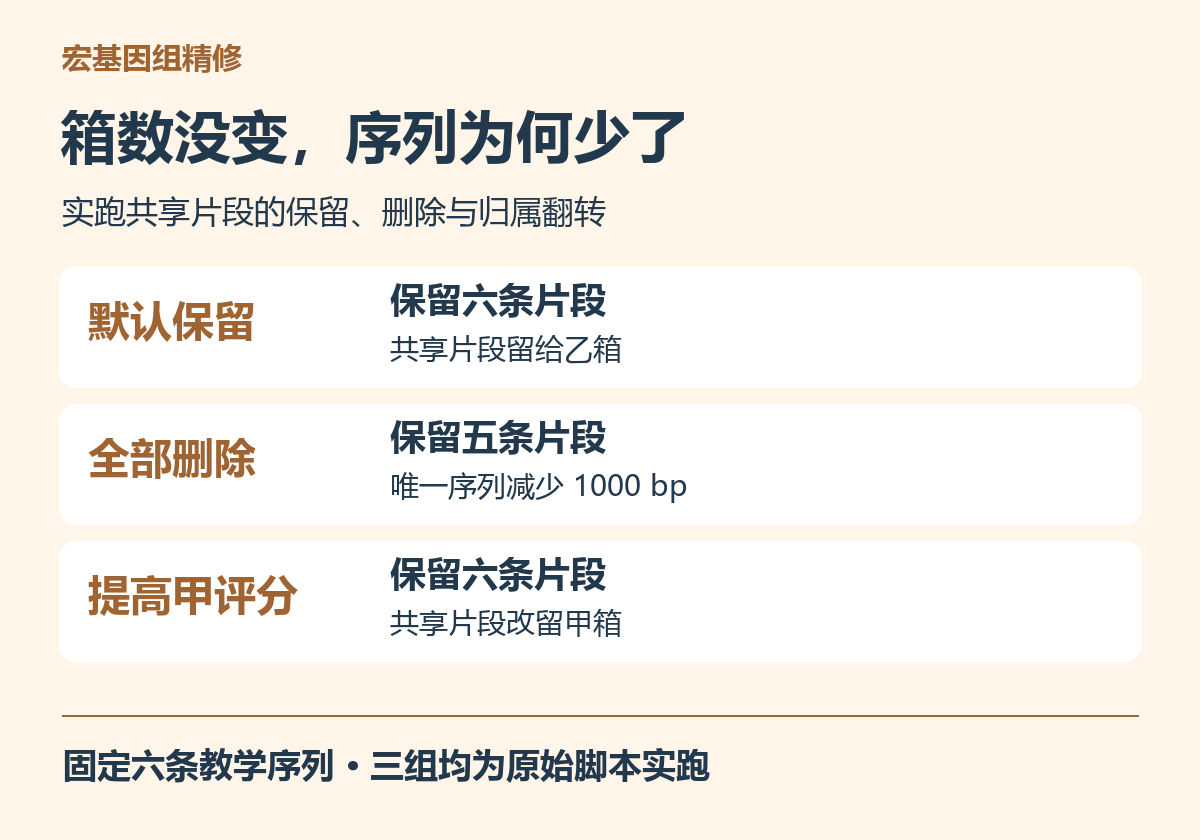
输出甲箱只剩三个独有片段,总长度三千碱基。乙箱保留两个独有片段和共享片段,总长度也是三千碱基。核对两个输出文件后,共得到六条唯一片段,没有跨箱重复,也没有任何输入片段从并集中丢失。
这组结果可以回答一个经常出现的疑问。甲箱变短了,并不意味着整套结果损失了相同长度的唯一序列。共享片段仍然保存在乙箱,集合层面的序列总量保持六千碱基,只是同一条片段的重复归属被消除了。
因此,报告精修前后的变化时,可以同时给出每个箱的长度变化和整个集合的唯一序列变化。前者反映箱的成员调整,后者反映最终保留了多少内容。把这两个层次分开,才能解释同一项处理为何既让某个文件缩短,又没有造成集合序列丢失。
第二组实跑,从所有箱中删除共享成员
第二组保持序列和评分表不变,只给原始脚本增加删除模式参数。该阶段把重复出现的成员标记为不保留,随后写出每个箱剩余的序列。
python2.7 dereplicate_contigs_in_bins.py \
  remove_both.stats input remove_both remove
实际输出中,甲箱保留三个片段,乙箱只剩两个。两者总共五条唯一片段,长度五千碱基。共享片段出现在输入并集与输出并集的差集中,程序保存的丢失名单也明确记录了它。
完整精修模块中,官方提供删除歧义片段的选项,将这类处理接入流程。本次验证的是它调用的成员去重行为,选项含义可以在固定版本的模块帮助与源码中查阅。分箱精修模块说明与实现
这里减少了一千碱基,约占输入唯一序列总量的六分之一。如果只比较文件数量,两组结果始终都是两个箱,完全看不出这一差异。即使在真实项目中损失比例较小,也值得保留具体丢失名单,检查这些片段是否带有需要解释的功能或标记。
本例只测量了成员删除后的序列变化。删除是否有助于改善实际污染估计,取决于片段内容及质量评估证据,需要对最终序列重新评价后再作判断。
第三组实跑,只改变评分就能翻转归属
第三组仍然使用同样六条序列,保留默认归属模式。我们把甲箱的教学完整度改为九十八、污染度改为一,乙箱的两个数值保持不变。
甲的评分升到九十三点零零零零零零一,超过乙的八十五点零零零零零零一。实际结果中,共享片段转而留在甲箱。甲箱恢复四千碱基,乙箱缩短到两千碱基,集合仍然保留六条唯一片段。
| 实跑条件 | shared 最终去向 | Alpha 长度 | Beta 长度 | 唯一片段总数 | 丢失片段 |
|---|---|---|---|---|---|
| 初始评分,默认保留 | Beta | 3000 bp | 3000 bp | 6 | 无 |
| 初始评分,全部删除 | 无 | 3000 bp | 2000 bp | 5 | shared |
| 提高 Alpha 评分 | Alpha | 4000 bp | 2000 bp | 6 | 无 |
这项对照把序列内容固定下来,只改变输入质量数字,就能观察到归属翻转。它说明质量统计表属于决定结果的分析输入,应当和对应的候选序列一起保存。重新运行质量评估或者改用另一版候选文件后,都需要确认统计表与序列仍然配套。
在真实数据中,候选箱的质量变化通常伴随序列内容变化,情况会更加复杂。本例故意把二者分开,便于观察程序对评分的响应。读者复现时也可以采用相同思路,每次只改变一个明确因素,再比较实际成员差异。
给自己的结果做一次成员审计
最基础的检查是建立一张片段到箱的对应表。每读到一条序列,就记录它的名称、序列长度和所在箱。如果同一个名称出现多次,还应核对内容是否一致,避免把命名冲突误当作真实共享。
然后分别计算输入和输出的唯一片段集合。输出中出现次数大于一的成员是残留重复归属,输入中存在而输出中没有的成员是丢失对象,输出新增而输入不存在的名称则需要回查来源。下载包中的驱动实际完成了这些检查。
本次还对每条保留序列做了逐字比较,确保输出内容与输入一致。这一步能确认实验观察到的是成员保留和删除,而没有同时发生无法解释的序列修改。对于规模更大的文件,可以在一致的序列标准化规则下记录校验值。
审计表最好包含改变前后的箱名称和变化原因。例如共享片段原来同时属于甲乙两箱,默认运行后只属于乙,原因是乙的输入评分更高。这样的记录比只保存最终目录更容易支持复查,也便于向合作者解释后续功能统计为什么发生变化。
复现时最容易踩到的三个问题
第一个问题是解释器版本。这个固定提交中的脚本使用旧版 Python 写法,本次为它单独安装了 Python 2.7.15,并由现代 Python 驱动组织输入和检查结果。直接用新解释器执行原文件,可能在真正读取数据之前就遇到兼容性问题。
第二个问题是表格字段。箱名称必须和输入文件对应,完整度、污染度和长度指标必须处于脚本期待的位置。把其他软件的质量表直接改个文件名,无法保证列意义已经匹配。转换时应明确每一列来自哪里,并保留转换前后的文件。
第三个问题是名称的稳定性。这段程序读取 FASTA 标题来识别成员,因此应统一标题格式,避免一份文件保留描述文字、另一份只保留短编号。对同一份组装建立一次明确的命名映射,再让各套分箱沿用,可以减少这类难以察觉的差异。
输出目录也应当与实验条件一一对应。本次三组结果分别保存,没有把上一次输出当作下一次输入。这样可以直接比较共享片段去向,避免旧文件残留或条件混用影响判断。
metaWRAP 的便利在于将多种分析步骤组织成可衔接的流程,代价是需要同时理解外部程序、质量表和成员处理规则。把关键中间结果留下来,再选一个具体问题做小规模对照,通常能更快解释完整项目中的变化。
本次下载包包含教学序列生成脚本、原始程序获取方式和三组实际测量结果,保留了软件版本、源码提交、评分和输出成员,可以复现并自行修改教学条件。下载实跑脚本与本次结果
当项目需要保存多套候选分箱、质量评价与精修结果,并持续开展功能分析时,可了解云生信的生物信息学分析计算服务。


