**摘要:**多模态不是把更多文件放在一起,也不是给分析加上AI标签。本文从RNA、蛋白、染色质和病理图像出发,说明哪些数据能够联合分析、常用方法怎样选择、何时值得增加投入,以及如何避免样本错配、信息泄漏和结果过度解释。
先看结论
生物信息学中的多模态,就是把不同测量方式或不同信息层面的数据联系起来,共同回答一个明确的研究问题。
例如,研究同一个肿瘤,可以同时看基因表达、蛋白标记和病理形态。它们像几位观察角度不同的研究者:有人观察分子活动,有人观察细胞表面,有人观察组织结构。联合分析的价值,是让这些信息互相补充,而不是简单投票。
但多模态不保证比单模态更准确。数据没有正确对应、样本量不足、批次与疾病分组混在一起时,增加数据和复杂模型反而可能放大误差。开始前,先问一句:新增的这类数据,准备解决原来哪个具体问题?
一、先分清:多模态、多组学、多数据集有什么区别?
1. 什么是“模态”?
“模态”通常表示数据的测量形式或信息来源。在生信研究中,常见模态包括:
| 数据类型 | 主要提供什么信息 | 不能直接替代什么 |
|---|---|---|
| 转录组 | RNA表达及其变化 | 不等于蛋白丰度、蛋白活性或细胞功能 |
| 蛋白质或蛋白标记 | 蛋白或所选标记的丰度 | 不能单独说明所有上游调控过程 |
| 染色质可及性 | 哪些基因组区域更易被接近 | 开放区域不等于对应基因一定高表达 |
| 病理、显微图像 | 形态、组织结构与局部环境 | 不能直接当作完整的分子测量 |
| 空间位置及相关测量 | 信号在哪里、与哪些区域邻近 | 空间相邻不自动等于直接相互作用 |
| 临床或表型信息 | 个体背景、处理、疗效或结局 | 不替代实验设计,也不自动证明因果 |
这些数据之间可能互补,也可能不一致。比如RNA升高而蛋白没有同步升高,不必立刻认定其中一份数据错了,还要考虑测量时间、调控层次、技术噪声和样本组成。
2. 多组学是多模态的一种常见形式
转录组与蛋白质组联合分析,既可以称为多组学,也可以放在多模态框架下讨论;病理图像与转录组联合分析,则超出了单纯组学数据的范围。不同研究领域的用词并不完全统一,阅读论文时应看清作者实际用了哪些数据,而不是只看标题中的“多模态”。
3. 多个文件,不一定是多个模态
把三个医院的RNA-seq数据整合,通常仍是同一模态的跨队列分析。把一个表达矩阵拆成训练集、验证集和测试集,也不会产生新的模态。判断标准是信息来源和测量方式,而不是文件数量或分析图数量。
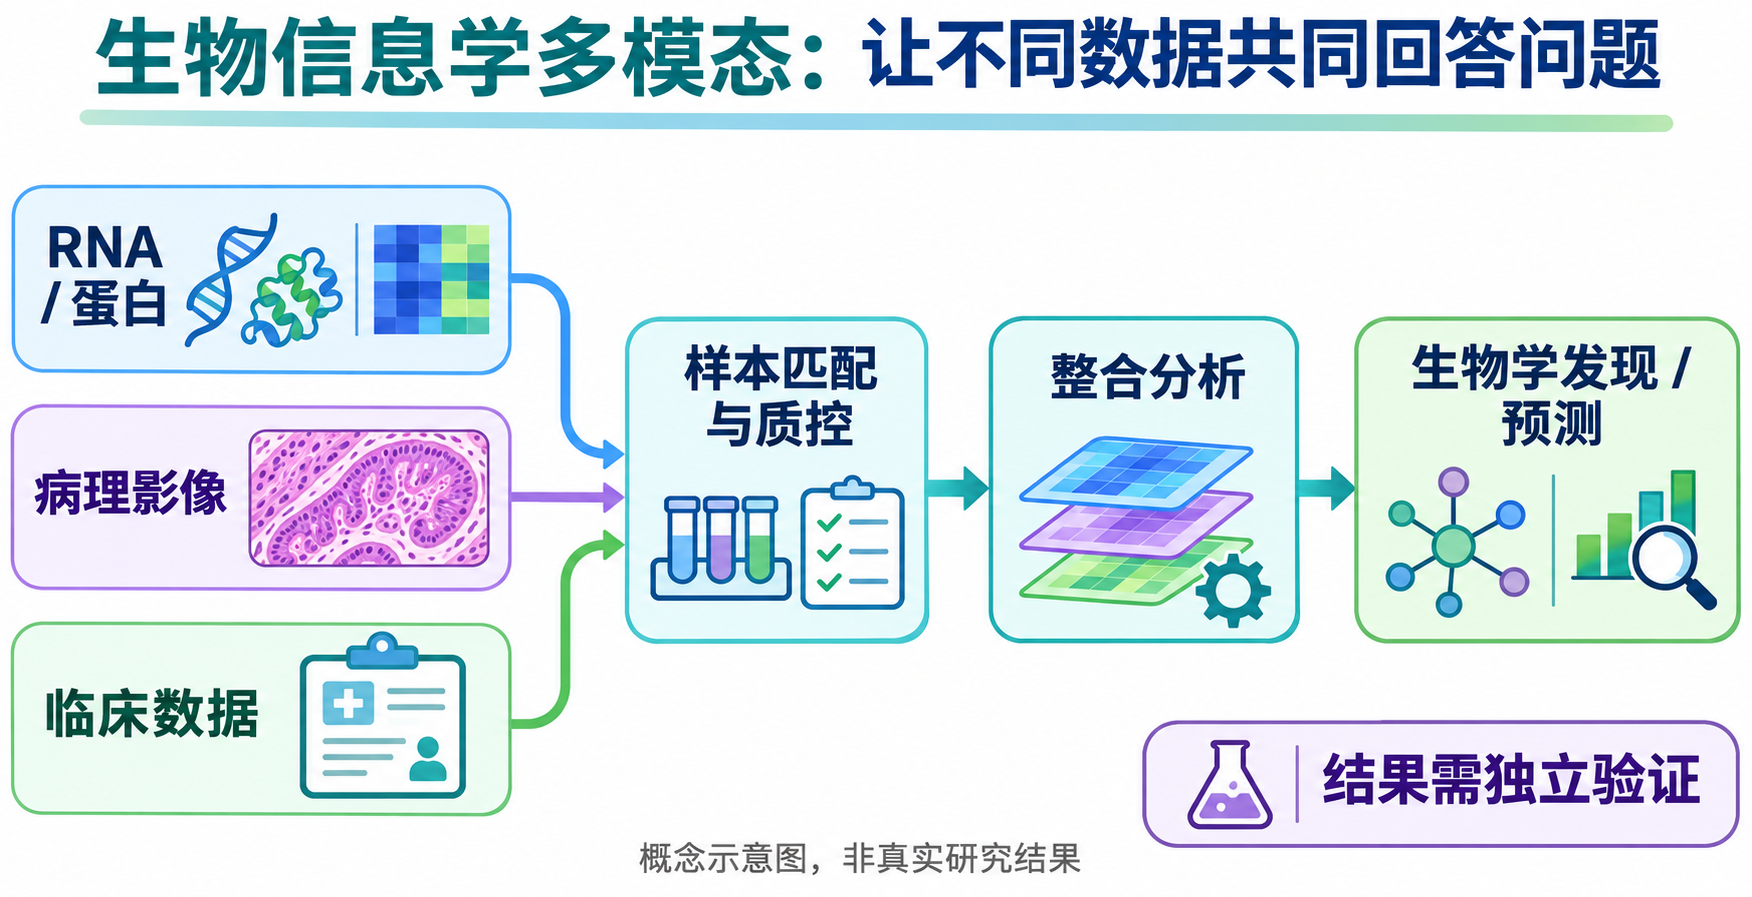
图注:RNA表达、蛋白标记、染色质可及性、病理图像与临床信息,从不同层面描述研究对象。是否可以联合分析,取决于样本对应关系和研究目标。概念示意,非真实实验数据。
二、比选算法更重要:这些数据究竟对应到哪一层?
同一细胞配对:能够直接比较同一个细胞的不同测量
例如,一次实验对同一细胞同时测量RNA与蛋白标记。细胞条形码提供对应关系,但仍要检查条形码处理、样本拆分与质控结果。不能因为两份矩阵列数相同,就认为每列都对应同一个细胞。
同一样本或患者配对:能对应个体,但不一定能对应细胞
一个患者的病理切片和肿瘤转录组可以在患者层面建立关联。但两份材料可能来自不同取样区域,不一定具有完全相同的细胞组成;治疗前后的材料也不能直接当作同一时间的测量。分析表应同时保留个体、样本、组织部位、时间和批次信息。
非配对或部分配对:可以研究,但假设更多
有些细胞只有RNA,有些只有ATAC,还有一部分同时具备两类测量。此时需要支持相应数据结构的方法,而不是强行把矩阵拼起来。跨模态映射依赖共同结构和模型假设,整合后看起来混合,并不证明每个细胞都被正确匹配。
**一个常见错误:**把甲队列的RNA与乙队列的蛋白数据按行号或样本数量对齐。它们即使研究同一种疾病,也不能凭空成为“同一批样本”。这类项目应明确是跨队列证据整合,而非个体级配对分析。
三、多模态能用来解决哪些实际问题?
场景1:单细胞RNA与蛋白标记一起帮助识别细胞
CITE-seq使用带有寡核苷酸标签的抗体,将特定蛋白标记检测与单细胞转录组测量结合起来。它提供同一细胞的两类信息,可用于细胞识别与状态研究。但检测范围取决于抗体面板,不能写成“获得了全部蛋白质组”。[1]
这个例子的启发是:如果RNA对某些细胞群的区分不充分,而已有可靠的蛋白标记,增加相应测量可能有实际价值。反过来,如果抗体背景高或目标标记选得不合适,数据多一层不等于证据强一层。
场景2:RNA与染色质数据一起研究细胞状态
RNA更接近表达输出,染色质可及性提供调控状态的另一种线索。联合分析可以帮助研究者把细胞状态与候选调控区域联系起来。不过,从开放区域到目标基因,再到功能机制,中间仍有多层推断。一个区域开放、附近基因表达变化,不足以单独证明直接调控关系。
MultiVI针对多组学及单模态单细胞数据学习联合表示,也能对未测模态进行推断。[4] **推断出来的RNA或可及性数值是模型估计,不是补做了一次实验。**用于后续研究时,应标记来源,评估不确定性,并避免用模型自己生成的数据“验证”模型自己提出的结论。
场景3:病理图像与分子数据共同研究患者结局
病理图像包含组织结构和形态特征,分子数据提供另一层信息。Chen等人的原始研究在14种癌症中开展病理—组学融合与预后研究,展示了这一研究路径。[5] 这不是“所有肿瘤都应该上多模态”的证据,也不意味着相关模型可以直接用于临床决策。
真正值得关注的是:在同样的患者划分下,联合模型是否比图像模型、分子模型,以及必要的临床基线更有用;换到不同中心、不同扫描和检测条件后,效果是否仍然保持。
四、常用分析思路有哪些?不要把工具当成万能答案
1. 特征层融合:先整理特征,再合并分析
直观做法是将不同模态的特征整理后合并,用于后续建模。优点是容易理解和建立基线;难点是不同数据的量纲、稀疏性和特征数量可能相差很大。一个模态有几万个特征,另一个只有几十个指标,直接拼接可能让模型偏向某一侧。
实践中需要考虑标准化、特征选择和正则化,并确保这些步骤没有提前使用测试数据。不是把矩阵“合并成功”,就完成了合理融合。
2. 表示层融合:提炼共同结构,也保留差异
MOFA+通过潜在因子刻画多模态数据的主要变化,帮助探索哪些变化跨模态共享,哪些更具有模态特异性。[3] 潜在因子可以理解为若干主要变化方向,但不能仅凭一个因子与疾病分组相关,就把它命名为某条确定机制。
解释时应同时检查因子与批次、样本质量和其他背景变量的关系,再看对应特征是否支持生物学解释。
3. 邻域融合:综合不同模态对细胞关系的描述
Seurat的加权最近邻思路,即WNN,针对同一细胞的多模态测量,学习不同模态对局部细胞关系的相对贡献,而不是简单等权相加。[2] 它适合的问题和输入结构都有边界,不能把来自不同个体、没有细胞对应关系的数据直接视为标准配对输入。
4. 预测层融合:先分别建模,再组合结果
不同模态可以先各自建立模型,再组合预测。这样便于观察单模态表现,但组合权重也需要在开发数据中确定,不能反复查看测试集后调整。实际使用时如果某种模态拿不到,系统怎样处理,应在方案阶段就考虑,而不是等模型上线才发现缺数据。
上述几类是理解方法的框架,并非互斥分类。复杂方法可能同时包含多种策略。选工具时,优先核对研究目标、配对结构、输入格式和验证方式,不宜单凭“用了深度学习”判断先进程度。
五、多模态的优点:什么时候增加数据真的值得?
**补充信息盲区。**当原有数据缺少某个关键维度时,新增测量可能提供真正的新信息。例如形态变化与分子变化结合,有助于把组织表现和分子线索联系起来。
**提供跨层面的支持。**一个候选现象同时得到不同测量的支持,可能更值得进一步验证。但不同模态也可能受同一混杂因素影响,不能把“多份支持”直接当作独立证据或因果证明。
**帮助识别异质性。**同一疾病名称下可能存在不同细胞状态或组织特征。联合信息有机会细化描述,但新分出的亚群必须检查稳定性,不能只凭聚类图就宣布发现新亚型。
**改善某些预测任务。**如果新增模态提供原有数据没有的信息,联合模型可能改善表现。但应报告改善幅度、波动和使用成本,而不是只挑最好的一次结果。若增加昂贵检测后收益很小,简单模型反而可能更适合实际任务。
六、多模态的缺点:最容易在哪些地方出问题?
1. 费用增加,但有效样本可能减少
有100位受试者的RNA数据,不意味着就有100位受试者的完整多模态数据。如果只有40位同时具有另一种测量,限制在完整配对样本上分析时,可用样本会减少;改用缺失模态方法,也需要检查缺失原因和相关假设。
例如,只有病情较重的人接受某项检测,缺失就不是简单随机的。模型可能利用检测是否存在来判断分组,而非学到希望研究的生物学关系。
2. 批次校正可能不足,也可能过度
不处理技术差异,模型可能学到平台特征;过度追求不同批次完全混合,又可能抹去真实生物学差异。应结合实验设计检查整合前后结果,既看技术因素是否减弱,也看已知生物结构是否保留。不能以“UMAP混得越均匀越好”作为唯一标准。
3. 信息泄漏会制造虚假的高准确率
同一个患者有多张切片、多个时间点或许多细胞,如果这些相关数据同时进入训练集和测试集,模型可能已经见过该患者的信息。预测任务应按真正独立的单位划分数据。若目标是推广到新患者,就不能把同一患者的不同细胞当作互不相关的独立测试个体。
同样,先用全部数据筛选与结局相关的特征,再划分训练测试,也会让测试信息提前参与开发。特征筛选、参数选择和阈值调整,应纳入正确的训练与验证流程。
4. 可解释不等于有因果证据
模型给某个基因、区域或图像块较高权重,只说明它在当前模型中有贡献,不能直接证明它导致疾病。重要性还可能受相关特征、数据分布和模型结构影响。机制主张需要与研究设计及独立实验相匹配。
5. 数据、算力和维护复杂度一起上升
多模态项目不仅多几个输入文件,还增加匹配、质控、版本管理、计算和解释工作。模型升级、注释版本变化或新增数据后,旧流程能否重复运行,也是项目成本的一部分。
七、一个可以照着讨论的项目示例
以下为教学设计示例,不是云生信已完成项目,也不代表已取得任何效果。
假设课题组有一批患者的病理切片、肿瘤RNA数据和随访记录,想研究联合信息是否有助于预后预测。
**第一步,明确预测发生在什么时候。**例如使用治疗前能获得的信息预测之后的结局,就不能把后续治疗反应或随访中才出现的变量作为当时的输入。否则即使模型分数很高,也没有对应的真实使用场景。
**第二步,建立患者级数据清单。**一行记录一份样本,通过患者编号关联切片、RNA与结局;记录采样时间、组织来源、检测批次、缺失原因和可用文件。多个切片属于同一患者时,不能擅自增加独立患者数。
**第三步,分别检查质量。**图像检查组织区域与明显伪影;RNA检查样本质量及异常;随访核对时间起点、事件编码和删失含义。先处理明显问题,再讨论复杂融合。
**第四步,用同样的数据划分比较。**至少建立与目标相符的单模态基线和联合模型。若临床信息本身很有预测力,也要考虑相应基线,避免把已有信息的贡献误算到新增模态上。
**第五步,区分“分得开”和“估得准”。**例如模型能够较好区分风险高低,并不等于给出的风险概率准确。预后任务需要结合时间与删失选择指标;还应考虑校准、置信区间以及不同亚组的稳定性。
**第六步,作出明确的下一步判断。**联合模型稳定优于基线,可以继续外部验证;只在训练数据更好,就先查过拟合和泄漏;增益很小且成本明显增加,则保留简单方案。结果不支持复杂模型,也是一项有价值的结论。
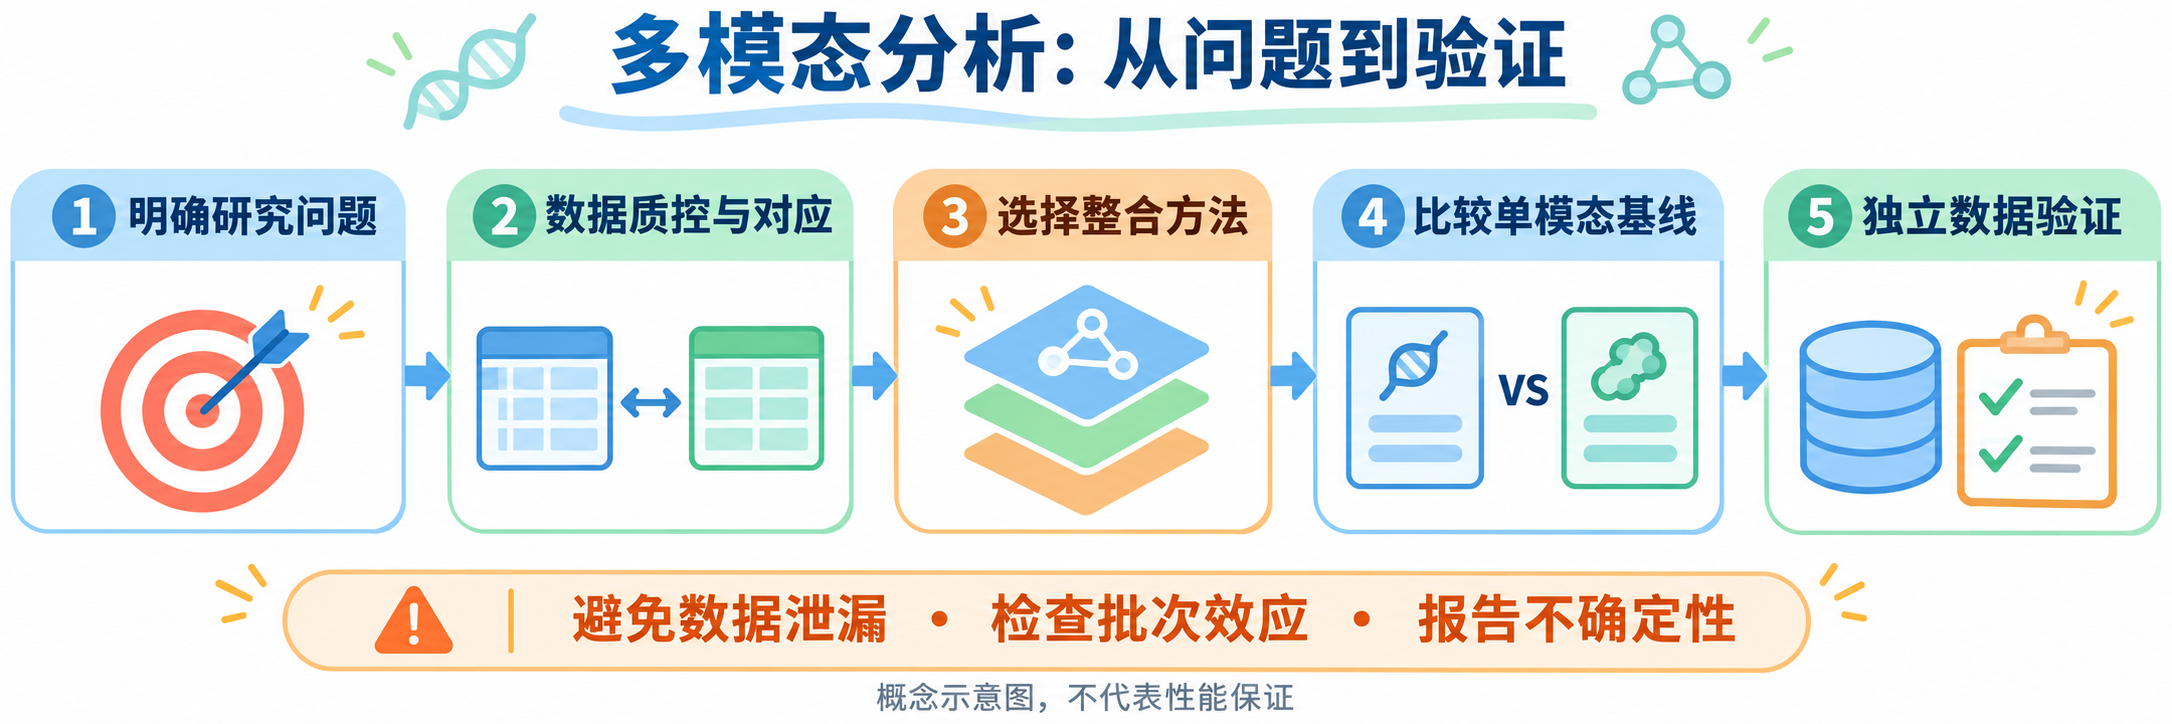
图注:研究问题→样本对应→分模态质控→单模态基线→联合分析→独立验证→决定是否继续。模型推断与实测数据分开标记;联合分析没有稳定增益时,不必继续增加复杂度。流程示意,非实测性能结果。
八、开始前准备什么?完成后怎样验收?
开始前:一份说明、一张对应表、一份文件清单
项目说明至少回答:研究对象是什么、核心问题是什么、已有哪几类数据、是否存在配对、最终希望得到解释还是预测工具。
样本对应表建议保留:个体编号、样本编号、模态类型、组织部位、采样时间、分组、批次、缺失情况与文件路径。涉及人员信息时使用合适的研究编号,不把与分析无关的身份资料混入文件。
文件清单应说明输入是原始测序文件、计数矩阵、标准化矩阵、图像还是已处理对象,并保留参考基因组、注释和软件版本。只有几张结果截图,通常不足以重新进行可靠整合。资料准备可参考云生信的生信分析数据与分组信息清单。
完成后:不要只验收图片是否漂亮
建议检查六项交付:
- **数据去向清楚。**哪些样本纳入、哪些排除、为什么排除,是否改变了组间构成。
- **质控分别保留。**每种模态的质量问题和处理依据能够追溯。
- **比较公平。**单模态与联合结果的比较,使用一致且合理的验证条件。
- **推断明确标记。**实测值、模型填补值和预测值没有混写。
- **边界写清。**哪些结果是描述、关联、预测,哪些结论仍需要实验或外部数据确认。
- **能够重复运行。**保留约定的代码、参数、环境、输入输出及随机种子;不把一次成功运行当作可复现交付。
涉及后续验证,可继续阅读生信分析做完了,下一步实验怎么做?。不要让每个新增模态都只增加一张图,却没有改变下一步研究决策。
九、多模态项目怎样考虑服务器与AI Agent?
**先看瓶颈,再定配置。**矩阵整合、原始测序处理、全切片图像读取和深度学习训练的资源需求不同。不能笼统说“多模态必须配GPU”,也不能认为CPU核心越多越快。
对于矩阵处理,先观察峰值内存和中间对象大小;对于图像任务,关注解码、切块和存储读写;对于深度学习训练,再结合模型、批量大小和输入尺寸评估显存。用有代表性的小批数据试运行,记录内存、运行时间和I/O情况,通常比直接购买最大配置更有依据。这里的小规模运行用于估算资源,不代表已经完成科学验证。
AI Agent适合协助文件核对、环境检查、流程执行、日志整理和报告初稿。但关键节点应保留人工复核,特别是样本匹配、分组定义、质控阈值和结果解释。自动完成代码,不等于自动证明方法适用;流程没有报错,也不等于科学结论正确。
十、常见问题:做之前先把这几句话想明白
**只有公共数据,能做多模态吗?**可以评估,但先检查不同数据是否真的对应同一对象、许可与使用条件是否满足,以及元数据是否足够。不同数据库中的“同一种病”不等于同一批患者。无法配对时,应诚实说明研究设计与推断边界。
**模态越多,论文就越有价值吗?**不能这样判断。多一种数据如果只是重复已有信息,或质量不足,可能只增加成本。价值来自问题是否重要、设计是否合理、证据是否可靠,而不是模态数量。
**整合后的聚类更清楚,是不是说明成功了?**这只能提供一个观察角度。还要检查是否由批次、样本质量或调参造成,并结合稳定性、已知标记、独立证据和任务指标判断。
**缺少某种数据,可以完全用AI补出来吗?**模型能够在特定条件下推断缺失信息,但预测不是实测。能否用于某项分析,需要单独验证,不能因为能够生成一个完整矩阵就当作拥有完整实验数据。
**如果联合分析不比单模态好,项目是不是失败?**不一定。可靠地证明额外数据在当前任务中没有明显价值,可以避免后续无效投入。重要的是预先定义比较标准,而不是为了得到更好看的结果反复修改问题。
总结:多模态的价值,在于增加有效证据
多模态研究的正确顺序是:先确定问题,再检查样本关系;先把每一类数据做可靠,再讨论联合;最后用公平验证判断新增信息是否值得。
对于课题组,最实用的起点不是列一长串算法,而是写清“我已有哪些数据、哪一步解释不清、希望新增信息帮助决定什么”。云生信的分析服务、在线工具与计算资源可以围绕具体任务沟通适用范围;方案和交付应以实际资料为依据,不承诺显著结果、模型一定优于基线或论文发表。
本文用于科研方法介绍,不构成临床诊断或治疗建议。
参考文献
[1] Stoeckius M, et al. Simultaneous epitope and transcriptome measurement in single cells. Nature Methods. 2017;14:865–868. DOI: 10.1038/nmeth.4380。用途:了解CITE-seq如何连接RNA与特定蛋白标记测量。
[2] Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184:3573–3587.e29. DOI: 10.1016/j.cell.2021.04.048。用途:了解WNN及同一细胞多模态信息的整合思路。
[3] Argelaguet R, et al. MOFA+: a statistical framework for comprehensive integration of multi-modal single-cell data. Genome Biology. 2020;21:111. DOI: 10.1186/s13059-020-02015-1。用途:了解多模态数据中的潜在因子与变化来源。
[4] Ashuach T, et al. MultiVI: deep generative model for the integration of multimodal data. Nature Methods. 2023;20:1222–1231. DOI: 10.1038/s41592-023-01909-9。用途:了解配对、单模态数据整合及缺失模态推断的能力和边界。
[5] Chen RJ, et al. Pan-cancer integrative histology-genomic analysis via multimodal deep learning. Cancer Cell. 2022;40:865–878.e6. DOI: 10.1016/j.ccell.2022.07.004。用途:了解病理图像与分子数据联合开展预后研究的实例。


