
一张分割示例图上,轮廓紧贴着细胞边缘。图旁还标注了平均重叠度超过零点九。这样的截图有时会隐藏一个重要分母,有多少枚细胞根本没出现在预测里?我们用十二个已知轮廓的模拟荧光目标运行 Cellpose,实际得到过只检出一枚、这一枚重叠度却达到 0.918 的结果。下面把这一次容易误读的评估拆开,既看识别出的对象有多准,也问漏掉了谁,最后回到直径参数怎样对应图像尺度。
一张图至少要做像素和对象两种核对
先给每个真实对象独立编号,保存一份实例标签图。预测结果同样要保留整数实例编号。如果先把所有非零像素转成一个整体的二值前景,两个紧挨的细胞即使被错误地合成一块,整幅图的前景面积仍可能几乎不变。相反,一个较大的细胞若被切成两半,前景像素可能也没有明显减少。对研究细胞数、单细胞强度或者细胞间距离的任务,这两种错误都比“轮廓差一两个像素”更要紧。评价时先枚举预测对象和真值对象,再专门统计合并、碎裂、漏检和多报。
对候选对象和真值可以计算交并比,即两个掩膜相交的像素数除以它们并集的像素数。若一个预测与两枚真值都有重叠,不能把它重复算作两个正确对象。我们先在两套编号之间做一对一分配,使总交并比尽可能高,再以零点五为阈值判断哪些配对达标。这个指标和整幅图的前景占比是不同层次的量,两种都可计算,名称和分母要写清楚。若只有很少对象配对成功,仅在成功对象中求均值会排除所有漏检,从而给人轮廓比实际覆盖情况更好的印象。
实跑经验|目标、图像和阈值相同,只改像素直径
这次安装 Cellpose 3.1.1.2,使用作者发布的 cyto3 权重,以 PyTorch 2.5.1 在 CPU 上执行模型推断。选择这个经典版本是为了单独核查直径参数,本文数值对应这套模型和接口。输入是宽二百二十四、高一百九十二像素的单通道模拟图。三行四列共十二个互不重叠的椭圆,各自的水平和垂直半径略有不同。我们在椭圆内生成较亮的信号,做轻度模糊并加入固定随机种子的噪声,同时保留加噪前的十二个标准轮廓。评估用这个已知真值,没有拿它充当真实组织的专家标注。对应版本的 Cellpose 模型说明
三次推断都用相同权重、相同图像、相同细胞概率和流场阈值,直径依次设置为十三、二十八和六十像素。十三与二十八都返回十二个实例,十二个对象全部一对一达标,平均配对交并比分别约为 0.940 和 0.940。设置六十时只得到一个实例,仍能与一个真值达到约 0.918 的交并比,但剩下十一枚都没有对应预测。三次前景占图像的比例约为百分之十七点四、百分之十七点四和百分之一点三。单看最后留下的一枚,无法发现覆盖面积和实例召回同时下降。
| 设定直径 | 实际预测数 | 达标配对 / 真值 | 配对对象的平均交并比 |
|---|---|---|---|
| 13 像素 | 12 | 12 / 12 | 0.940 |
| 28 像素 | 12 | 12 / 12 | 0.940 |
| 60 像素 | 1 | 1 / 12 | 0.918 |
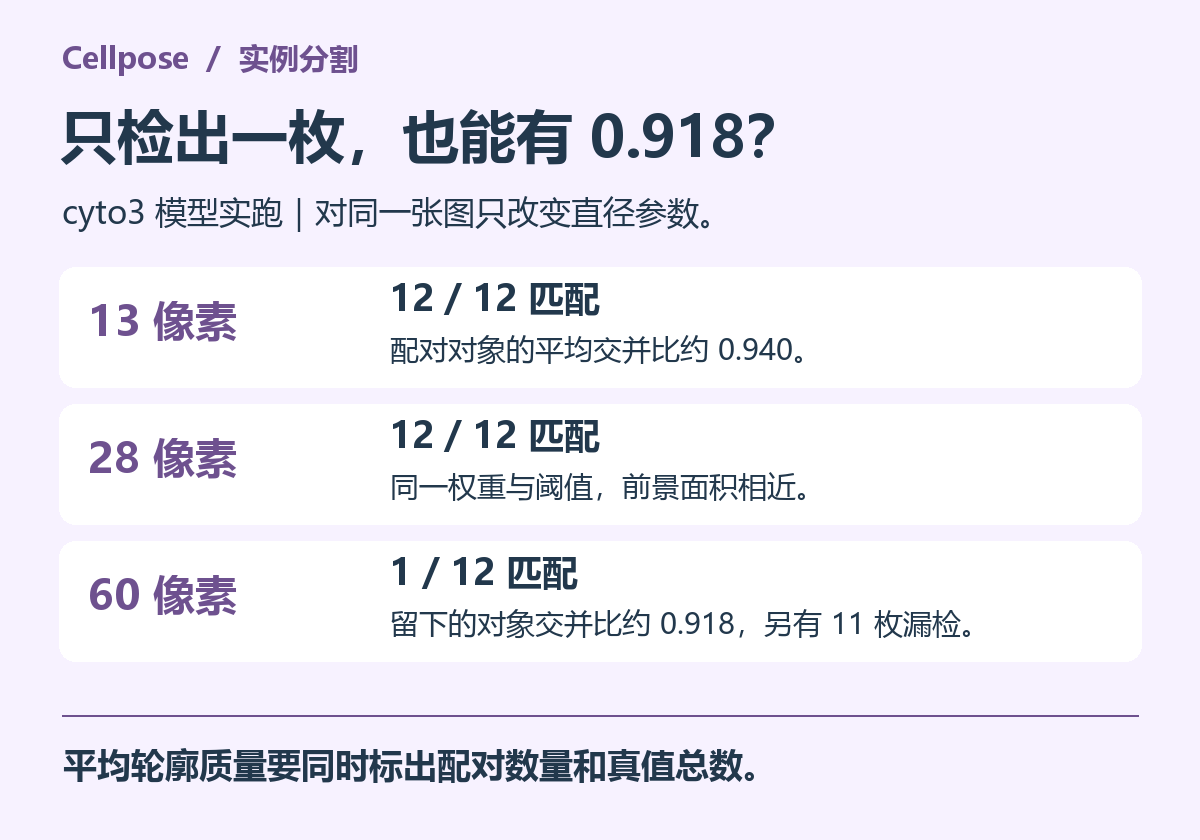
这组结果还说明参数敏感性可能有平台区间。在本例里直径十三和二十八的成功配对数相同,而六十带来明显恶化。不能基于这三个离散点推断所有中间值都会好,也不宜通过一张亮度均匀的合成图给另一种显微镜确定直径。如果实验采集时做了像素合并,或者在输入网络前把图像缩小一半,同一枚物理直径的细胞就占较少像素。跨批复用时应保留原始像素尺寸、缩放倍数和送入推断的直径。将直径写成微米却直接填入期望像素的参数,会导致尺度在无提示的情况下发生变化。
import numpy as np
from cellpose import models

model = models.CellposeModel(gpu=False, model_type="cyto3")
for diameter_px in (13, 28, 60):
    mask, flows, styles = model.eval(image, diameter=diameter_px,
        channels=[0, 0], flow_threshold=0.4, cellprob_threshold=0.0)
    ids = np.unique(mask)
    print(diameter_px, (ids > 0).sum(), (mask > 0).mean())
另外可以算一个含漏检惩罚的指标。按此处的一对一配对和阈值,六十像素设置的精确率是一除以一,召回率是一除以十二。若研究的结果是每平方毫米细胞数,它将严重低估密度,尽管留下的那一枚轮廓很漂亮。若研究的是罕见大细胞的平均强度,还要检查看到的是哪一枚及其大小,避免按容易被识别的特征筛选出系统性偏差。把阈值附近的匹配也保存下来,别人能检验更严格的轮廓要求会怎样改变数字。
对真实样本怎么选一组不偏袒模型的验证视野
先从正常密度的明亮区、细胞相接的高密度区和弱信号边缘各取若干不重叠小块。用相同的采样规则标注所有可辨认的实例,连模型没有返回轮廓的那些也一起编号。若只挑绿色轮廓附近的细胞做标注,召回率的分母一开始就遗漏了难例。对于贴边或标注者无法判断归属的细胞,可事先写下纳入规则,并在真实与预测两边采用同样的边界处理。不同处理组还要尽可能平衡图像曝光和组织部位,避免把某组本来更暗导致的漏检误认为细胞数减少。
阈值也应有明确作用。流场一致性和能否产生细胞区域是不同的检查,调整它们有可能让一些边缘变清楚,同时改变返回实例的数量。先锁定图像尺度和通道,再一次只变化一个因素,用实例数量、达标配对数、漏检数、误检数和面积分布合看。保存原始图、实例标签以及互相匹配的编号。若只留彩色叠加的截图,后续想改阈值或按细胞大小重新算指标,就需要重新描一遍轮廓。Cellpose 官方参数和分割输出说明
把试验扩展到整批图像前,可以先在有人工标注的少量视野确定评价方式与尺度范围。有多批视野需要统一推断、保存实例掩膜时,可了解云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)