
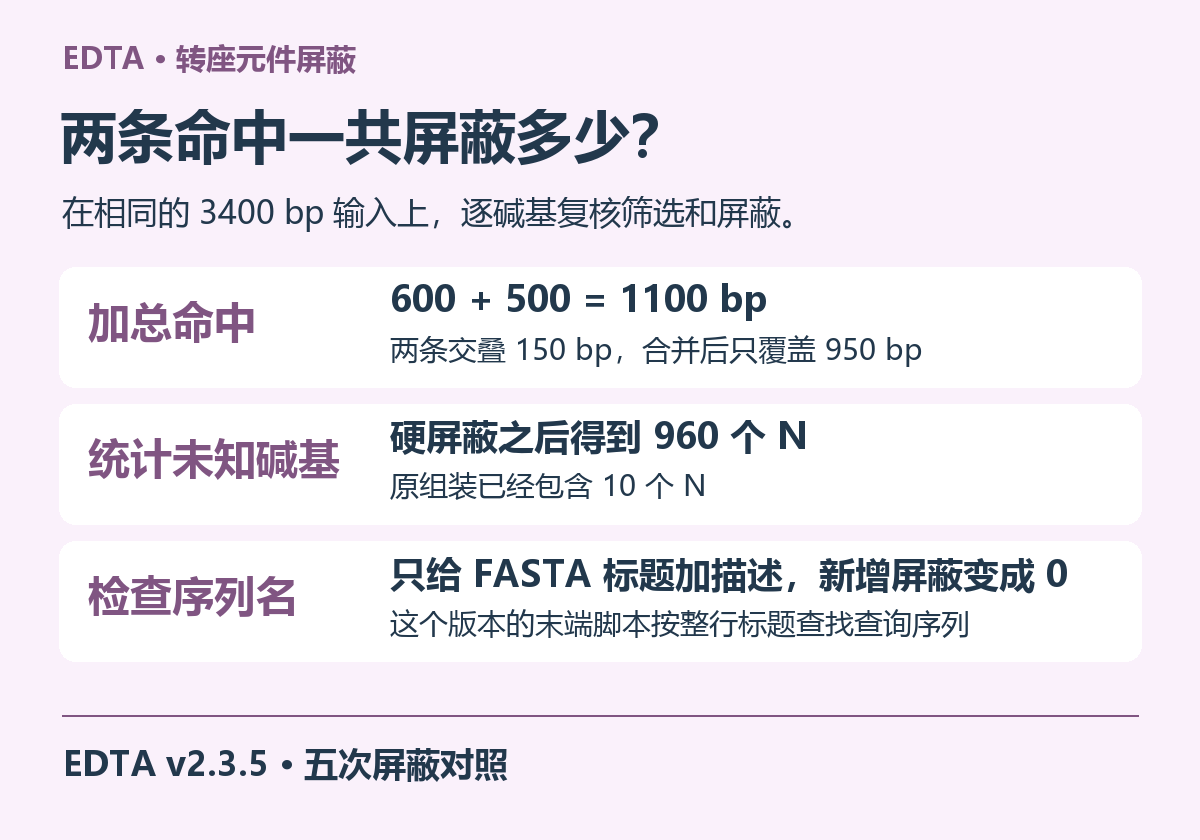
如果同事交付的重复注释表里有一条六百个碱基的记录和一条五百个碱基的记录,你会在报告里填多少重复序列?两条记录重叠一百五十个碱基时,填一千一百就把交叠区算了两遍。再看屏蔽后的组装,却能数到九百六十个 N,因为输入本身已有十个未知碱基。命中长度和、重复覆盖并集、输出中的未知碱基总量,这三个数字各自都有意义。下面在 EDTA 的正式屏蔽脚本上用五次对照把它们复算一遍,还会看到一个零报错却没有屏蔽任何位置的输入问题。
先认清自己拿到的是哪一层结果
EDTA 面向真核基因组的从头转座元件注释,会整合不同类别的结构发现和同源证据。完整元件集合可以用来审阅家族结构,家族代表库又能拿去寻找更多退化或碎片化的拷贝。最后交给基因预测或覆盖统计的序列,是把选定的匹配区间标到原组装上得到的。一个元件可能被另一个插入打断,留下多条匹配记录。两个候选也可能重叠,但同一个基因组位置只需要被屏蔽一次。因此在读一份交付报告前,先确定它是在数完整插入事件、比对记录、家族数,还是被标记的独有碱基。EDTA 方法论文
本文实际运行的是 EDTA v2.3.5 随附的末端处理程序。它接收一份组装和已经得到的重复匹配表,先筛记录,再合并区间,随后输出标记后的序列。为使每个判断都有可知的正确答案,我们自己设计匹配表,用固定种子生成背景碱基。这样可以明确一条记录为什么被排除,也可以准确知道两条记录共同覆盖了哪一段。这个实验的输出能核对屏蔽逻辑,无法评价整套上游发现流程在天然转座元件上的灵敏度。要回答后一问题,需要已经人工整理过的独立参考和完整分类结果。实际运行的原版源码
实跑经验 · 把最容易误解的边界放进同一张输入表
人工染色体长三千四百个碱基。除了第五十一到第六十位预先写成十个未知碱基,其余位置全是明确的大写碱基。五条命中有意分成不同角色。甲和乙部分重叠,乙的长度、得分、差异率又恰好落在默认边界。丙的匹配较短,丁的匹配得分稍低,戊的差异率刚超过上限。各条件使用同一条输入序列和相同匹配表,每次写入独立目录,只修改一个选项或一个标题。练习包内的脚本会生成所有输入并逐碱基比较结果,可以直接重新运行。输入生成脚本与五份实测结果
| 记录 | 查询坐标,两端计入 | 跨度 | 匹配得分 | 差异率 | 默认情况下 |
|---|---|---|---|---|---|
| 甲 | 101–700 | 600 | 500 | 5.0% | 通过 |
| 乙 | 551–1050 | 500 | 300 | 40.0% | 通过 |
| 丙 | 1151–1550 | 400 | 500 | 5.0% | 长度不足 |
| 丁 | 1701–2200 | 500 | 299 | 3.0% | 得分不足 |
| 戊 | 2351–2850 | 500 | 500 | 40.1% | 超过差异率上限 |
python3 096-edta/run.py /path/to/EDTA work
# 下列文件分别保存筛选后的记录、最终屏蔽区间和输出 FASTA
ls work/default_hard/hits.out.new
ls work/default_hard/hits.out.target.bed
ls work/default_hard/assembly.fa.new.masked
这个版本的脚本默认要求跨度至少五百、得分至少三百、差异率最多百分之四十。于是乙虽然三项都正好踩线,仍然进入结果。甲在第一百零一到第七百,乙在第五百五十一到第一千零五十,所以两者交叠部分是第五百五十一到第七百,首尾都计入,一共一百五十。两段原始跨度之和是一千一百,减掉交叠便得到九百五十。由于甲乙在基因组上有交叠,最终对应连续的一段,从第一百零一到第一千零五十。可以先只拿纸笔验一次,再打开屏蔽序列看变化是否逐位相符。
一份输出至少有三种值得统计的数
硬屏蔽条件下,比对输入和输出实际改变了九百五十个位置。输出一共九百六十个未知碱基,正好多出输入原来已有的十个。这里那十个位置刻意放在重复区外,因此可以把二者直接相加。如果已有未知序列正巧与待屏蔽区重合,待屏蔽区间的长度与新增未知碱基数就不再相等。比如原来就是 N 的位点被指定硬屏蔽,它照样属于目标区间,输出字符却没有改变。对缺口较多的组装,若关心重复标记跨过了多少已知碱基,需要把目标区间再与非缺口位置求交。
将其他参数固定,只改为软屏蔽,区间仍是相同的九百五十个碱基,输出出现九百五十个小写,而未知碱基总数回到十。检查软屏蔽时还应记得,有的组装交付前已经把一部分区域写成小写。直接数输出小写的总数,会把原先的标记一起算进去。较稳妥的做法是保留原输入,同时统计目标区间、原本已经小写的位置、从明确大写新变为小写的位置。三项都有了,看到两个项目的软屏蔽比例不同时,才知道它们是否采用同一种起点。
| 条件 | 通过记录 | 原始跨度之和 | 实际发生字符变化的位置 | 输出 N | 输出小写 |
|---|---|---|---|---|---|
| 默认硬屏蔽 | 甲、乙 | 1100 | 950 | 960 | 0 |
| 默认阈值,软屏蔽 | 甲、乙 | 1100 | 950 | 10 | 950 |
| 最小长度改为 400,软屏蔽 | 甲、乙、丙 | 1500 | 1350 | 10 | 1350 |
| 最大差异率改为 39,软屏蔽 | 甲 | 600 | 600 | 10 | 600 |
| 仅改变 FASTA 标题的描述 | 无 | 0 | 0 | 10 | 0 |
放宽长度条件时,一个独立且先前完全没有覆盖的四百碱基片段进入结果,所以标记区间如数增加四百。相反,收紧差异率上限使乙出局,却只减少三百五十个独有碱基,尽管乙本身长五百。余下一百五十个仍由甲覆盖。真实项目里改一个参数后,常有人把“过滤掉的记录总长”当成“释放给下游预测的基因组长度”。这两个数量出现差异时,应先查是否有其他家族或相邻片段仍覆盖相同位置,再去讨论参数是不是过于严格。
为什么第五次顺利结束,却一个位置都没有变化
第五次保留默认阈值,仅把 FASTA 标题从短名称改成同一个名称后跟空格和一段描述,匹配表里仍使用旧短名。程序结束并写出新的 FASTA,长度仍是三千四百,输出只剩原有的十个未知碱基。检查该版本源码,可以看到它在这里以整行标题存储序列,过滤命中时又要在这个集合中找到对应的查询名称。带描述的整行与表里的短名不能直接匹配,因而轮到每条记录时都被跳过。上游数据来自不同工具时,这类问题比明显的程序崩溃难发现得多。
处理自己的材料,可以先做一个名称交集检查。从组装读出标题并同时保存整行和第一个字段,从匹配表读出所有查询序列标识,分别核对能否对应。最怕的是两个原始标题去掉描述后恰好相同,这时不可直接截断再继续,应给二者建立唯一且可追溯的新标识,并让组装、坐标注释、区间表一起更新。如果组装本来就是规范的无空格唯一短名,保留其原样通常最省事。改动命名后抽查一条原先必然命中的记录,比只检查程序退出状态更能揭示问题。
awk '/^>/{sub(/^>/,"");print}' work/default_hard/assembly.fa
awk '$1 ~ /^[0-9]+$/ {print $5}' work/default_hard/hits.out | sort -u
awk '$1 ~ /^[0-9]+$/ {print $5,$6,$7,$10}' work/default_hard/hits.out.new
另一个细节藏在带有区间扩展名的中间文件里。常见的标准区间工具把起点视为零基,终点不包含在内。这个屏蔽脚本内部把原始命中的两端直接写入中间表,真正修改字符串时用起点减一、长度取右端减左端再加一。把这里的第一百零一到第一千零五十原封不动交给采用零基的程序,得到的长度会少一个碱基。要把它对外发布为标准区间文件,必须根据生成它的实际程序确认坐标口径,做一次小区间的手工还原。文件名看上去像某个格式,无法替代对坐标定义的检查。
如果要按元件类别交报告,还要给交叠区定一个归属规则。本例若把甲、乙暂时看作不同类别,各自覆盖六百和五百是正确的按类统计,但两类之和超过全体独有覆盖量。可以另列一项“多类共同覆盖”,将只有甲、只有乙以及两者共同覆盖三个互不重叠的区域分别汇总。这里可直接验算为四百五十、三百五十和一百五十。若业务问题要求每个位点最终只能归入一个类别,则应事先说明按哪一类证据定优先级,并保留被替代的记录。这样再次调整家族命名时,仍能从原始证据重新计算。
抽样验收时也值得保留一个负对照。选一段明确位于两条相邻命中之间的非重复序列,检查硬屏蔽输出是否与原序列逐碱基相同。本例第一千零五十一位是合并区右边紧邻的碱基,而第一千零五十位是最后一个应改变的位置。两者一起查看,就能同时发现少屏蔽一位和多屏蔽一位这两类错误。在引入新的坐标转换脚本后,复用这样的边界对照,比只检查整条染色体的总长度更敏感。
参数该怎样选才与下游任务相称
用于保护基因结构预测时,过于宽松的屏蔽可能覆盖某些有真实转录证据的编码区,过于严格则会留下大量转座元件编码片段,造成背景基因模型增多。可以先挑几处已知的蛋白编码基因和几处完整转座元件作为检查位点,分别看默认与调整后的屏蔽区间具体落在哪里。若仅仅为了把总比例调整到“看起来像同类物种”,很容易牺牲项目最在意的家族或基因。对重复丰富的植物,适当保留软屏蔽和独立区间,往往有利于后续在不丢失原碱基的条件下重新审阅。
区分一条记录因哪个条件出局,也有助于节省重复计算的时间。一个片段同时分数偏低且长度不足,单独调低分数阈值并不会把它纳入。如果只比较前后总数,看不到变化便可能误断程序没有读到参数。可把原始命中按长度、得分、差异率分别加上是否通过的三个布尔列,再检查只失败一个条件和同时失败多个条件的记录。选择一条正好卡在每个边界的例子,把筛选前后两条原始行和最终位置保存起来,便能区分算法规则、输入名称和统计实现三个层面的错误。
同一个项目还可能需要两套数字。若研究近期扩增的元件,匹配偏离共识的程度、家族年龄推断和组装完整性都值得另行讨论。此处的差异率只是跟具体家族参考比对得到的属性,受家族共识质量、保留片段以及搜索范围影响。若任务只是生成一套可复用的软屏蔽组装,则应以坐标准确、名称匹配和标记可恢复为优先。把用来估计生物学过程的统计与送给后续软件的序列文件分别命名,避免下游把某组筛选阈值得到的覆盖率误引成全物种真实重复含量。
最后留下四份能互查的材料,原组装摘要、未筛的命中、实际通过的记录、合并后的屏蔽区间。带上运行版本、筛选参数和已有未知碱基的计数,选两个有重叠的实例如上面那样手算。这样哪怕下一位同事换了区间工具或修改了组装标题,也能迅速发现同一条染色体是否多算了一百五十个碱基,或意外一个都没有标上。
当多套大型植物组装需要重复执行发现、筛选和屏蔽并保留中间结果时,可用已核算的一套组装规模与云生信生物分析服务器团队评估批量分析环境。


