
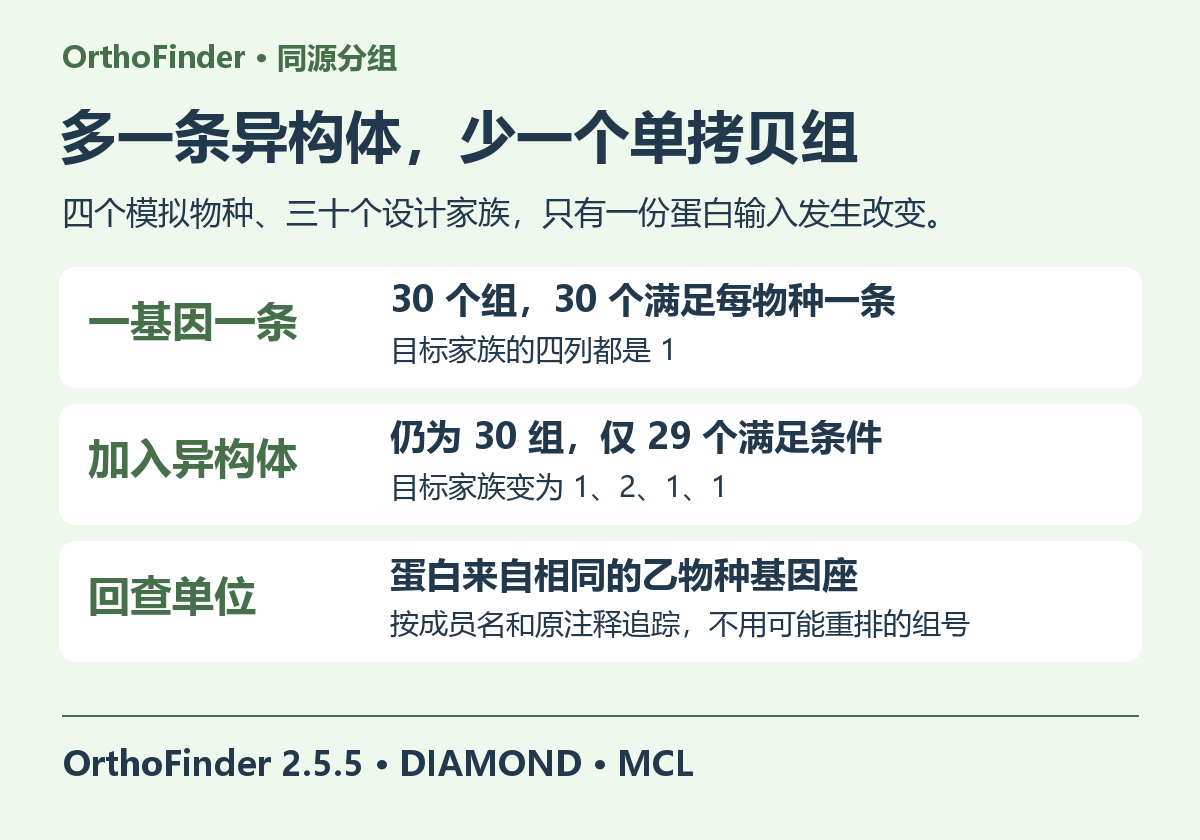
四个物种各交来一套蛋白,程序找到三十个每个物种都只有一条成员的群。给其中一个物种的输入多加一条剪接异构体,再跑一次,群的总数仍是三十,但符合单拷贝条件的只剩二十九。两次使用的是完全相同的四个模拟基因组背景,我们只改动了一份蛋白文件。这个例子可以帮助判断,在系统发育、基因家族扩张和跨物种比较中,表里多出来的一个数字究竟从哪里来。
一条 FASTA 记录在这里代表什么
日常拿到的蛋白集合可能有三种来历。有人从注释导出了所有编码转录本,有人已经按基因选择了代表蛋白,也有人把三个数据库各自的蛋白合并去重。三种文件都能按照相同的序列格式交给同源分析程序,记录的生物学单位却不相同。第一份容易把同一基因座的多个剪接产物都列进去。第三份可能同时含有同一个模型的不同命名,也可能错误地把两个不同基因座编码的相同蛋白合成一条。若研究要讨论基因拷贝数,最先需要核对的是记录和基因座之间的对应关系。
正交关系指向物种分化事件,旁系同源关系指向基因复制事件。属于同一个正交群的成员可以包含一个谱系中后续复制产生的多个基因,两个蛋白同组,也不自动说明它们之间是一对一直系同源。讨论时还得说明选择的是物种树上的哪个祖先节点。较早节点上的一个家族,到了某个子谱系里可能已经分成两个可辨别的分支。当前项目文档列出了系统发育层次正交群的节点文件,以及具体物种对的正交关系表。应根据问题选择对应层级。OrthoFinder 方法论文 · 作者的输出文件说明
这里把问题压小,只问多放一条来自同一基因的蛋白,输入记录数和初步分组计数会怎样变化。使用 OrthoFinder 2.5.5 的停止在分组阶段选项,实际执行相似性搜索和基于 MCL 的分组。下文按结果表重算“每个物种恰有一条蛋白记录”的行数。这个步骤适合隔离输入效应,做到了这一点就可以解释示例。真实研究需要物种树节点层次或要确认复制发生在哪里时,还应运行后续的树推断,并检查家族树和物种间正交结果。本次使用的版本
实跑经验 · 用一条有来历的异构体做对照
我们先构造三十条彼此独立的祖先蛋白序列,再为每个模拟物种分别加入少量替换,生成甲、乙、丙、丁四个物种的蛋白文件,每份三十条。这样每个设计家族对应四条略有差别的蛋白。第一轮直接运行。第二轮只在乙物种的第七家族加入一条从原蛋白中间少了十八个氨基酸的序列,保留原有序列不动。这一条被明确设计为同一基因座的另一种产物,没有新增模拟基因座。其他一百二十条输入、搜索程序、线程数和分组设置全部保持相同。输入生成脚本、两个条件和预期结果
python3 097-orthofinder/run.py /path/to/OrthoFinder/orthofinder.py work
# 已经准备好每个物种一个蛋白文件时,可以这样运行分组阶段
orthofinder -f proteins -og -S diamond -t 1 -a 1
| 核查项 | 每基因一条代表蛋白 | 乙物种多放一条异构体 |
|---|---|---|
| 输入蛋白总数 | 120 | 121 |
| 得到的分组数 | 30 | 30 |
| 四个物种各一条的组 | 30 | 29 |
| 第七家族内甲、乙、丙、丁的记录数 | 1、1、1、1 | 1、2、1、1 |
| 乙物种分配到组中的记录数 | 30 | 31 |
复核时没有拿两版中相同的组号直接对照。分组编号可以随着输入改变而重新排列。我们选择那条两次都存在的乙物种第七家族原蛋白,找到它所在的行,再将四个物种的全部成员标识各自排序比较。第一轮每份文件贡献一条,第二轮乙物种同一格里同时出现原蛋白和新异构体,其余三个物种的成员标识逐一不变。每列计数后还能反查蛋白名称,比只展示一张家族大小热图更容易解释差异。
两次总组数相同,说明在这个控制样本里新增序列回到了原有的群。它不会凭空增加第七家族的生物学拷贝,但任何直接从每格蛋白条数计算的下游指标都会读到那个二。如果下一步只选择四个物种各一条的组来串联系统树,这组原本满足输入设计条件的序列就会被排除。倘若用的是逐家族比较基因数目的模型,在这个位置乙物种也会多一票。因此要先恢复每条蛋白与来源基因的关系,再决定统计哪一层,才能解释发生的是文件变化还是基因组变化。
怎样选择代表蛋白,又不误删真正的重复基因
先从生成蛋白的同一版注释提取基因、转录本和蛋白三者的对应。对于使用父子关系描述的注释,要沿编码区记录找到所属转录本,再找到所属基因。若供应方给了官方代表转录本或有人工审定的主转录本,可以优先采用,并保留其选择依据。若只能自行选择,先决定如何处理缺少起始、终止或带有异常中断的模型,再按一致规则选择。单纯取最长的一条很方便,但组装缺口、嵌合转录本或错连的外显子也可能制造一个虚假的“最长”。对研究重点家族,应结合结构域顺序、跨剪接证据和近缘物种的完整序列复核。
选择时用基因座身份作分组键,同一个基因的异构体先进入同一候选集合。两个不同基因座可能刚刚复制,编码蛋白完全相同,若只对蛋白的序列字符串去重,就会抹掉真实的两个基因位置。反过来,同一基因座的异构体长度不同、序列也不同,普通完全一致去重无法把它们合并。可以把上述两种情形各挑一个位置作为预检查,确认第一种被保留为两个来源、第二种按设定规则只交一条代表序列。这个小测试比看程序最后删除了多少“重复”更能揭示规则是否符合研究目的。
不建议拿文件名或编号末尾的数字直接作为唯一依据。有些数据库用点号区分版本,有些用点号区分不同转录本,另外一些保留点号只是历史命名习惯。把点号后的字符一律去掉,可能把不同基因合在一起。更可靠的做法,是输出一张明确的映射表,每行列出物种名、组装版、基因编号、转录本编号、蛋白编号、是否入选和入选依据。这样当某个家族在新版里减少时,可以逐条回答少掉的是旧异构体、修订后的编号,还是在新注释里确实再也找不到的基因座。
读分组表时,给零、一个和多个写不同的复核步骤
某个物种这一格为空,先查对应蛋白是否真的进入该轮输入、是否被过滤、是否由于起止不全或序列过短而难以通过相似性搜索。再看其他物种的成员是否包含足以定位这一家族的保守区。若在目标基因组邻近区域能找到连续的编码证据,原来空缺也许是注释缺失。只有检查到足够的基因组和进化证据,才适合把这一格写成谱系特异丢失。尤其在用转录组拼装代替完整基因组蛋白集时,一个基因可能只因取材组织没有表达而不出现在文件中。
某一格有多条记录,则优先回查实际基因组位置。同一基因座的多个转录本是一种解释。主组装与未清理的替代单倍型重复、一个基因被切成前后两个模型、多个不同基因座上的真实复制,也都可以表现为多条蛋白。把它们分别映到相同版本的染色体上,检查是否拥有相同两侧邻域、是否仅在单倍型片段间重复,或者分别占据相邻但独立的位置。两个蛋白若只分别匹配参考蛋白的前半和后半,还应该看基因边界是否被错误拆开。做完这一层才需要讨论真实复制的时间和可能的功能分化。
某一格正好一条时,仍需核对其序列证据。这个唯一序列可以只是包含一个常见结构域的短片段,而别的物种保存了很长的多结构域蛋白。把它们直接用于全长多序列比对,会在这个物种制造大段缺口。可以先比较长度和覆盖到的结构域,查看缺失主要落在片段两端还是内部,剔除或标记明显不完整的模型。用于系统树时,还要说明过滤后的对齐列保留了多少真正共有的信息。一个只按条数合格的分组,未必提供足够的系统发育信号。
抽查时可额外做一次按物种的账目核对。把已分组的成员逐个展开,用唯一蛋白标识去重,再将未分配的蛋白单列,与原输入的标识集合逐一对账。只检查加总后的数量会漏掉一条蛋白重复出现、另一条意外缺失而总数恰好抵消的情况。这个控制样本中,第二轮乙物种分组成员应恰好等于三十一条输入的完整集合。用同一检验去看真实项目,还能把“没有和其他物种分到一起”与“根本没有进入程序”分清。
报告家族扩张之前,至少留住两份原始证据
第一份是每个差异家族的成员明细,要求能够从组里任一条蛋白追溯到物种的真实注释和位置。第二份是目标群的比对和基因树,要求能说明多个成员是在物种分化前还是分化后形成分支。仅凭乙物种有两条、其余物种各一条,至少有古老复制后其他谱系丢失、乙谱系近缘复制、输入含重复注释等多种解释。若其他证据不足,报告可先写为某物种的注释蛋白记录较多,并列出最需要核对的位点。能定位不确定性,比给一个没有依据的复制时间更方便同行进一步验证。
对于物种样本并不均匀的研究,建议先锁定要解答的问题,再确定一条基因在不同层次正交群里怎么计数。加入一个外群有可能改变关心的祖先节点或提供分辨复制方向的信息,若替换的是同一个物种的注释版本,则要把记录映射和成员变化单独列出来。若目标是比较表达或定位功能相近的跨物种候选,还应检查相应物种对之间的正交关系,而不能仅按全物种共组就选最近名称。把不同问题对应的结果表和筛选规则记录下来,同一套数据才能在几个项目间复用而不混淆。
交付时可以留一个读者能立刻执行的反查动作。先输入自己熟悉的某个基因名,找到交给 OrthoFinder 的代表蛋白,再查到目标家族、另一个物种的成员,最后顺着映射回到对方的基因组位置。本例从乙物种第七家族走完这一圈,恰好能看到多出的是同一基因的另一个输入产物。这种反查也最容易发现物种名映射写反、同一标识在不同蛋白文件中重用,以及旧注释和新蛋白对不上的问题。
多个物种的代表蛋白和映射表整理完成后,如需反复进行全对全搜索与基因树重建,可按实际物种数及蛋白总数向云生信生物分析服务器团队估算批量计算规模。


