
拿到一对双端 FASTQ,用 fastp 过滤,报告显示输入四十条、过滤后二十四条。若有人从输出目录中数到三十一条,他和报告一定有一个数错了吗?我们制作了二十对名字可追溯的读段,分别放入双端均合格、只有左端失败、只有右端失败和双端都失败的例子。运行同一套过滤条件后,只改变是否保存合格的孤立端,结果这两个数字可以同时成立。这个练习能帮读者在送入比对前说清楚自己保存了多少对、另外保留多少单端,以及表里的百分比用了什么分母。
双端测序至少有三种计数单位
一份来自同一片段两端的测序记录,在 R1 文件和 R2 文件各占一条。若按物理片段数,它是一对。若按 FASTQ 记录数,则是两条。质控能单独判断某一端的碱基质量、未知碱基数和长度是否合格,但写入常规配对输出时,两端还要能作为一对共同保留。于是“通过单端条件的读段”“作为完整配对留下的记录”和“实际写进所有文件的记录”是三种量。先给数字补上单位,再对照下游工具要求的输入形式,比拿两个百分比直接相减更有效。fastp 作者说明及双端输出参数
一个实用约定是为每个样本建立尺寸最多只有几行的收支表。列出原始配对数、两端都合格的配对数、只有第一端可用的数、只有第二端可用的数、双端均不可用的数。末尾记录是否实际写出这两类孤立端。如果文件里出现看似少一半的数字,先看对方是报配对还是报端数。如果孤立端已经另存,却仍把它们强行与另一个方向的孤立端逐行拼起来,原本不同片段的两条读段会被假装成同一对,污染片段长度、方向与配对比对结果。
实跑经验|让失败原因一开始就写在读段名字里
在 Ubuntu 安装 fastp 0.23.4,固定随机种子生成二十对长度均为七十个碱基的 FASTQ。十二对两端均高质量,四对仅第二端全为低质量,三对仅第一端有十二个未知碱基,最后一对两端全为低质量。其余序列随机生成,质量合格的碱基用高质量字符表示。为这个专门检验配对关系的例子,我们关闭接头修剪、多聚鸟嘌呤修剪和重复率估计。设合格质量阈值为二十,允许不合格碱基最多占四分之一,未知碱基数上限为五,最短长度为二十五。所有读段的名字带有可核查的编号和预设场景。
先只输出常规 R1 和 R2。两个文件各有十二条,名字匹配,恰好是那十二对双端都合格的读段。再用相同输入和筛选参数,另外指定两个孤立端输出文件。常规配对文件仍各有十二条。第一端孤立文件另外有四条,来自原来第二端质量太低的四个片段。第二端孤立文件有三条,来自原来第一端未知碱基超限的三个片段。各文件中的读段标识都逐条对过,双端均失败的最后一对没有进入任何合格输出。
| 本次实际核对的量 | 只保存常规配对 | 另存合格孤立端 |
|---|---|---|
| 完整配对数 | 12 对 | 12 对 |
| 常规配对文件合计 | 24 条 | 24 条 |
| 第一端 / 第二端孤立记录 | 0 / 0 条写出 | 4 / 3 条写出 |
| 所有合格输出文件合计 | 24 条 | 31 条 |
| 报告中 after_filtering 的总读段数 | 24 | 24 |
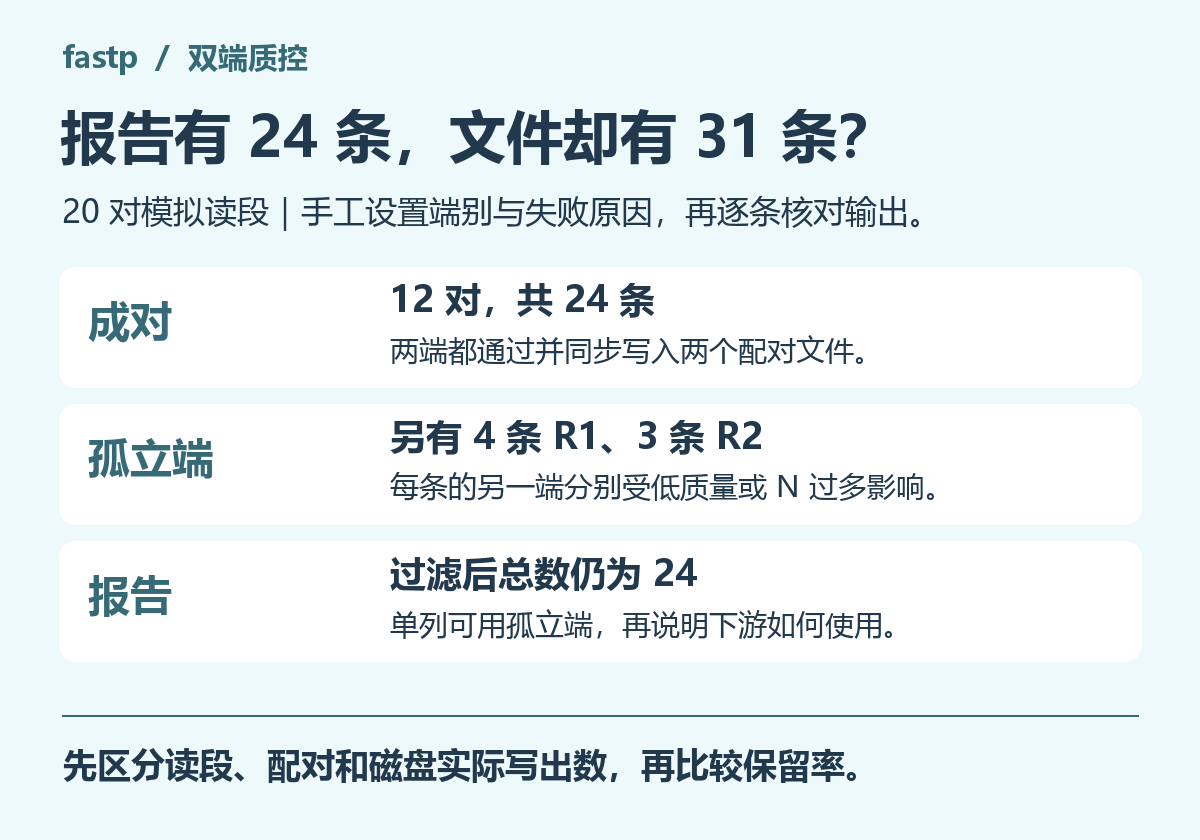
这个输出揭示了另一个容易混淆的指标。两次报告的过滤原因汇总里,低质量读段为十,未知碱基超限为六。按我们构造的数据,真正全低质量的端只有六条,即四个坏第二端和最后两个坏端。含过多未知碱基的端也只有三条。报告中的十和六在本例里分别是五个受低质量影响的配对与三个受未知碱基影响的配对,各按两条记录累计。它们可以与二十四条配对合格端一起加到四十,却不能据此断言有十个物理读段的质量字符串本身不合格。要排查究竟是哪一端出错,应当核对来源读段和孤立端的名字,并查看单端质量分布。fastp 的配对处理实现
fastp -i source_R1.fastq -I source_R2.fastq -o paired_R1.fq -O paired_R2.fq \
  --unpaired1 solo_R1.fq --unpaired2 solo_R2.fq \
  --qualified_quality_phred 20 --unqualified_percent_limit 25 --n_base_limit 5 \
  --length_required 25 --disable_adapter_trimming --disable_trim_poly_g \
  --dont_eval_duplication --thread 1 -j result.json -h result.html
在这个例子中,按完整配对判断,保留比例为十二除以二十,即六成。若分析允许利用合格孤立端,实际可交给后续步骤的记录为三十一除以四十,即百分之七十七点五。将两种比例并排写出来,同时标清是否启用孤立端输出,实验同事就不会把“保留率变高”误解成过滤阈值已经放宽。
决定下游怎么接,比把每一条 read 都留下更重要
若后续步骤需要物理配对关系,例如依赖插入片段跨度的分析,常规双端输入只用具有匹配标识的两份配对文件。若分析允许利用孤立端,可以将其作为明确标记的单端输入另行处理,保留其原样本和端别。将两份孤立端文件按行合并成新的双端输入,即使行数偶然相等,所配的名字也可能来自不同片段。验证时不要只看两个文件大小,抽查前后若干对,并在批处理中按读段标识检查配对关系。大文件还要用能够正确读取压缩 FASTQ 的程序,不能把压缩文件大小当作记录数。
读数减少也未必意味着质量改善。若某一种建库的第二端特定循环系统性变差,丢失的可能不是随机一部分片段。一组样本第二端低质量,而对照组两端都稳定,严格成对筛选有可能使文库保留量与实验分组相关。应把端别、失败原因、各自比例按技术批次和生物学分组并排看,再决定是否改修剪策略或调查测序过程。因为本次练习有意关闭接头修剪,不能据此替普通短插入文库选择默认配置,真实数据仍应查看接头、长度与原始质量曲线。
批量处理前保留一份带已知读段名的小例子,再为每个样本存下 JSON 报告及配对、孤立端清单,遇到数量对不上时能从哪一端丢失查起。团队需要集中处理整批测序数据时,可了解云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)