
识别候选病毒时,最容易产生误解的是一串接近一的分数。它看起来像是给出了明确答案,却没有自动回答序列是否完整、属于哪个物种、边界是否准确,以及这个数值在当前样本背景下应该怎样解释。geNomad 提供标记、序列模型、汇总过滤和可选分数校准,真正读懂结果需要把这些环节分别核对。
本文实际安装 geNomad 1.13.0,使用数据库 1.9,围绕公开的噬菌体 lambda 参考序列及其不同长度片段做了对照。最有意思的结果是,五百碱基片段在默认过滤下被保留,切换保守过滤后被排除,而它的校准分数并没有改变。这个变化来自后处理条件,不是模型突然认为同一条序列变成了另一种对象。
一、工具解决的核心问题是什么
geNomad 用于从核酸序列中识别病毒和质粒候选,并提供基因标记和分类信息。其流程同时利用标记证据和序列模型,再整合结果。对读者来说,重要的不是记住所有模块名称,而是知道一个最终候选可能经历了基因预测、标记搜索、模型评分和汇总过滤,不能把最终表格看成单次相似性搜索的直接输出。官方流程说明
它适合在组装后对大量序列进行筛选,也适合检查某条候选序列具有什么分类证据。优势是不同类型的信息可以在统一结果中查看。局限是短序列、陌生类群和复杂的宿主片段仍然需要复核,任何单个分数都无法替代后续的质量和边界检查。
因此,分析目标应先写具体。寻找更多候选与建立较保守的分析集合,可以使用不同的过滤规则,但这些选择必须在报告中说明。若两个样本用了不同规则,最后只比较病毒条数,就可能把筛选策略的差异误认为生物学差异。
二、实验输入怎样构造
输入包括七条序列。五条来自公开的 lambda 参考 NC_001416.1,分别是完整序列、前半段、前五千碱基、前两千碱基和前五百碱基。另外两条取自大肠杆菌 K-12 参考 NC_000913.3 的前五万和前两千碱基,作为细菌来源对照。脚本核对两个参考序列的校验值,再按固定位置截取,没有修改碱基或拼接新的生物序列。
这些输入故意让序列来源保持清楚,但它们不是独立采集的七个样本。五条噬菌体序列彼此包含,不应当作五个独立病毒种,也不能用来计算面向自然环境的灵敏度或准确率。本实验回答的是同一来源的不同长度输入怎样经过评分与过滤。
完整 lambda 输入长四万八千五百零二碱基,前半段长二万四千二百五十一碱基。已知截取位置让我们能够明确区分“来源于病毒”与“包含完整病毒基因组”。五百碱基片段即使被正确识别出病毒信号,也仍然只是参考序列的一小部分。这一点不需要模型评分来决定。
三、安装和数据库也要核对版本关系
本次使用固定摘要的容器安装程序,通过实际版本输出确认版本。数据库从维护者提供的下载站取得,压缩包大小为八亿四千二百多万字节,并与公开记录的校验值核对一致。软件与数据库之间的兼容关系另查了维护者的发布表,确认数据库 1.9 对应本次程序版本。版本对应表
下载时最初使用的镜像访问较慢,之后切换到维护者下载站。采用分段传输后,仍然对完整文件重新计算校验值。数据库压缩包内部包含指向本目录其他文件的链接,解压前核对了目标范围。这些检查保证我们运行的是完整且可追踪的数据库,不能只凭目录已经出现就认定安装完成。
正式运行限定两个线程,并将标记搜索拆成八份,以控制本次实验的内存使用。拆分数据库影响的是搜索组织方式,本次没有通过降低搜索灵敏度来缩短实验。官方也介绍了拆分参数的用途,但具体取值仍需要结合实际环境验证。常见运行问题
genomad end-to-end \
  --threads 2 \
  --splits 8 \
  --enable-score-calibration \
  inputs.fna genomad_output genomad_db
注意这里明确开启了可选分数校准。后文所说的“默认过滤”是指汇总阶段采用默认过滤条件,不表示整条命令完全没有修改默认选项。准确描述这种区别,比笼统写“使用默认参数”更容易让读者复现结果。
四、先读到什么,再解释为什么
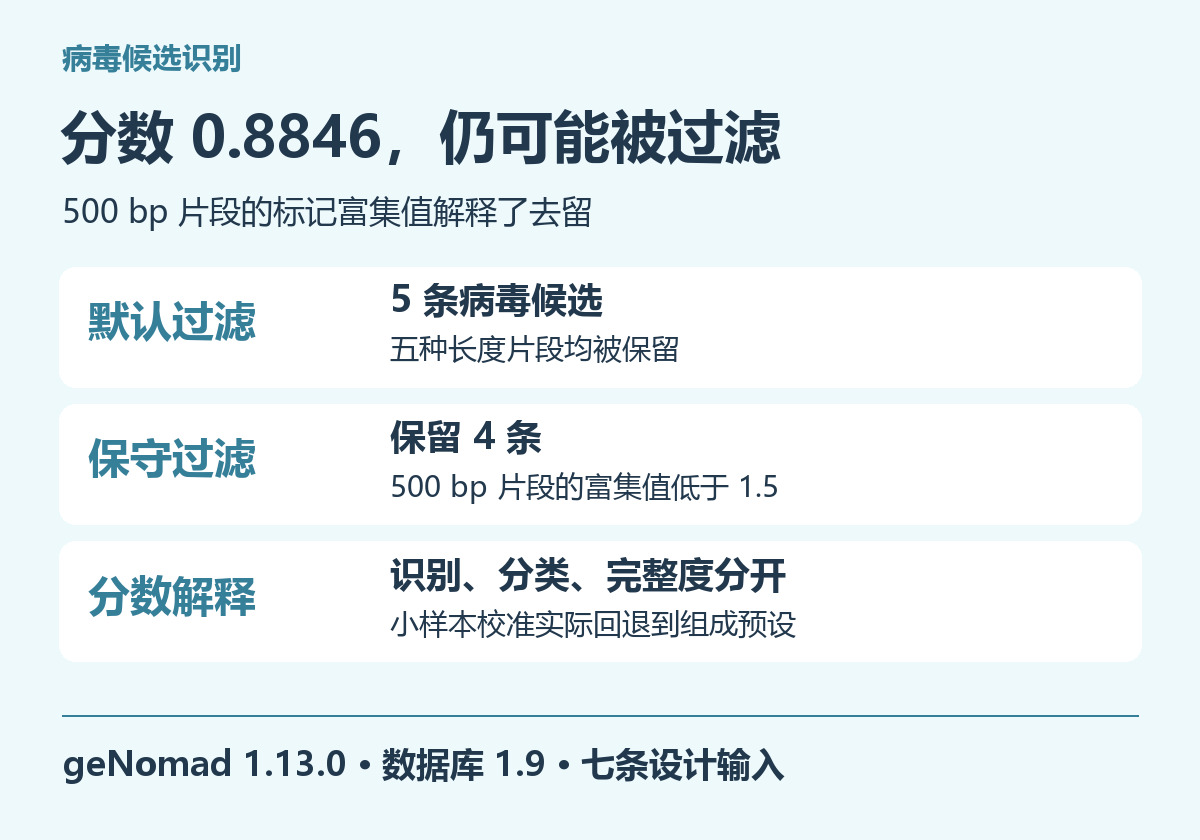
默认过滤得到五条病毒候选,正好是五条 lambda 来源输入,两条细菌对照没有进入最终病毒或质粒集合。宽松过滤仍然得到这五条,保守过滤则只保留其中四条。所有汇总命令都正常结束,没有通过修改输入内容制造这些差异。
| lambda 输入长度 | 预测基因数 | 校准病毒分数 | 默认 / 保守保留 |
|---|---|---|---|
| 48,502 bp | 62 | 0.9985 | 是 / 是 |
| 24,251 bp | 25 | 0.9988 | 是 / 是 |
| 5,000 bp | 5 | 0.9987 | 是 / 是 |
| 2,000 bp | 2 | 0.9955 | 是 / 是 |
| 500 bp | 1 | 0.8846 | 是 / 否 |
半长片段的分数甚至略高于完整序列。这并不奇怪,因为分类分数与序列覆盖了完整参考的多少不是同一个量。不能用两者的小数差别给基因组完整度排序,也不能因为半长片段分数更高,就认为它比完整输入更适合代表整个基因组。
五百碱基片段被预测出一个基因,并具有一个病毒标志基因命中。短序列并不是仅凭长度就自动全部删除,实际是否保留还受其他证据影响。另一方面,本次短片段来自已知参考,具备相应标记,不代表所有五百碱基环境片段都同样容易分类。
五、分数超过阈值,仍然可能被其他条件过滤
五百碱基片段的校准病毒分数为零点八八四六,超过保守过滤的分数门槛,但它仍被排除。查看结果后发现,其病毒标记富集值为一点三九七六,低于保守预设要求的一点五。这说明最终候选集合由一组条件共同决定,不能只拿分数列去解释所有保留和排除结果。后处理过滤说明
为确认这个解释,本次又做了一轮只调整病毒标记富集条件的汇总。其余条件回到默认值,只把富集阈值设为一点五,结果同样只剩四条,排除的仍是五百碱基片段。这个单条件对照比仅凭预设名称推测原因更可靠。
genomad summary --conservative \
  inputs.fna genomad_output

genomad summary --min-virus-marker-enrichment 1.5 \
  inputs.fna genomad_output
汇总命令会改写相应输出,因此实跑脚本在每次运行后分别保存了结果快照。正式项目里也应保留不同筛选规则对应的表格,否则后一次运行覆盖前一次结果后,只剩一个文件名,读者将无法追踪候选数量为什么变化。
宽松过滤没有新增候选,同样值得保留。它只是在这组输入上没有改变最终集合,不能推导为宽松参数永远没有影响。比较参数时,不必为了让文章看起来有变化就继续调到出现想要的结果。没有差异也是一个有明确适用范围的观察。
六、小样本校准出现了一个版本敏感细节
本次输入只有七条序列,却实际生成了校准结果和非空的错误发现率列。检查日志后发现,程序没有从这七条序列精确估计样本组成,而是在自动模式下回退到 metagenome 预设。整合模型对应的组成值为染色体零点七二、质粒零点一七、病毒零点一一。它们是所用预设,不是从七条设计序列测得的真实比例。
这与网页概述中“小于一千条时自动关闭校准”的表述不同。本次以 1.13.0 的实跑日志和相同版本源码为准,源码明确包含小样本回退到预设的处理。因此,读者不能只根据一段通用教程推断当前版本是否真正执行了某一步。1.13.0 校准模块源码
这个实验并不是建议小数据集一律打开校准。它的作用是暴露校准依赖的背景假设。我们的输入故意富含同一病毒的重复来源片段,与普通宏基因组组成并不相同,因此不能把这些校准分数当作真实项目准确率。更不应该为了超过数量门槛,复制同一批序列凑出一千条再宣称获得了可靠组成估计。
例如,五百碱基片段的未校准整合分数为零点七八一七,校准后变为零点八八四六。变化来自评分处理和背景设定,没有给这条片段增加新的基因或新的序列长度。讨论结果时,应同时保存校准前后分数、采用的组成方式和相关提示,而不是只保留看起来更高的数字。
七、错误发现率不是这一行序列出错的概率
默认过滤表中,五百碱基片段排在第五行,它的错误发现率显示为零点零二四八。这个值并不是一减去该行病毒分数。用显示的分数计算,一减去零点八八四六约为零点一一五四,两者显然不同。差别来自统计对象,一个涉及单条序列的校准值,另一个概括截至该行所保留集合的预计错误比例。
本次前五行的校准分数分别约为零点九九八八、零点九九八七、零点九九八五、零点九九五五和零点八八四六。将一减去各分数的值加总,再除以五,约为零点零二四八,与表格一致。因为显示值经过舍入,手工核对只应要求合理精度,不要把最后几位小数的差别当作程序错误。分数校准与错误发现率说明
更重要的是,这个估计仍然依赖模型和校准背景,不能在一个人为组成的小实验中视为经过独立验证的错误率。真实项目若要评价方法表现,应使用合适的已知真值和独立测试设计,而不是把工具输出的估计值再拿来证明工具本身准确。
八、分类信息、拓扑与完整度也需要分别阅读
本次五条病毒候选的序列级分类都停在 Caudoviricetes,后续部分层级留空。即便我们知道输入来自 lambda,也不能据此要求程序的每个层级都必须填到物种。工具根据标记支持给出序列级分类,某个基因具有更具体名称,也不代表整条序列一定具有足够一致的证据到达同样层级。分类学赋值说明
所有候选的拓扑字段均显示没有末端重复,前病毒坐标为不适用。本次前病毒结果表也没有记录。没有检测到末端重复,不等于已经证明序列不完整,同样不等于证明它一定完整。这个字段描述的是检测到的结构信号,需要结合输入来源和专门质量评估解释。
读者可以把分析结果拆成三个问题依次回答。首先,这条序列是否具有支持其为病毒的证据。其次,可能属于哪个分类范围。最后,它覆盖了多大比例的基因组,是否存在宿主片段或边界问题。不同工具和不同输出可能分别支持其中某一个问题,不必要求一张候选表同时解决全部问题。
九、怎样把本次经验用在自己的数据上
实际项目里,可以先挑选少量长短不同、证据强弱不同的候选,逐条查看标记数、富集值、分数和最终过滤状态。若某条高分序列消失,先核对其他条件,再怀疑程序丢失结果。若不同模块给出不同倾向,应追踪它们如何被整合,不要随意挑选最符合预期的一列作为最终结论。
本次七条输入全部正常完成了标记、序列模型、整合、校准和汇总流程。保守过滤比默认少一条,原因可以通过单条件对照定位。这个经验可以用于检查更大项目中的候选变化,但本次没有评估质粒阳性样本,也没有以新病毒发现或总体准确率作为实验目标。
下载本组复现材料可以取得输入截取脚本、软件与数据库固定信息、四组汇总表、原始模块结果和校准日志。建议先复查这几条已知来源序列的变化,再将同样的证据核对方法应用到自己的环境样本中。
当候选筛选需要扩展到多批次组装,并持续保留数据库、参数和结果快照时,可以了解云生信生物信息分析环境服务。


