
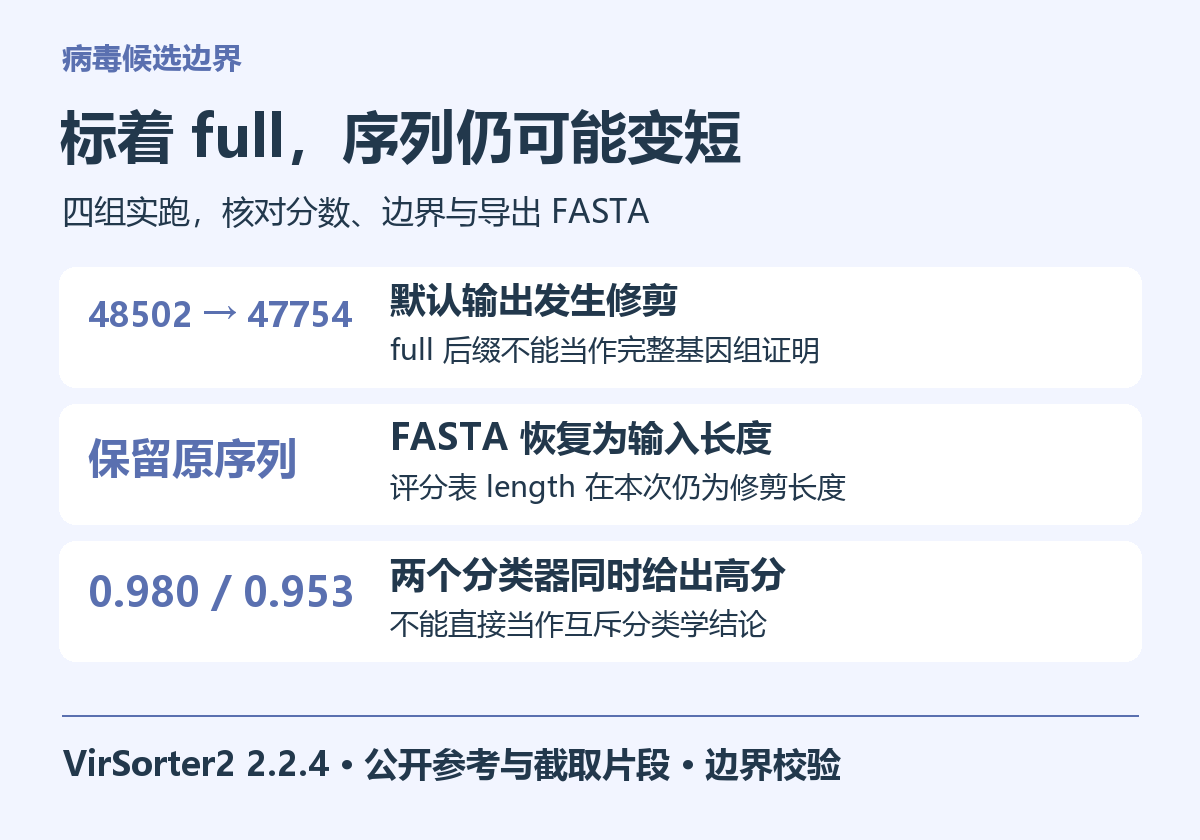
病毒识别结果中,最容易被误读的一个后缀是 full。读者可能把它理解为完整病毒基因组,也可能认为输出一定保留了输入的全部碱基。实际运行 VirSorter2 后,我们发现一条输入长度为四万八千五百零二的序列,结果名称仍带 full,默认输出却只有四万七千七百五十四碱基。
本文实际安装 VirSorter2 2.2.4,下载并核验作者提供的数据库,在公开 lambda 参考序列及其截取片段上完成四组运行。除了检查分数阈值,还对比了默认修剪与保留原序列的输出,并逐条核对边界坐标和序列校验值。实验目的是帮助读者正确使用候选结果,不是评估未知病毒的发现准确率。
一、先把候选识别、分类和完整度分成三个问题
VirSorter2 通过基因和相关特征识别候选病毒序列,结果里同时给出不同分类器的分数。它适合提供候选筛选证据,但这些分类器的名称不能直接作为可靠的分类学结论。作者也明确说明,不同分类器的适用序列空间可能重叠。项目说明
识别候选回答的是“这段序列是否具有病毒相关信号”。分类学判断还需要考虑不同层级的证据,完整度则涉及输入覆盖了多少基因组以及是否存在宿主片段等问题。把这三件事都交给一个最高分字段,会让后续报告超出工具实际支持的范围。
对于读者来说,一个实用习惯是为每条重点候选保留不同问题的证据列。候选识别记录来自哪个工具、分数和标记支持,边界记录输入与输出之间的对应关系,质量评估记录专门方法的结论。这样即使以后调整某一环节,也能知道哪些判断需要跟着更新。
二、本次输入与参数有什么边界
输入包括公开 lambda 参考 NC_001416.1 的全长序列,以及它的前二万四千二百五十一、五千、两千和五百碱基。另外加入公开大肠杆菌参考的前五万与两千碱基,共七条。截取片段没有人为突变,也没有拼接成假想前病毒。
程序设置最短输入长度为一千五百,因此五百碱基片段在预处理就被移除。日志明确记录移除一条、剩余六条线性序列。这不是该片段经过分类器后得到低分,也不是本文测出了工具对五百碱基病毒的识别能力。
本次只启用 dsDNAphage 和 ssDNA 两组分类器,使用两个计算线程。选择范围需要与研究问题一致,本文没有运行 RNA、NCLDV 或其他分类器,因此不能把结果写成对所有病毒类型的全面测试。
四组分别为普通筛选、高置信度筛选、最低分提高到零点九九、保留原序列。后三组复用已有特征进入 classify 阶段,并使用不同标签保存输出。这样既保留了对照,也避免因为新结果覆盖旧文件而失去差异记录。
三、安装成功不只意味着版本命令能执行
本次先固定容器镜像,再按该安装包提供的依赖清单建立分析环境。主程序能够输出版本,并不意味着每个子步骤需要的库都已经准备好。初次运行就在预处理处遇到缺少 screed 的错误,问题出在子步骤实际使用的 Python 环境。
我们已经建立了依赖环境,但容器的启动入口重新设置了路径,覆盖了外部传入的设置。检查实际 PATH 和 Python 位置后,改为明确指定启动入口,让分析步骤使用已经安装的依赖,随后四组运行均完成。这个经验比简单地反复安装同一个包更值得保留。
排查类似错误时,可以先确认报错发生在主程序还是子流程,再查看该步骤实际调用的解释器。交互环境里能够导入某个库,并不能保证任务启动后仍使用同一环境。应从失败日志中的具体命令追踪,而不是只查看当前终端的环境名称。
数据库下载也需要核验。本次完整压缩包约十五亿字节,解压后明显更大,不能只按下载包大小估计空间。分段下载完成后核对总长度、压缩包 SHA256,并将七个主要数据库文件的 MD5 与作者安装规则逐项比较。实际校验值记录在复现包中。
下载链接存在短时有效期,最初重复使用同一跳转地址导致后续分段返回拒绝访问。更新下载请求并保留已验证片段后完成续传。这里没有改变数据库内容,也没有用不同来源的小压缩包校验值去核对这个完整数据库包。作者数据库安装规则
四、四组结果应该怎样读
普通筛选得到四条病毒候选,均来自长度至少两千的 lambda 输入,两条细菌片段未进入最终候选。高置信度筛选仍保留四条,提高最低分到零点九九后保留三条,去掉的是两千碱基输入对应的候选。
| 输入片段 | 输出 bp | 分数 | 标记数 | ≥0.99 |
|---|---|---|---|---|
| 全长 | 47754 | 1.000 | 21 | 保留 |
| 前半段 | 23728 | 0.993 | 19 | 保留 |
| 前 5000 | 4809 | 1.000 | 4 | 保留 |
| 前 2000 | 1810 | 0.980 | 1 | 排除 |
高置信度选项与“把阈值设为零点九九”并不是同一个条件。本次安装包帮助显示,高置信度依据最高分至少零点九,或者最高分至少零点七且至少有一个标记基因。四条候选都满足前一条,因此全部保留是符合规则的。
这也说明,筛选没有改变时应先核对输入是否本来就都满足条件。不能因为两张结果表一样,就断言选项失效。相反,提高阈值后少了一条,也不代表其他候选的生物学状态发生变化,只是它们与新判定规则的关系不同。
表里显示为一的分数是工具输出格式下的模型结果,不是对真实身份绝对无误的承诺。本次使用已知参考和重叠片段,也没有足够的独立样本来估计真实环境中的误判率,不能用四条命中去包装一个总体准确率。
五、full 后缀与序列长度,必须用文件核对
四条默认候选的名称都以 ||full 结尾,但它们的 FASTA 长度全部短于输入。全长输入少了七百四十八碱基,前半段少了五百二十三,五千片段少了一百九十一,两千片段少了一百九十。这里的 full 表示候选在整体上的病毒信号状态,不保证完整保留输入,也不等于完整基因组。
保留原序列的对照使用 --keep-original-seq。实际输出长度分别恢复到 48502、24251、5000 和 2000,序列校验值逐条与输入一致。这给出比“文件看起来差不多”更明确的证据,说明本次该选项确实改变了导出的 FASTA 内容。
virsorter run -w result -i inputs.fna -d db \
  --min-length 1500 --include-groups dsDNAphage,ssDNA \
  -j 2 all

virsorter run -w result -i inputs.fna -d db \
  --min-length 1500 --include-groups dsDNAphage,ssDNA \
  -j 2 --label original --keep-original-seq classify
这段展示常规调用关系。复现包中的固定环境采用单独安装的依赖,实际还使用了对应的环境设置与 --use-conda-off,完整命令见包内说明。读者不要只复制其中一个环境选项,却遗漏它依赖的安装步骤。
一个尤其容易遗漏的细节是,保留原序列这组的评分表 length 列仍然记录修剪候选的长度。例如,全长输入对应评分表写的是 47754,但该组导出的 FASTA 实际长 48502。因此,准备下游文件时应该实际读取 FASTA 长度,而不是假定任意模式下评分表的一列都代表最终导出长度。
六、边界坐标怎样核验,才能避免错位
默认边界表中,全长输入的修剪起止为 191 与 47944。按一起始、终点包含的方式计算,长度为 47944 减 191 再加一,得到 47754。我们进一步从输入中提取对应片段,比较 SHA256,与默认输出完全一致。
其余三条也完成了同样核验。前半段边界为 191–23918,五千片段为 191–4999,两千片段为 191–2000。仅验证长度相等还不够,因为同长度的错误区间也可能存在,序列校验值可以检查提取内容是否一致。
from hashlib import sha256

start, end = 191, 47944
fragment = input_sequence[start - 1:end]

assert len(fragment) == 47754
assert sha256(fragment.encode()).hexdigest() == output_sha256
将结果转成 BED 或用于其他坐标体系时,需要在这个已核验的基础上转换。不要把一种格式的起点直接复制到另一种格式,再靠肉眼看长度大概正确就结束。对于一条重点序列,先做逐碱基或校验值验证,可以尽早发现系统性偏移。
边界表也不能一概当作最终候选清单。作者说明它包含中间信息,某些设置下可能出现额外记录或与最终评分字段不完全一致的字段。因此本次先以最终候选名称和 FASTA 对应,再使用边界表解释来源,而不是把所有边界行都直接算成独立病毒。
七、两个分类器都给高分,不等于两种基因组类型同时成立
两千碱基候选在 dsDNAphage 分类器中的分数为 0.980,在 ssDNA 分类器中为 0.953。已知它来自同一条 lambda 参考,不能据此声称我们找到了一个同时具有两类基因组属性的新对象。这正好说明分类器分数不能按互斥分类概率直接阅读。
同样,最高分所在组只是当前几个分类器之间的比较结果。若改变启用的分类器范围,可比较的对象也变了。做跨样本汇总时应记录所用组别,并将这个字段与正式分类学注释区别开,避免用它直接生成物种或科属组成图。
标记基因数也需要结合长度理解。全长候选有二十一个标记,两千碱基候选只有一个,两者都能通过本次高置信度规则。不能把标记数简单转换成完整度百分比,因为不同序列覆盖的区域、基因组成和所用模型都不同。
本次没有识别到 partial 形式的候选,也没有构造宿主与病毒拼接的输入。因此,我们没有实际测出前病毒边界识别的表现。若研究目标正是前病毒,应另准备能够核对边界的对照,并在后续使用专门的质量评估方法复查宿主片段。
八、把结果交给下游前,保留哪几层信息
至少保留原始组装、默认候选 FASTA、评分表、边界表和完整命令。若选择导出原序列,也应与修剪结果分开保存,不要让同名文件在不同步骤代表不同碱基内容。候选名称相同并不保证序列内容相同,本次已经给出了实际例子。
对于后续基因注释或覆盖计算,应明确使用哪一版序列。基于修剪序列得到的坐标,不能直接套到原始序列上,也不能因为名称相同就自动拼接不同结果。必要时保留输入名称、候选名称、起止和长度的映射表。
VirSorter2 的优势是能够提供较丰富的候选证据和边界信息,并允许复用特征调整筛选。它的局限在于候选识别、分类学赋值和完整度评估仍需分别完成。参数越多,越需要围绕研究问题设置对照,而不是把所有选项同时打开后只看候选数量。
下载本组复现材料可获得固定镜像与依赖清单、数据库核验记录、公开参考来源、四组实际结果和边界校验脚本。建议先复查全长输入的长度变化,再用同样方法检查自己的重点候选。
当候选筛选和边界核验需要覆盖多批次组装,并稳定保存数据库、环境和结果版本时,可以了解云生信生物信息分析环境服务。


