
同事交来一份结构变异 VCF,希望把新连接处的未知碱基提取成 FASTA,再去做序列比对。看似简单,却有两个常见误差,替代字符串里含有参考锚点和远端坐标,不能整串当作插入序列。一条结构连接的两端又可能分别产生 FASTA 条目,不能拿条目数当成事件数。我们安装 GRIDSS2 的正式发行包,用它自己的序列导出工具检查五条边界已知的断端记录,并对最短序列长度做了四次对照。
一个断端字符串里,哪些字符是碱基证据
VCF 中的断端可以只知道一端,例如局部组装得到一段伸出已定位区域的序列,却无法可靠定位另一端。它也可以明确写出另一条染色体、连接位置及方向。前者的替代字符串可用点标示未知方向的远端,后者用成对方括号包住伙伴位置。连接的一侧还保留一个参考锚点,以便固定本地坐标。锚点虽然是一个真实碱基,却原本就存在原位,不能自动算成新插入的一个碱基。VCF 规范的断端表示
GRIDSS2 的导出子程序读取这个结构,取得该条断端里显式报告的连接处序列,只有序列非空且达到给定长度才写入 FASTA。它是结果解读的一环。本次输入是为了检验格式规则而构造的记录,整个实验从已知 VCF 起步,没有从测序读段重新运行断点组装。若研究的是某种真实病毒插入或重复扩增,导出的碱基本身仍需回到原始组装和覆盖证据复核。GRIDSS2 发行版中序列导出的实现
实跑经验|从四份 FASTA 找回锚点、伙伴与长度门槛
我们运行 GRIDSS2 2.13.2 的 InsertedSequencesToFasta,给输入 VCF 保留两条染色体的头信息,并给每行单独命名。第一行只有锚点和未知远端。第二、第四行是单断端,各设计三枚待提取碱基,但参考锚点分别在字符串的一侧和另一侧。第三、第五行互相列为伙伴,在各自的断端描述中都安排了相同的两碱基序列。每次运行只更改最短序列长度,独立解析每个 FASTA 记录名和序列。GRIDSS2 上游的公开发行包
| 输入记录 | REF 与 ALT | 最短 1 或 2 bp | 最短 3 bp |
|---|---|---|---|
| plain | A,A. | 无条目 | 无条目 |
| single3 | C,CAGT. | AGT | AGT |
| other_anchor | T,.CCTT | CCT | CCT |
| pairF 与 pairR | G,GAC[chr2:401[ / T,]chr1:202]ACT | 各输出 AC | 两者均无条目 |
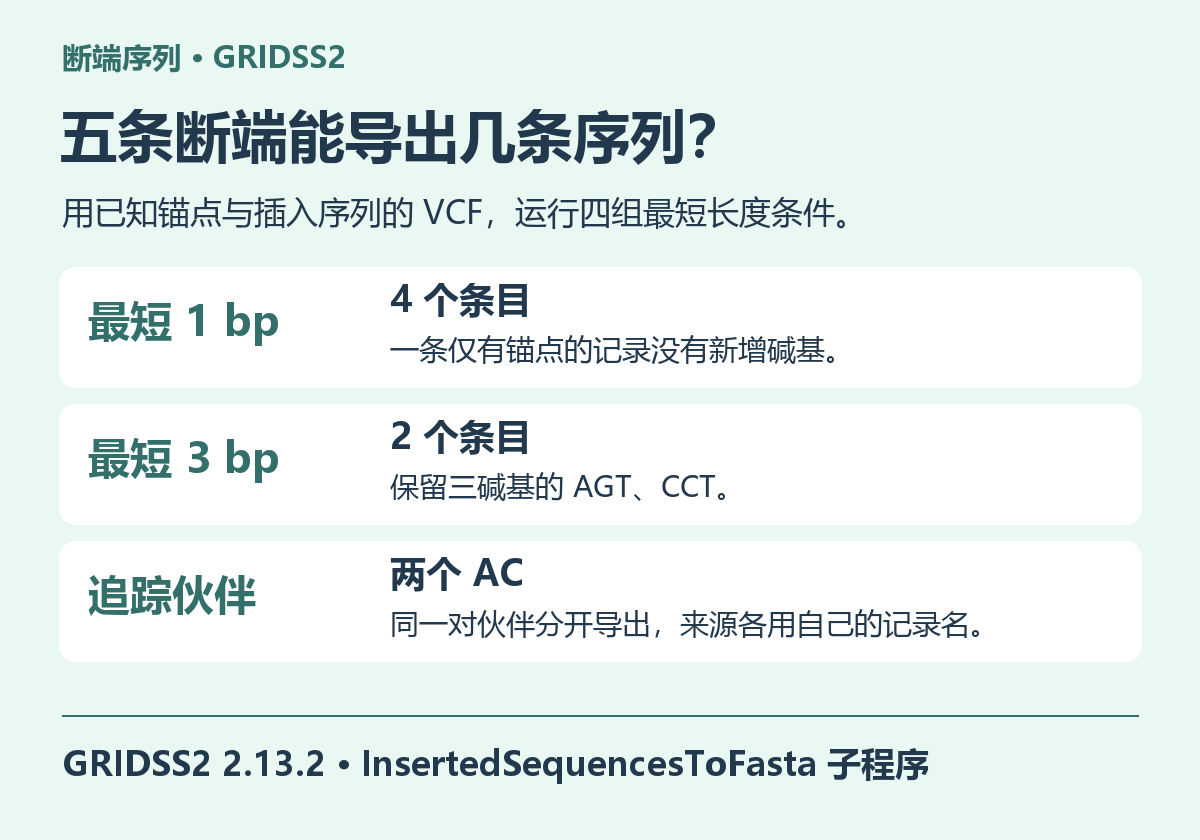
最低长度为一时得到四条,最低长度为二时仍有四条。一和二门槛下的内容完全相同,因为这份输入没有长度恰为一的新增序列。调到三以后,只有两个单断端保留下来。调到四,输出文件存在,但没有任何 FASTA 条目。对第一行而言,点前的 A 与参考 A 是同一个锚点,去掉后没有额外序列,所以它在所有设置下都不会出现。若下游误把空文件当成程序崩溃,只需先查退出状态、输入记录数和各条新增序列长度,就能分辨过滤结果与执行错误。
第四行很适合抓取手写解析器的错误。它的替代字符串以点开头,结尾包含两个连续的 T,末端那个 T 是参考锚点,导出结果是 CCT。若一律去掉第一个碱基,会误删属于新增序列的 C,同时留下原本应剔除的锚点。成对断端的两条记录则要同时处理括号位置、远端坐标和本地参考碱基。这里导出的两个 AC 各自沿用输入记录标识,即使序列完全一样,也依然是两个带有不同来源标识的输出。GRIDSS2 对断端方向和插入序列的解析
java -Xmx256m -cp gridss-2.13.2-gridss-jar-with-dependencies.jar \
  gridss.InsertedSequencesToFasta INPUT=calls.vcf OUTPUT=min3.fa MIN_SEQUENCE_LENGTH=3
awk '/^>/{n++} END{print n+0}' min3.fa
还可以对导出文件做一次碱基总量核算。门槛为一或二时,两条三碱基和两条二碱基相加,总共十个碱基。门槛为三时,只剩六个碱基,记录数减半,碱基数却保留了六成。若读者把“保留一半记录”写成“损失一半序列长度”,在这个极小样例上就能发现错误。面对长度跨度很大的真实插入,两个比例的差异会更大。
保存复核表时可顺手生成三个能复算的计数,输入断端有几条、含显式新增序列的有几条、达到当前最短长度的有几条。若导出之后还按完全相同的字符串合并,则再单列唯一序列数。本例低门槛有四个条目,却只有三个不同字符串。即使一个项目的唯一序列数与推测的连接数偶然相等,也需分别记录,因为没有伙伴的两个单断端并未告诉我们远端连接到哪里。
将导出片段送去搜库前,如何决定统计单位
如果目的是给断端加序列注释,应先保存 FASTA 标题与原 VCF 标识的对应。这样即使两条查询的序列相同,也能分别写回其来源位置。若目的是以连接为单位汇总,需要先按互指的伙伴标识确认哪两条描述同一连接,再决定选哪一侧的序列和方向。一味按序列去重有相反风险,原本来自两个不同位置的独立插入也可能恰好具有相同短序列。用伙伴关系解决事件归属,再按检索需要处理序列冗余,两种操作应各自留下记录。
长度门槛也有研究后果。它可以排除只带一两个碱基、几乎不可能仅靠序列唯一定位的查询,也会把真实存在的短插入排除出后续分析。若项目要统计一到几碱基插入的频谱,不能用最短三碱基的 FASTA 作为完整分母。可先从原 VCF 统计带有插入序列的断端数及长度分布,另列达到检索长度要求的子集。对更长的序列,还应查看低复杂度、重复、宿主同源及覆盖范围,不能仅凭一个不够特异的短命中判定外源来源。
在真实结果中,有些断端的重点正是远端位置尚不明确,空 FASTA 或单断端标签都没有回答整段重排是否存在。可以分别保留断端与伙伴状态、实际提取的碱基数、是否通过检索门槛、后续证据是否足以定位四项。这样即使搜索没有给出明确结果,研究者仍然知道证据在哪一步用尽,也能回到相应样本的组装读段继续检查。
需要在大批量肿瘤样本中批量提取和比对这些片段时,可使用云生信的生物信息分析服务器保存断端、序列与各轮搜库结果的对应关系。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)