
在体细胞结构变异分析中,看到结果表里有一行通过过滤,往往会顺手把它记成肿瘤样本的一次阳性调用。我们给 DELLY 一份公开的 HCC1954 局部肿瘤比对,限定寻找跨染色体断端。程序找出两个候选,其中一个位点标为通过,样本自己的基因型却为参考纯合。换成官方示例中更小的正常对照片段,程序甚至在估计文库参数时就停止了。把这两种情况都保留下来,可以解释为什么位点过滤、样本分型和对照分析分别需要自己的证据。
异常读对提供位置线索,分型又是另一道计算
双端测序时,来自同一片段的两个端一般有特定的方向和距离分布。相邻的一组读对若持续呈现异常方向、过大间距或落到不同染色体,可以为结构变异提供候选。裂分读段则能把同一个端的两部分分别贴到连接的两侧,帮助进一步缩小断点区间。DELLY 把发现与对给定位点重新分型分成可以单独运行的步骤。发现阶段保存“这里有一组值得检查的证据”,分型阶段另外比较每个样本里支持参考与替代的证据。DELLY 官方工作流程与固定候选分型用法
读取 VCF 或 BCF 时,参考与替代、两侧连接方向和位置范围属于具体候选。位点过滤状态在记录的固定列里。读到样本列后,才有该样本的基因型、基因型质量、样本过滤状态和参考或替代支持数。一个位置上有九对异常读段,说明存在九对指向候选的证据。要判断这个个体是否被分出替代基因型,还应同时看有多少参考读对以及程序采用的模型。配对肿瘤项目则需再加入正常样本的分型与相应筛选。单样本位点通过与体细胞状态之间不能划等号。
实跑经验|九对替代支持与四百四十四对参考支持出现在同一行
我们安装 DELLY 1.1.8,使用 Manta 发行包附带的 HCC1954 局部演示数据,沿用其参考和原始 BAM。首先对肿瘤样本单独发现跨染色体断端,然后把发现结果作为已知位点,仍在同一肿瘤样本上重新分型。这样可以在处理完全相同数据的条件下分开检查两步。程序估计读长一百零一,配对片段长度中位数三百三十六,中位绝对偏差十二。此次局部数据不代表患者全基因组,也没有独立的肿瘤临床判定。本次比对文件所在的公开演示包
| 肿瘤单独发现并重新分型 | 第一条跨染色体候选 | 第二条跨染色体候选 |
|---|---|---|
| 11 号染色体起点/8 号伙伴位置 | 94975643/107653522 | 94987785/107653404 |
| 位点过滤/样本过滤 | PASS/PASS | LowQual/PASS |
| 参考读对 DR/替代读对 DV | 444/9 | 379/4 |
| 重新分型的 GT/裂分支持 RR、RV | 0/0/0、0 | 0/0/0、0 |
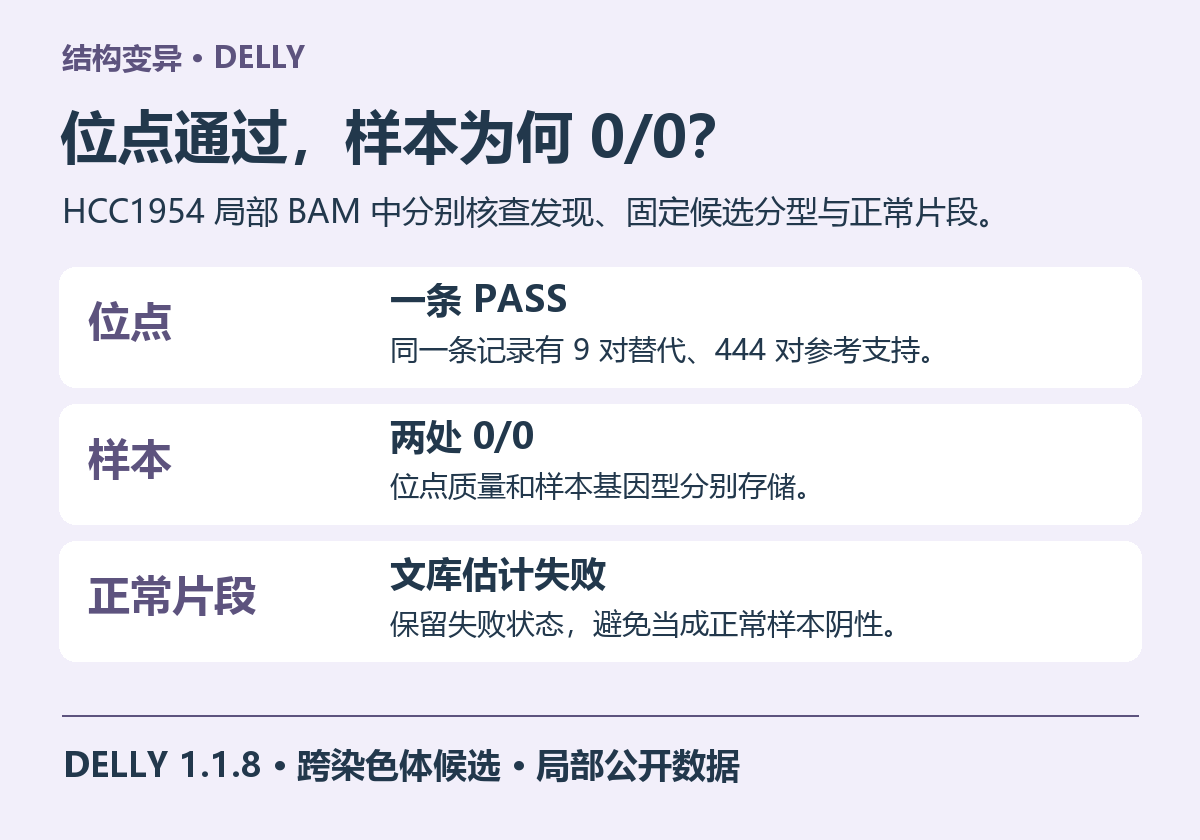
两个候选在发现与重新分型结果中都可逐项找回。第一条在十一号与八号染色体之间记录一个连接,偏移置信区间前后三百八十二个碱基,样本列没有参考或替代的裂分读段计数。若只在读对这一类证据中手算,九除以四百四十四加九,约百分之二。这个比例描述特定证据类别,不能直接解释为肿瘤纯度、克隆比例或每个细胞携带该重排的概率。第二条对应四对替代、三百七十九对参考,位点被标为低质量,但样本过滤字段仍为通过。这再次表明两个过滤字段管的不是同一件事。
固定候选重新分型的日志里,单独列出的软件发现统计可以与第一次不同。本例第二次的“独特异常读对”发现统计显示为零,但输出两行的样本支持数仍是九和四。若只摘取执行日志最后一个计数,就会错报“重跑后已无任何替代证据”。先问这一行日志来自发现还是分型,再打开固定候选上的样本字段,比在日志里寻找一个能代表整个项目的数字更可靠。
delly call -t BND -g reference.fa -o tumor.bcf tumor.bam
delly call -t BND -g reference.fa -v tumor.bcf -o checked.bcf tumor.bam
bcftools query -f '%CHROM\t%POS\t%FILTER[\t%GT:%FT:%DR:%DV:%RR:%RV]\n' checked.bcf
抽查第一条还可以发现,本地记录的结束字段位于十一号染色体起点附近,真正指向另一条染色体的位置另写在伙伴染色体及伙伴坐标字段中。画断点图时若误拿本地结束坐标作第二端,会把一个跨染色体候选画成相邻两个碱基之间的小事件。把替代字符串、方向与伙伴坐标互相对照,能提前发现这类字段映射错误。
正常样本太小而失败,结果应该记成什么
配对示例的正常片段共有一千一百七十九条比对记录,肿瘤片段有一万一千一百九十四条。软件对正常样本的独立调用明确报“数据不足以估计文库参数”,返回失败。我们依次排除第二端、未比对、次要、补充、重复与未通过质量检查的记录,正常片段只剩五百一十三行,肿瘤片段还有四千五百二十行。这个手动统计用于核查可供估计的数量级。版本源码还会检查读长、配对及其他条件,并为读长分布和插入距离的估计分别要求足够观测。原始行数多于一千并不保证能通过估计。DELLY 1.1.8 文库估计的实际筛选条件
这个正常样本应记录为本次局部输入未完成分型。若将报错解释为“正常中未检出”,两条肿瘤候选就可能被错误升级为肿瘤特异证据。在真实项目中,可以回到同一正常样本的完整、已正确建索引的比对文件,保留原始文库分布,在确定的候选上重新分型。同时确认两份样本身份、参考序列、比对方法及对照位点的可用覆盖。单纯复制有限的正常读段来凑够记录数只会增加重复观测,不会恢复真实文库的片段长度分布。
交付断点表时,可以把两侧坐标与方向、区间宽度、位点过滤、每个样本的基因型与读对证据,以及正常分型是否成功分别列出。后续人员就能看出需要的是补全正常数据、复核异常读段、定位更准确的连接,还是在更完整的队列中查该候选的出现频率。
要将候选发现与配对复核推广到整批样本,可使用云生信的生物信息分析服务器集中保存原始比对、候选列表和各样本的重新分型结果。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)