
长读长 RNA 定量中,一个常见困惑是基因层面有十八条支持,把该基因下面的转录本加起来却只有十四条。有人据此怀疑结果丢失,也有人直接把差额平均补回去。两种处理都跳过了关键问题,同一条读段是否真的包含足够的信息,让我们区分这个基因的不同转录本。
本篇实际安装并运行 IsoQuant 四点一点零,用二十二条已知来源的人工序列比较三种计数策略。读者可以跟着结果追踪完整读段、部分剪接链和共享外显子如何进入不同表格,理解差额的来源,并建立一套不依赖猜测的核对方法。
先区分定位、分配和计数
读段成功定位到基因组,只回答了它与哪个位置相容。把这个位置与注释比较,才能判断它与哪些转录本相容。随后,计数策略还会决定哪些匹配关系可以贡献权重。这三个环节有关联,却不是同一个判断。
例如,一个基因的两种转录本共享最后一个外显子。读段如果只覆盖这一段,即使定位完全正确,仍然无法告诉我们它来自哪一种转录本。增加比对质量门槛,不会凭空补出读段没有覆盖的上游剪接信息。
反过来,读段没有覆盖完整转录本,也可能包含某种结构特有的连接,从而只与一个候选相容。完整程度和可区分程度需要分别检查,不能把所有短于参考的读段都归入同一类。
IsoQuant 可以进行参考定量和新模型发现。本次显式只启用参考定量,让比较集中在分配和计数规则上。实际没有执行新转录本发现、单细胞条形码识别或分子去重。IsoQuant 输出说明
二十二条序列的设计
人工基因组使用固定随机种子生成。基因 geneAB 有两个注释转录本,A 包含第一、第二、第三外显子,B 跳过中间外显子。另一个独立基因 geneC 只有转录本 C,用来观察无歧义目标在不同归一化分母下的变化。
输入包含八条完整 A、四条完整 B、四条完整 C。另外加入两条只包含 A 的第二和第三外显子的部分读段,以及四条只覆盖 A、B 共享末端外显子的读段。序列由参考直接拼接,不含模拟测序错误。
| 输入类型 | 条数 | 覆盖结构 |
|---|---|---|
| fullA | 8 | A 的三个外显子 |
| fullB | 4 | 第一与第三外显子 |
| partialA | 2 | 第二与第三外显子 |
| sharedE3 | 4 | 共享的第三外显子 |
| fullC | 4 | 独立基因的两个外显子 |
这个设计故意同时包含两种不完整读段。部分 A 保留了只有 A 拥有的剪接连接,共享末端则完全不具备区分 A 和 B 的信息。两者都不覆盖整个注释模型,但信息价值不同。
这些是规则检查用的人工输入,不代表任何物种的真实表达比例,也不能用来计算工具在真实样本中的准确率。重复生成相同序列只用于形成容易手算的支持数量,不是生物学重复。
安装与命令要对应当前版本
本次从固定摘要的容器运行,实际版本输出为四点一点零。最初用旧入口名检查时提示找不到程序,改用容器中的统一入口后正常执行。因此,安装包存在与命令入口正确需要分别验证。
IMAGE=quay.io/biocontainers/isoquant@sha256:bb3f1a20ada92f7a921789e894bcbcc17b197c780a3711e353bd784529ddd39b
docker pull "$IMAGE"
docker run --rm "$IMAGE" isoquant --version
docker run --rm "$IMAGE" isoquant --full_help
完整驱动下载后在 Linux 主机运行。它负责生成参考、注释和序列,调用容器执行三组分析,保存原始表格与结果摘要。每个容器限制两个处理器和四 GB 内存,这只是本次小实验的执行条件,不是大样本资源建议。
python3 150-isoquant/run.py results/isoquant
下面是容器内唯一分配组的核心命令。参考文件包含基因和转录本层级,因而使用完整注释开关。如果自己的文件只有外显子行,不能不检查结构就照搬该开关。
isoquant --reference genome.fa \
  --genedb known.gtf --complete_genedb \
  --fastq reads.fa --data_type pacbio_ccs \
  --stranded forward --analysis quantification \
  --transcript_quantification unique_only \
  --gene_quantification unique_splicing_consistent \
  --large_output read_info read_assignments read2transcripts \
  --threads 2 --prefix toy --output unique_only
三组使用相同输入和参考,仅修改转录本计数策略及输出目录,基因策略始终固定。日志显示二十二条主比对、零条未比对,后续组复用了已缓存的同一比对文件。三次流程均正常结束,不能把结果差额解释成部分序列没有映射上。
第一组,唯一归属仍然可以接受部分读段
唯一分配组中,A 得到十,B 得到四,C 得到四。A 的十由八条完整读段加两条部分读段组成。逐读段记录明确标注,部分 A 属于唯一分配,同时具有不完整剪接匹配事件。
这并不矛盾。它缺少第一个外显子,但第二到第三外显子的连接能排除跳跃中间外显子的 B。因此,在当前参考集合里,部分 A 仍有明确的候选归属。
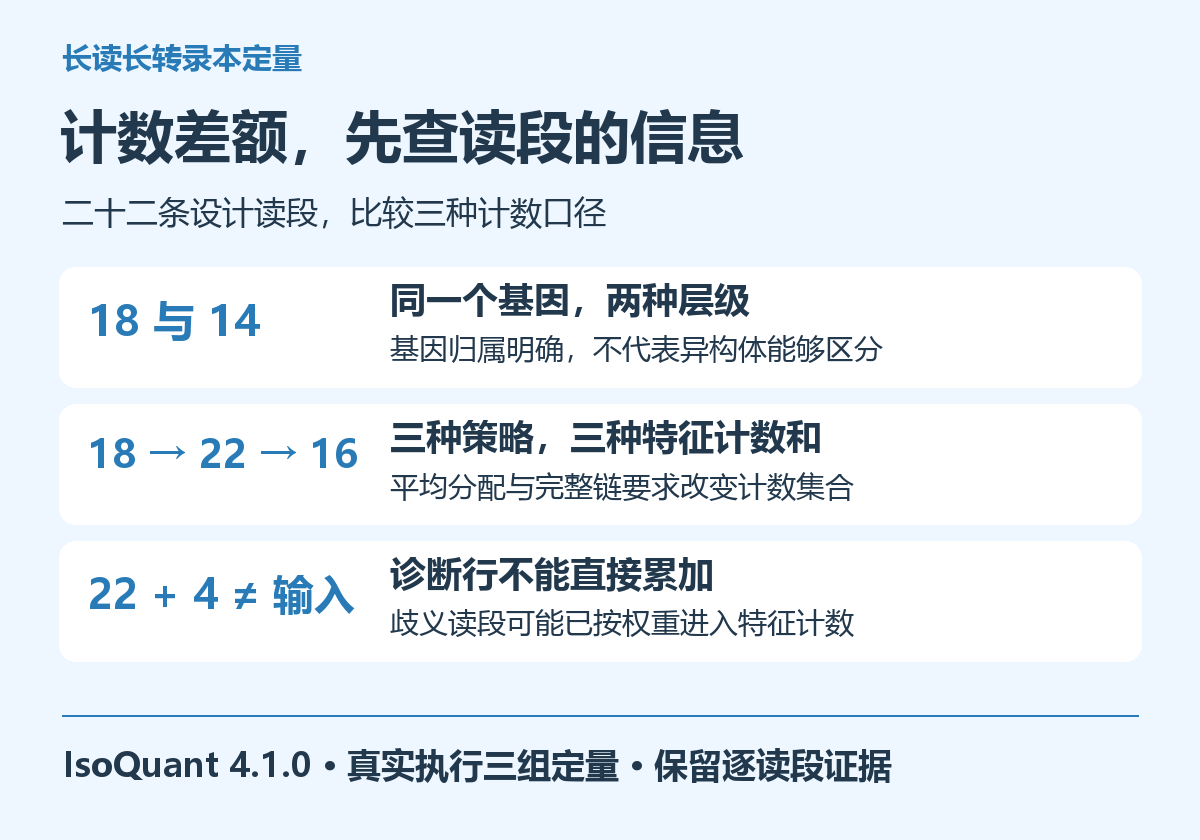
四条共享末端读段则同时与 A、B 相容,在转录本层面记作歧义。它们没有进入该组的转录本特征计数,但在基因层面都明确属于 geneAB。所以 geneAB 的计数为十八,而 A 与 B 之和只有十四。
遇到类似差额,第一步应当回查读段分配,而不是直接判定基因表或转录本表有错误。同一条证据在较粗层级足够明确,在更细层级信息不足,是正常且有解释价值的结果。
第二组,平均分配改变了权重,没有增加信息
允许歧义分配后,A 从十增加到十二,B 从四增加到六,C 保持四。四条共享末端读段各贡献半条给 A 和 B,因此两者各增加二。三条转录本的计数之和现在等于二十二。
| 策略 | A | B | C | 合计 |
|---|---|---|---|---|
| 唯一分配 | 10 | 4 | 4 | 18 |
| 含歧义 | 12 | 6 | 4 | 22 |
| 完整链 | 8 | 4 | 4 | 16 |
这里的平均分配是一项计数约定。它没有证明四条共享序列中恰好两条来自 A、两条来自 B。读段本身仍然缺少能够区分来源的区域,因此歧义状态并没有消失。
也不能因为原有明确支持是十比四,就自行把共享读段按十比四分开,并声称这就是本次软件结果。当前实验观察到的是等权分配。若要采用另一个概率模型,需要明确相应方法和假设,不能悄悄替换输出含义。
官方参数说明列出了唯一分配、允许歧义以及完整剪接匹配等策略。本次用可手算输入验证了其中三种,没有对其他策略作性能比较。IsoQuant 定量参数
第三组,更严格不等于所有结果更可信
完整剪接匹配组的 A 降到八,B 和 C 仍为四,总计十六。两条部分 A 虽然能够唯一归属,却不再符合这组对剪接链完整程度的要求,因此没有贡献转录本计数。
这说明更严格的规则可以舍弃本来具有明确归属的信息。它适合什么问题,要由研究目标决定。如果重点是检查完整剪接链支持,严格集合具有价值。如果重点是汇总可明确归属的所有读段,只保留完整链可能损失有效信息。
实际样本中,截短程度还可能受文库、样本质量和转录本长度等因素影响。比较不同样本时,应检查这些因素是否系统性不同。不能只看到严格规则下某个转录本减少,就把减少全部解释成生物学表达降低。
本次没有开启把读段两端都视为可靠完整边界的选项,因为输入明确包含部分序列。参数应当描述数据实际具有的证据,而不是为了让输出更漂亮就把部分读段声明成全长。
计数文件中的特殊行不能一起相加
这次还出现了一个很容易让汇总脚本出错的细节。允许歧义分配组的三条转录本已经合计二十二,但文件末尾仍有值为四的歧义统计行。若把所有数值行直接求和,就会得到二十六。
feature_id       count
A                12.00
B                 6.00
C                 4.00
__ambiguous       4
__no_feature      0
__not_aligned     0
这里的四条歧义读段已经通过权重进入 A 和 B,特殊行仍记录其分配状态。它不是一个可以与特征计数并列相加的额外转录本。导入矩阵时,应先分离实际特征与诊断统计,再分别保存。
另一个反例来自完整剪接匹配组。特征和为十六,加四条歧义只有二十,并不能还原二十二条输入。那两条被策略排除的唯一部分匹配,也没有自动成为无特征读段。因此,不能假定几个末尾统计行一定构成互斥、穷尽的分类。
更可靠的办法是先定义核对对象。检查输入数量,用日志或按读段去重的分配记录。检查贡献权重,用特征计数。检查歧义程度,用分配状态。三个问题分别计算,避免用一张表的行和包办所有审计。
分配表也不是每行一个独立读段
允许歧义组的旧式分配表共有二十六条数据行,却只有二十二个不同读段名字。原因是每条共享末端读段分别列出与 A、B 的匹配关系,四条读段产生八条关系记录。
直接统计分配表行数,会把候选关系数误当成序列数。反过来,如果为了去重只保留每个名字的第一行,又会抹去歧义的第二个候选。正确处理取决于目的,计算独立读段数时去重,检查候选集合时保留全部关系。
本次同时保存新版逐读段信息文件和显式请求的旧式分配表,方便对照。正式脚本应锁定版本与列名,不依赖固定列位置,更不能把带注释的命令行记录当成表头。
import csv, gzip

path = "with_ambiguous/toy/toy.read_assignments.tsv.gz"
with gzip.open(path, "rt") as handle:
    rows = list(csv.DictReader(
        (line for line in handle if not line.startswith("#")),
        delimiter="\t"
    ))
print("关系行", len(rows))
print("独立读段", len({row["read_id"] for row in rows}))
这个检查在本次结果上分别得到二十六和二十二。随后按名字收集候选集合,可以直接定位四条共享末端读段,而不必从最终总数倒推发生了什么。
同样四条 C,归一化结果也会变化
C 在三组中都只有四条支持,但转录本 TPM 分别约为二十二万二千二百二十二、十八万一千八百一十八和二十五万。输入没有改变,变化来自不同策略纳入的总计数不同。
这组现象提醒我们,相对量会受到其他特征是否进入分母的影响。它不意味着 C 的原始支持增加或减少。跨分析比较 TPM 时,必须同时核对计数口径、参考集合和过滤规则。
本实验里,各组 TPM 与四除以该组特征计数和再乘百万一致。这里报告的是实际输出关系,不把其他软件的有效长度校正方式自动套过来,也不据此把长读长结果与短读长结果直接横向相减。
如果需要比较异构体使用比例,可以先明确分母是同一基因内的可计数读段,还是全部输入读段。前一种适合描述已分配集合内部的比例,后一种保留未解决信息的份额。两者都需要清楚标注,不能混用。
把实验经验带到真实项目
实际分析前,应先核对基因组与注释版本、染色体命名、链方向和转录本层级。输入已经是比对文件时,还要确认排序与索引,并保存生成比对文件的方法。参考不一致造成的异常,无法靠改计数策略解决。
分析后,可以挑选一个基因,依次查看完整匹配、唯一部分匹配和歧义读段。把外显子结构、候选集合、计数贡献放在同一张小表中,比只观察全局比例更容易发现理解错误。
对于注释不完整的区域,唯一分配也只是当前候选集合内的唯一。若后来增加一个相容转录本,原先明确的读段可能变成歧义。因此,结果应与参考版本共同保存,更新注释后需要重新评估细粒度解释。
本次人工序列没有附加多聚腺苷尾,日志对此给出提醒。由于实验只做参考定量,我们保留该事实并解释用途。若要转向新模型发现,需要重新考虑端点证据,不能为了消除提醒而随意声明所有读段已经通过尾部核验。
IsoQuant 的优点是把读段分配、基因与转录本定量放在同一分析框架中,便于追溯计数变化。实际限制是结果依赖输入结构信息和参考候选集合,软件无法从共享片段中恢复未观察到的区别。保留歧义通常比强行给出一个确定来源更有助于后续判断。
复现实跑结果
下载本组三篇的驱动、预期结果与说明。本篇附带固定摘要容器、参考构造、三组命令、全部计数和逐读段记录。重跑时使用新的输出目录,先核对二十二条输入、三组特征和及四条歧义,再检查自己关心的字段。
当这些基本关系能够手算并与文件一致,再把同样的核对方法应用到真实数据。比起追求所有表格总和看起来一样,更值得坚持的是每个数字都能解释它统计了什么、排除了什么。
如果后续需要持续开展长读长转录组分析,可了解云生信生物分析服务器服务,统一维护分析环境与结果归档。


