
做完基序分析,结果表里有几百条命中、几个很小的显著性数值,再加上一张熟悉的序列标志图,很容易马上得出“这个转录因子被激活”的结论。但从序列模式到真实结合,中间有多个需要分别验证的环节。命中了多少行、多少区域含有命中、相对什么背景富集,以及模式能否唯一指向某个蛋白,回答的是不同问题。
本文介绍 MEME Suite 常见结果的阅读方法,并提供已执行的自编读表与统计练习。本文没有安装或运行 MEME Suite,也没有产生真实的基序扫描、发现或富集结果。套件的官方许可说明对商业用途另有联系要求,本次采用公开文档解读与原创教学数据,所有练习数字都明确保留其来源,不能当作软件实测性能。
一、先根据问题选工具,不要根据熟悉的名字选
如果不知道序列中可能有什么共同模式,需要的是发现基序。如果已经有一组基序,想知道它们出现在什么位置,需要的是扫描。如果关心一组区域是否更常出现某类模式,需要的是富集比较。如果已经发现一个模式,想了解它与已有数据库中的哪些模式相似,需要的是基序间比较。
| 研究问题 | 可查阅的套件工具 | 首先审阅的对象 |
|---|---|---|
| 序列里有什么富集模式 | STREME | 输入集合、背景和发现结果 |
| 已知模式出现在哪里 | FIMO | 位点、序列和阈值 |
| 模式在目标集合中是否富集 | AME | 比较设计与背景 |
| 发现的模式像哪些已知模式 | Tomtom | 模式相似性与匹配范围 |
工具名称不是结论名称。扫描得到一个位点,不代表已经检验了目标集合的富集。富集得到一个家族相关模式,也不代表该家族某个特定成员一定在这些位置结合。选择工具以前,把预期结论写成一句能够被检验的话,通常能减少后面拿错字段解释的风险。各工具的具体输入应以相应版本文档为准,不能把这张问题对应表当作完整运行流程。
二、先数行,还是先数区域
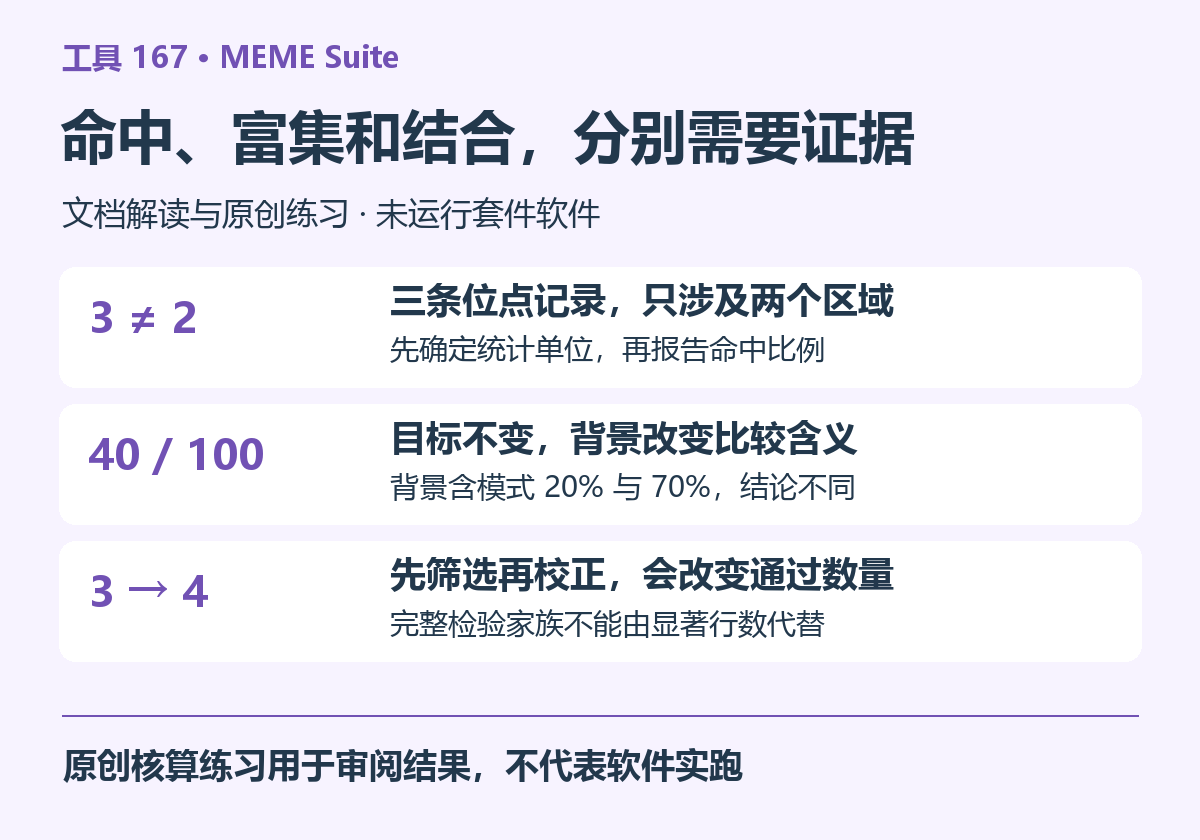
我们编写了六条人工位点记录,不借用任何实际基序数据库。甲模式在第一区域出现两次,在第二区域出现一次。乙模式在第三区域的同一个区间分别记了正负两条链。丙模式在第四区域出现一次。脚本分别统计行数、不同序列数和忽略链后的区间数。
| 人工模式 | 表格行数 | 含命中的序列数 | 不区分链的区间数 |
|---|---|---|---|
| 甲 | 3 | 2 | 3 |
| 乙 | 2 | 1 | 1 |
| 丙 | 1 | 1 | 1 |
如果问题是“有多少区域含甲模式”,答案是二,不是三。如果问题是“甲模式在这些区域有多少处位置记录”,才考虑三条位点。若把位点行数直接除以区域总数,会出现比例超过百分之百的情况。这不一定是程序错误,而可能是分子和分母根本不是同一个统计单位。
乙模式特意采用反向互补后不变的回文序列,同一个坐标区间出现两条链记录。该例可以帮助理解为什么两行未必代表两个不同位置,却不意味着所有实际结果都应该无条件删除相反链记录。是否合并,需要依据研究问题、模式本身、坐标与输出规则决定。直接按起点去重,还可能错误合并不同长度或不同模式的位点。
实际整理结果时,建议至少同时保留位点表和区域汇总表。位点表用于定位,区域表用于按区域计数。两表之间使用稳定标识连接,并写明重复记录的处理方法。这样以后改阈值或改背景时,可以重新汇总,而不必从一张已经去重且丢失链信息的表里猜测原始结构。
三、同样四成阳性,换一个背景就可能改变结论
第二个自编练习保持目标集合完全不变,一百个区域里有四十个含模式。第一种背景一百个区域中有二十个含模式,第二种背景一百个区域中有七十个含模式。我们用固定二乘二表计算优势比和单侧富集方向的 Fisher 精确检验,没有运行 AME,也没有模仿它的完整内部流程。
| 对照背景 | 目标含模式 | 背景含模式 | 优势比 |
|---|---|---|---|
| 背景甲 | 40/100 | 20/100 | 约 2.667 |
| 背景乙 | 40/100 | 70/100 | 约 0.286 |
背景甲对应的单侧显著性值约为零点零零一六,背景乙约为零点九九九九九六。目标集合一条都没有改变,结论却从相对富集转向不支持该方向的富集。后一个数值接近一,并不是直接证明“没有任何差异”,更不能自动拿来报告反方向的显著性,因为我们这次固定计算的是富集方向的尾概率。
这个练习的价值在于揭示比较对象。背景不是软件为了凑够输入而要求的一份文件,它定义了“相对于什么更加常见”。若目标区域全部来自开放染色质,而背景随意来自全基因组,发现的模式可能混合反映开放区域的一般特征与真正关心的条件差异。若研究问题是开放区域内部的变化,就需要围绕这个比较重新设计背景。
区域长度也不能忽略。更长的序列通常提供更多可能匹配的位置,即使每个位置的模式倾向不变,区域中至少出现一次的机会也会改变。碱基组成、重复序列比例与可检测范围同样可能影响比较。匹配哪些特征取决于问题,不能把所有差异都机械消除,也不能看到哪个背景显著就选哪个背景。
AME 官方文档包含对照序列、排序信息和不同统计设置的说明。本例只计算预先固定的两个列联表,没有搜索最优切点、扫描大量模式或做模式层面的多重校正。因此,本文数值不能当作某个 AME 命令的预期输出,它只是帮助读者先理解背景为什么会改变问题本身。
四、先筛掉不显著结果,再做多重校正,会发生什么
第三个练习生成六个预先定义的检验值,依次为零点零零零二、零点零零一、零点零二、零点零四、零点三和零点八。脚本在完整的六个检验组成的家族上执行独立编写的 BH 校正,再演示一种错误操作,先保留小于零点零五的四项,再对这四项校正。
完整六项校正
0.0012, 0.003, 0.04, 0.06, 0.36, 0.8

先筛选四项再校正
0.0008, 0.002, 0.0266667, 0.04
完整家族中有三项低于零点零五,错误地缩小家族后变成四项。原本校正值零点零六的一项,在筛选后的表中变成零点零四。它没有获得新的数据证据,只是校正时忘记了其他检验。这种操作特别容易发生在只下载了一张显著命中表,然后又对其中的显著性值重新运行校正时。
这个练习不是 FIMO 的校正结果复算,也没有包含实际扫描的完整检验空间。它只说明一个一般性的计数问题,表里留下多少行,不等于最初做了多少检验。真实扫描还涉及序列长度、基序数量、链方向、阈值与输出截断,不能用一个已经筛过的位点表推断完整比较范围。
FIMO 文档区分匹配显著性与校正后的值,并说明默认阈值针对前者。文档还指出,纯文本输出模式会关闭校正值计算,保存匹配数量达到上限时也可能影响结果完整性。拿到一个没有校正列的文本文件,不能仅凭文件名就宣称所有结果已经控制了错误发现率。
审阅时最好同时查看命令、日志和原始输出说明。尤其要确认阈值作用在哪一列、是否只输出部分命中、运行过程中有没有容量上限相关提示。没有保留这些信息时,宁可明确写成“按当前表中字段筛选”,也不要补出一段实际上没有执行的统计流程。
五、坐标转换的一碱基偏差,会怎样悄悄进入结果
第四个练习专门处理坐标。我们假设从基因组提取一个零起点、右端不包含的区间,范围为一千到一千二百。保存为普通序列标识的 FASTA 后,位点表使用局部的一起点、两端包含坐标。这里的坐标定义是练习前提,不是对所有软件选项和所有 FASTA 标题的统一假设。
若正向提取的序列中,一个位点从十一到十八,转回基因组 BED 就是一千零一十到一千零一十八,宽度仍为八。换成局部二十一到二十八的负链位点,区间为一千零二十到一千零二十八。位点本身标为负链,不代表要再次把整个提取窗口翻转,因为序列仍然是正向提取的。
正向提取
genome_start = window_start + local_start - 1
genome_end   = window_start + local_end

反向互补提取
genome_start = window_end - local_end
genome_end   = window_end - local_start + 1
如果提取时已经把整个窗口反向互补,同样的局部十一到十八则对应一千一百八十二到一千一百九十,而且局部正链映射为基因组负链。要区分的是两个层次,序列如何提取,以及匹配落在哪条局部链上。只看位点表的正负号而不看提取过程,很容易把一个本来正确的坐标再翻转一次。
还有一种反方向的错误,程序已经根据 FASTA 标题解析出基因组坐标,下游脚本却再次加上窗口起点。为避免这种情况,建议用一个已知短序列做往返核验,先检查宽度是否保持,再从基因组取回该区间,按链方向比较序列。这个小检查比等到几万个峰的富集图异常后再追查坐标更有效。
本次脚本对三种映射都检查了八碱基宽度。这个测试只验证明确给定的坐标假设,不意味着任意来源的位点文件都能直接套公式。进入真实任务前,必须先确认序列标识、输出坐标约定和提取方向,必要时查阅FIMO 输出格式说明。
六、发现一个漂亮模式,为什么还不能点名某个蛋白
发现程序输出的简写共识序列,主要用于帮助人识别模式,不能替代完整的位置权重信息。一个模式在不同位置允许不同碱基,直接用共识字符串做完全匹配,会漏掉概率模型允许的变体,也会失去对应的评分含义。STREME 官方说明明确区分模式名称与后续扫描所需的模式文件。
此外,发现和验证如果使用同一批序列,结果天然带有选择过程的影响。先在一组数据里反复寻找最突出的模式,再拿同一组数据证明这个模式突出,并不等于独立验证。样本少到无法形成有效留出集合时,输出中的评分也不能自动获得大样本检验的解释。一个能完成运行的小示例,适合验证流程,不一定适合支持发现结论。
把发现模式提交给 Tomtom,可以比较它与已有模式的相似程度,但相似性不是蛋白结合的直接观测。Tomtom 文档描述的输入输出对象都是模式及其匹配。若多个家族成员共享相近的识别偏好,最高排名的名称只是候选解释之一,还应查看其他近似匹配、有效重叠长度和所用数据库版本。
在真实报告中,更稳妥的表达是先描述模式层面的观察,再说明支持哪些候选家族,最后结合表达、可及性、独立结合实验或扰动结果逐步缩小解释。不是每个项目都能获得全部证据,但应让读者知道当前结论停在哪一步。把不确定性写在恰当位置,比用一个熟悉蛋白名称替代整条证据链更有价值。
七、怎样把这些练习变成自己的审阅清单
MEME Suite 的优势是把模式发现、位点扫描、富集和模式比较放在同一套工具生态里,便于围绕不同问题组合分析。限制在于,这些工具输出的统计对象并不相同,默认参数也不能替研究者定义背景、实验单位和生物学结论。使用者需要的是能够追溯每一列如何产生,而不是记住所有程序名称。
下载本组原创练习与结果记录,进入本篇目录后运行下面命令。该脚本仅使用 Python 标准库,不调用 MEME Suite,不需要它的数据库。本文练习在 Python 3.14.3 下执行,生成六条人工位点、统计汇总、两种背景的精确检验、完整与错误筛选的校正对照,以及三种坐标映射结果。
python3 run.py output
建议先不改统计函数,只改输入。例如给甲模式在同一区域增加一个位置,观察位点数变了但阳性区域数不变。再把背景阳性数逐渐提高,观察目标集合完全不变时比较结论如何变化。最后在校正家族里增加预先定义的检验,检查结果为何不能只由显著行数决定。这些可核对的小变化,能够帮助读者在面对复杂结果时问出更具体的问题。
正式分析记录至少应保存输入序列与提取方法、模式库来源与版本、完整命令和阈值、背景定义、输出是否截断、统计单位及坐标转换规则。保存这些信息不是为了让报告变长,而是为了在结果被追问时,能够定位到底是模式本身、比较背景还是整理步骤导致差异。本文没有给出套件安装成功或扫描速度的结论,也不把自编练习包装为软件实跑。
当基序扫描与多组学验证扩展到大量样本,需要统一管理环境、轨道和结果时,可通过云生信生物分析服务器服务开展可追溯的批量分析。


