
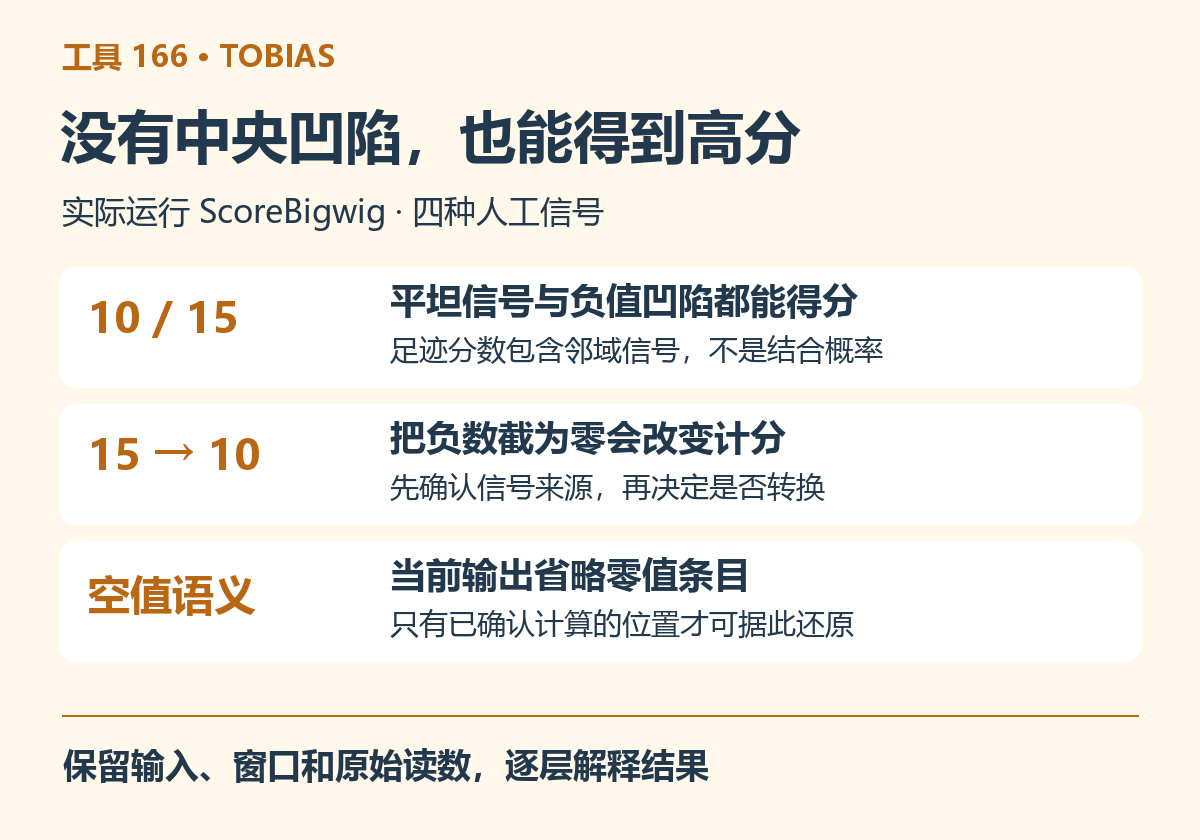
在 ATAC-seq 足迹分析中,最容易误解的词可能就是“足迹分数”。不少读者直觉上把它当作结合概率,或者认为高分处必然有一个漂亮的中央凹陷。本次运行 TOBIAS 的计分模块后,一段处处为十、没有任何中央下降的人工信号,仍然在中心得到十分。这个结果不是程序算错了,而是提醒我们,先理解分数由什么组成,再讨论它支持什么结论。
本文实际运行 TOBIAS 0.17.5 的 ScoreBigwig,输入是自行编写的连续信号轨道。我们没有运行偏好校正、真实序列扫描或者差异结合分析,也没有使用真实测序样本。下面的数值用来解释计分与文件读写,不代表某个转录因子的实际结合强度。项目整体功能可查阅官方仓库。
一、先把三个问题分开
一条原始切割轨道、一条校正后轨道和一条足迹计分轨道,虽然都可能保存成同样的文件格式,但并不是同一个量。前者记录切割信号,校正步骤尝试处理序列相关的切割偏好,计分步骤再根据邻域形态产生新的数值。文件扩展名一致,并不代表单位与解释也一致。
TOBIAS 中,ATACorrect 负责相应的校正工作,ScoreBigwig 在给定区域内计算连续分数,BINDetect 则进一步结合基序等信息开展位点与条件比较。这几个环节要分开记录输入来源,不能把“成功生成一条计分轨道”写成“已经证实差异结合”。校正环节的输入与输出可对照ATACorrect 文档,本文只实际测试中间的计分环节。
本次直接编写轨道,是为了让每个位置的值都已知。它不是通过校正软件得到的真实校正结果,更不能借用校正工具的名字为它增加实验可信度。这样的构造适合回答“把负数截成零会发生什么”,却不能回答真实样本中的切割偏好有没有被充分消除。把问题边界写清楚,读者才能知道哪些经验可以迁移,哪些结论仍需要真正的实验数据。
二、四种信号,只改变中心和两侧
我们构造一条长度两千二百碱基的虚构染色体,在四个互不重叠的区域写入逐碱基数值。每段三百碱基,中心特殊区间宽二十碱基,其他位置维持各自的背景。为了减少边缘截断对演示的干扰,请求计分的区域相对输入两端各向内收缩五十碱基,并关闭额外区域延伸。
第一段全部为十,称为平坦段。第二段两侧为十、中央为负五,称为负值凹陷段。第三段两侧为零、中央为负五,称为安静背景凹陷段。第四段两侧为十、中央为零,称为零值凹陷段。输入文件中这些零值是真正写入的条目,不是没有覆盖该位置,所以它们的生成含义非常明确。
| 人工区域 | 两侧信号 | 中央信号 | 中心足迹分数 |
|---|---|---|---|
| 平坦段 | 10 | 10 | 10 |
| 负值凹陷段 | 10 | -5 | 15 |
| 安静背景凹陷段 | 0 | -5 | 5 |
| 零值凹陷段 | 10 | 0 | 10 |
这里最值得停下来想的是第一行和第四行。视觉上,一段没有凹陷,另一段中央下降到了零,两者的中心分数却相同。这说明“看起来有凹陷”和“得到更高的当前计分”不是同义词。分数的设计同时考虑邻域可及性与负向信号,不能用一条直觉上的谷深公式替代软件真正执行的规则。
第三行也值得注意。它有负向中心,但两侧没有正向信号,结果只有五分,低于平坦高信号段的十分。若把分数直接叫作结合概率,就无法解释为什么一个没有中央谷的区域反而更高。分数在这里综合了多种特征,不是只回答中央是否下降。
三、固定窗口以后,才能说清参数改了什么
本例把足迹窗口和两侧窗口的最小、最大长度都设为二十,使比较更容易理解。实际运行的基础命令如下。完整脚本记录了软件帮助信息与镜像摘要,并把每个容器限制为两核、四 GiB 内存。
TOBIAS ScoreBigwig \
  --signal signal.bw --regions regions.bed \
  --output footprint.bw --score footprint \
  --extend 0 \
  --fp-min 20 --fp-max 20 \
  --flank-min 20 --flank-max 20 \
  --cores 2 --split 1
在本次使用的实现中,足迹计分结合两侧正向信号的均值和中心负向部分,并在候选窗口对位置的覆盖关系中取相应的最大分数。对于平坦段,没有负向中心贡献,邻域信号仍然可以产生高分。因此,无明显凹陷也可能出现较高得分,正是ScoreBigwig 官方说明强调的解释边界。
理解这一点以后,检查结果就有了具体方法。先画输入轨道,确认负向值究竟从哪里来,再看输出分数是否随窗口长度变化。如果只保存最终分数,没有保留上游轨道和参数,一旦结果与预期不一致,就很难区分是信号本身变了、窗口改变了,还是换了一种计分方式。
本次同一输入还运行了均值模式和不变换模式。在四个中心,二者都分别读出十、负五、负五、零,因为中心附近二十碱基正好是常值。足迹模式输出的十分、十五分、五分和十分,与这些值不是相同量纲下的简单替代。比较不同模式时,应重新标注图例和纵轴,而不是沿用同一名称后直接比较高低。
四、负数不是坏数据,先问它的来源
常见的预处理习惯是把负值裁剪成零,理由是测序片段数不可能为负。但校正后连续信号与原始片段计数不同,负向值可能正是后续足迹计分使用的信息。先入为主地清除负数,可能破坏正在研究的特征。
我们在相同输入上增加下限为零的参数重新运行。负值凹陷段的中心分数从十五下降到十,安静背景凹陷段从五下降到零,其他两个中心保持十分。每一行输入的坐标、区域列表和窗口长度都没有改变,变化来自进入计算的数值被截断。这是可以逐项复现的参数效应,而不是两次数据之间的生物学差异。
TOBIAS ScoreBigwig \
  --signal signal.bw --regions regions.bed \
  --output clipped.bw --score footprint \
  --extend 0 --fp-min 20 --fp-max 20 \
  --flank-min 20 --flank-max 20 \
  --cores 2 --split 1 --min-limit 0
再把输入取绝对值,结果也不是简单回到原始轨道的解释。安静背景中的负五会变成正五的小岛,窗口移动时可能把这个小岛放进其他窗口的侧翼。本次该区域中心得到一点二五分。这个细节提醒我们,某个位置最终的分数不一定只由以它为正中点的一套窗口决定,局部转换会通过邻域规则影响周围输出。
因此,“截断负值”和“取绝对值”不能当作无害的显示调整。如果只是为了画图,应该明确保留原始数值并标注显示方式。如果转换后的轨道继续进入计算,就已经改变分析输入。文章、脚本与图例应保持同一说法,不能代码里裁剪了数值,方法部分却仍然声称使用原始校正信号。
五、读出来是缺失,为什么本例可以判为零
这一轮还有一个比计分公式更容易造成下游错误的细节。某些已经计算且结果为零的位置,用读取库直接取值时返回了非数值。只看这个返回结果,容易认为软件漏算了该位置,或者认为这与原始输入里的未知区域完全一样。
我们检查了本次安装版本实际使用的写出函数,确认它只把非零位置写入输出轨道。脚本同时记录了函数内容的哈希与检查结果,因此这个判断来自当前运行的实现,而不只是推测。原始读取结果在记录中保留为缺失形式,另加一份只针对已知请求区域中心的零值恢复结果,二者没有混写。
| 读取情形 | 本例中已知的事实 | 可以采取的处理 |
|---|---|---|
| 已请求计分的中心返回空值 | 写出函数省略零值条目 | 可按本例语义解释为零 |
| 请求区域以外返回空值 | 未验证该处已经计算 | 不能据此认定为零 |
| 来源不明的其他轨道返回空值 | 不知道生成与写出规则 | 先查来源再决定 |
关键不是给所有空值制定一个通用规则,而是先确认文件的生成约定。某些输入轨道的空白意味着没有观测,某些输出轨道的空白意味着计算得到零而省略存储。若把两类文件都交给同一套默认补零流程,很可能在没有任何报错的情况下改变平均值和覆盖率。
在本例里,我们只对四个明确位于请求区域内、已知完成计算的中心恢复零值,并保留原始读取记录。这个限定很有用,因为后来者可以检查判断依据。如果把整条染色体所有空白都填满,再把它称为完整预测轨道,就超出了本次检查能支持的范围。
六、峰变宽或变平,不等于结合边界改变
在负值凹陷中心附近,输出分数并不是只有一个位置变高,而是从十二点五、十三、十三点五逐渐上升到十五,并在附近维持一段范围。这与滑动窗口覆盖位置的方式有关,不能把高分台阶的每一个边缘直接解释成蛋白占据的物理边界。
我们进一步使用五十碱基平滑。负值凹陷中心从十五变成约十二点六五,安静背景凹陷中心从五变为约三点八,零值凹陷中心约为九点零五。平坦段则仍为十分。平滑改变了局部显示和数值分布,却没有增加一次实验,也没有提供新的独立证据。
所以,比较两组轨道时,应先核对计分窗口、平滑长度、区域集合和上游处理是否一致。若一组平滑而另一组未平滑,中心高度和宽度本来就不能直接对应。即便都进行平滑,也应保留未平滑版本,用来检查图中出现的宽峰是原始信号结构,还是处理参数扩展出来的视觉效果。
这里还要避免一个统计误区,同一区域的相邻碱基经过窗口与平滑处理后高度相关,不能把它们当成几百次独立实验来增加样本量。多个位置可以帮助描述形态,却不能替代独立生物学重复。讨论条件差异时,重复设计与样本质量仍然决定结论能走多远。
七、从足迹分数走向结合解释,还缺哪些证据
一条高分轨道首先支持的是“在当前输入与参数下,这里得到了较高计分”。要进一步谈某个转录因子,需要明确使用了什么基序、该位点是否匹配、家族成员之间是否难以区分,以及这些信息怎样与样本条件对应。若要谈差异,还需要说明比较对象、归一化方式和统计处理。
BINDetect 文档分别描述基序匹配、条件分数、结合判定与变化相关输出。读表时应按照字段含义解释,不能把基序匹配分数、足迹分数和最终分类混为一列。本文没有运行该模块,因此也没有给出任何真实的结合或差异结合判定。
TOBIAS 的优点是把偏好校正、连续计分与后续位点解释组织为可追踪的工具链,便于逐阶段检查。它的限制在于,每个阶段依赖前面的数据和假设,高分并不自动等于确定结合,基序相似也不自动确定具体家族成员。一个有价值的分析报告应能让读者沿着结论回到基序、轨道和原始处理记录,而不只是展示最后一张热图。
八、这次安装与实跑留下的经验
首先,要以实际安装版本的帮助信息核对命令。文档中仍可见旧命令名称的示例,而本次统一执行当前可用的计分命令,并保存帮助输出。复制教程时只替换文件路径,容易忽略版本变化。其次,轨道读取不能只检查文件存在,还要抽取已知位置核对数值和空值语义。最后,修改参数时一次只改一个因素,否则发现分数变化后无法追溯来源。
下载本组复现脚本与结果记录,在对应目录执行下面命令,可重新生成四类人工轨道并运行六种计分设置。脚本记录 Python 3.11.15、pyBigWig 0.3.25、工具版本、镜像摘要、各次命令与输出中心值。需要支持 Docker 的 Linux 环境,建议每次使用新的输出目录。
python3 run.py output
这个练习可以继续扩展,例如保持凹陷深度不变只改变侧翼高度,或者保持信号不变只扩大窗口。每次先写下预期,再运行检查,通常比直接浏览一条复杂的全基因组轨道更容易理解参数。练习完成后,回到真实数据仍需重新检查测序质量、偏好校正与重复一致性,不能把人工信号上可解释的结果当成真实样本已经验证成功。
当样本和轨道逐渐增多,需要持续保存环境、参数和中间结果时,可通过云生信生物分析服务器服务承接可复现的批量分析流程。


