
从 Strelka2 的体细胞 VCF 提取变异等位频率,在单碱基替换上偶尔能用“替代条数除以总深度”算出相同答案。换成插入缺失就未必如此。我们安装历史版本 Strelka2,完整运行随包的肿瘤与正常配对示例。一个插入位点在肿瘤列里有八条插入支持,总深度二十,作者推荐的频率算法却是八除以十九,约百分之四十二点一。读懂这个差异需要弄清三个细节,软件给哪些证据单设字段,逗号分开的两项代表什么,以及当前看的是哪个样本。
先找到对的文件和样本列
体细胞流程会分别输出单碱基替换和插入缺失。前者按四种碱基分别记录已用于计数的观测,后者则记录明确支持参考、明确支持目标插入缺失及其他类型的观测。解读时先记录文件名,读 VCF 头里的样本顺序与字段说明,再按该行的格式列解析每个样本。相同列号在另一个文件里不保证仍是同一种证据。若先把两类结果转成一张只有位置、替代、深度的表,日后很难恢复究竟采用了哪种频率算法。Strelka2 官方手册的输出与等位频率说明
这些计数字段往往写成一对逗号分隔的整数。两个值对应不同的读段筛选层级,第二层采用更宽松的条件,同一条读段可能已经在第一层计过。将它们相加会重复计算共享的读段。手册给出的频率估算统一取第一层的明确参考与替代计数。计算得出的仍是这个样本在这套规则下的观察比例,需要另外结合深度、质量、正常对照和检测设计判断其生物学解释。不能把一个比例直接当作肿瘤细胞比例,组织混合和局部拷贝数都可能改变它。
实跑经验|把一个替换和一个插入逐项手算
我们使用 Strelka2 2.9.10 的官方可执行发行包,在隔离的 Python 2.7 环境中执行随包的配对体细胞示例。流程实际调用变异检测程序,同时将生成的结果与包内预期文件比较,按示例规定排除运行日期等可变头信息后,比较通过。输出包含十七条单碱基记录,十六条通过、一条标为低经验变异评分。插入缺失共有两条,均通过。这里使用的是演示参考上的坐标,不能按它们去定位真实患者的基因。Strelka2 官方发行包
| 示范位点 | 肿瘤第一层参考、替代 | 正常第一层参考、替代 | 肿瘤中的计算 |
|---|---|---|---|
| demo20 的 991,C→G | 5、5 | 12、0 | 5/(5+5) = 50% |
| demo20 的 1148,C→CTAT | 11、8 | 26、0 | 8/(11+8) = 42.11% |
| demo20 的 3664,TC→T | 18、20 | 24、0 | 20/(18+20) = 52.63% |
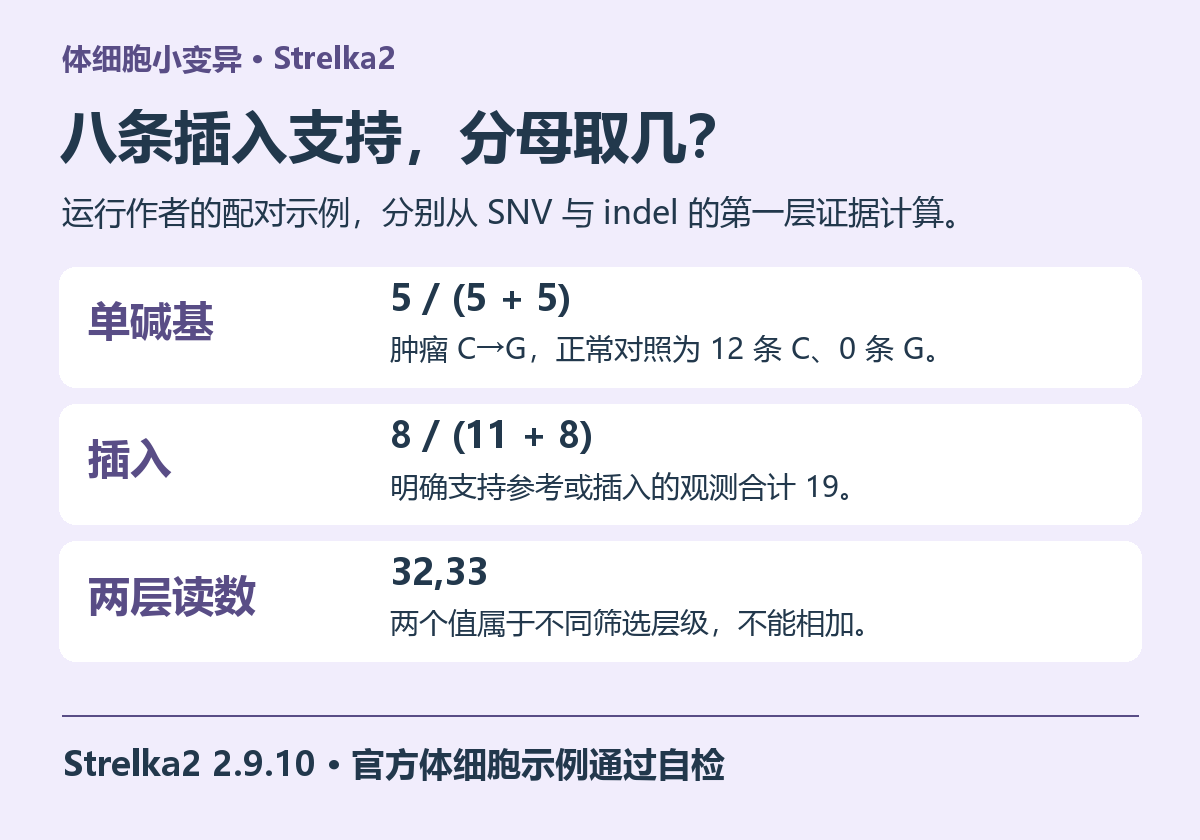
第九百九十一位是 C 到 G 的替换。肿瘤列的 C 计数五和五,G 计数也是五和五。各取逗号前第一项,得到五条参考、五条替代。正常样本对应十二条参考、零条替代。另一处第二千四百五十五位更能看出层级差异,肿瘤 C 的计数是三十二和三十三。若把这两个数加成六十五,已经超过该行肿瘤总深度三十三。这个算术反例可以用来快速发现旧脚本误把两层当作两组独立读段。
第一千一百四十八位的插入,肿瘤列的参考支持字段是十一和十一,插入支持字段是八和八,另有其他观测字段两和两。按作者的定义,频率分母只纳入明确支持参考或目标插入的第一层观测,所以分母为十九。此行报告的总深度为二十。把参考、替代、其他这三个字段机械相加还会得到二十一,足见这里不能把三列假设成总深度的严格互斥分解。遇到这类记录,应保留每列原值和计算方式,以便后续核查。作者对体细胞等位频率的逐字段算法
def tier1(value):
    return int(value.split(",")[0])

def observed_fraction(sample, ref, alt, is_snv):
    ref_key, alt_key = (ref + "U", alt + "U") if is_snv else ("TAR", "TIR")
    support_ref = tier1(sample[ref_key])
    support_alt = tier1(sample[alt_key])
    depth = support_ref + support_alt
    return support_alt / depth if depth else None
在两千五百一十二位还有一个提取脚本容易忽略的情况。肿瘤样本的 G 在两层各为二十六与二十七,正常样本的 A 各为二十五与二十六,二者差异不在同一碱基列。把正常的碱基数错拿来作肿瘤的分母,结果仍可能看起来像一个合理的小数。实现时让计算函数每次只接收一个已经按样本名取出的字段集合,再把正常和肿瘤结果分列,能减少跨样本串列的机会。
通过、低分与正常对照各告诉你什么
那条未通过的单碱基记录位于第一千八百七十三位。参考为 C,替代为 T。正常样本第一层有十三条 C、十条 T。肿瘤样本有二十一条 C、零条 T,经验评分为零。若只见文件名带体细胞、记录中出现了 T,就把它计为“肿瘤新增替代”,会把实际方向颠倒。读这种输出时应并排展示两份样本的证据及过滤状态,再核对模型中正常与肿瘤状态的转换。即使一个变化与杂合性丢失等机制相容,单凭一行低分记录也无法确立机制。
对通过的插入缺失,同样可以回到原始比对查看目标等位两侧是否有可靠锚定、邻近是否伴随其他插入缺失、正常样本覆盖是否足以检出低频支持。报告常见的次序是列出原始支持条数、写明选用的层级和公式,再给数值与过滤标记。若参考和替代的有效支持都是零,应保留缺失或不可计算,不宜写成零频率,因为观察到零条替代与根本没有可纳入的观测含义不同。
这版工具常见于历史队列,作者已归档项目仓库。复算旧数据时,可从同一发行包的示例开始,确认流程和解析脚本都能逐项复现预期结果,再核对项目所用参考、工具版本和配对样本身份。把本例中的两个层级确实不同的位点留作测试,还能发现以后改动表格提取规则时是否又把两列加在了一起。Strelka 上游项目状态
需要重算历史肿瘤配对队列时,可在云生信的生物信息分析服务器中固定分析环境,并同时保存肿瘤和正常样本的逐项证据。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)