
DeepVariant 的日志里会同时出现候选数、生成的样例数、模型预测数和最终 VCF 行数。只看卷积网络处理了多少个图像,很容易误判某批数据漏掉了变异。我们在公开样本 NA12878 的二十号染色体上,对同一万余个碱基实际跑了两次 DeepVariant 1.10.0。两次都从比对文件开始,用同一个全基因组短读长模型完整执行到 VCF 和 gVCF。关闭小模型后,卷积网络收到的样例从二十四增到八十四。两份通过过滤的结果却有完全相同的七十二个变异键,连基因型也一致,其中五十四个的基因型质量发生了变化。
先认清两条推断路径
这个版本的全基因组流程会先检查候选。对适用的双等位候选,小模型读取等位支持、质量和附近位置等特征,如果得到足够有把握的分类,可以直接把预测交给后处理。需要更完整判读的候选会生成编码读段堆叠信息的多通道图像,再交给卷积网络。两条路径最终汇到后处理阶段。因此,日志里“送进卷积网络”的数目只描述其中一路。同一个候选位置含多个可考虑的等位组合时,位点数与图像样例数也可能不同,不能预设一条候选必定对应一张图。DeepVariant 作者对小模型及其输入的说明
这里的模型类型要与测序方法相符。我们采用官方快速入门的短读长比对片段和它配套的参考文件,保留原始染色体名称与索引。第一次使用默认配置,第二次只增加关闭小模型的参数,两次都只用一个分片,结果写入不同目录。这一对照处理的是同一参考区间内的模型分工和输出差异。它没有训练模型,也没有在全基因组估算耗时或比较硬件吞吐。官方快速入门的数据和区间
实跑经验|从两份日志对到最终过滤状态
我们在 CPU 上运行了官方 1.10.0 镜像内的实际程序和随附权重。请求坐标为二十号染色体第一千万至第一千零一万位,按一基闭区间共一万零一个碱基。两次都从相同输入发现七十八个候选。默认流程报告小模型处理并接受六十个样例,另写出二十四个供卷积网络预测。关闭小模型后,卷积网络实际预测八十四个,两次后处理日志都记录处理八十四项。这个阶段的样例计数与最终位点行数有不同的统计单位。
| 同一输入的实际读数 | 默认启用小模型 | 关闭小模型 |
|---|---|---|
| 候选/送入 CNN 的样例 | 78/24 | 78/84 |
| VCF 的记录数 | 78 | 78 |
| PASS/RefCall/NoCall | 72/6/0 | 72/5/1 |
| 配套 gVCF 的记录数 | 228 | 228 |
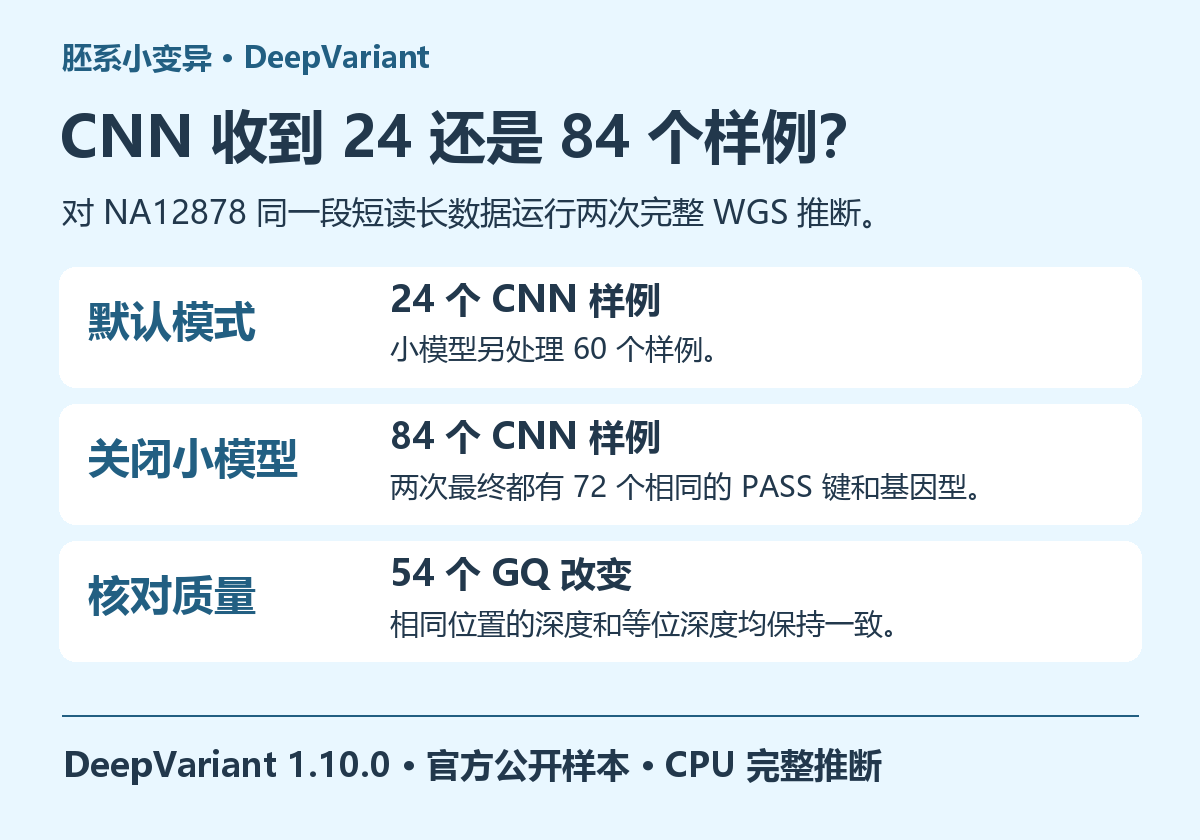
默认输出带有模型来源字段,七十二条通过记录中,五十五条来自小模型,十七条来自常规卷积网络。把这个数字和日志对照,小模型一共接受了六十个样例,其中并非每个都成了通过过滤的替代变异。关闭小模型后的 VCF 没有逐样本的该来源字段,此时应结合执行日志记录模式,直接筛选小模型标签会把这个文件的记录都漏掉。想复查计数,先按过滤状态分组,再在同一组内统计来源,更容易与最终用于下游的清单核对。
同一位置的证据还可以逐项复查。取随例高置信区间内的 chr20:10009227 作对照。参考 A、替代 G,两次都报告杂合,深度六十六,等位深度三十四与三十二。默认小模型给基因型质量三十四,关闭后卷积网络给十六。若报告要求基因型质量至少二十,这个位置可以在两份原始文件里都标为通过,最后却因额外过滤得到两个不同的结论。七十二个共同通过的键中,深度与等位深度逐项都一致,正好把输入证据变化与评分变化区分开。
# 以下参数加到官方快速入门的同一份 WGS 命令中,分别写入两个目录
# 第二次运行增加 --disable_small_model=true
bcftools query -f '%CHROM\t%POS\t%REF\t%ALT\t%FILTER[\t%GT:%GQ:%DP:%AD]\n' output.vcf.gz
bcftools view -f PASS -H output.vcf.gz | wc -l
为什么七十二条相同也不能用来宣布准确率相同
还有一处位置 chr20:10009877,两次输入证据均为三十三条参考和五条替代,样本深度三十八。默认输出参考型,过滤状态为参考判定,关闭小模型后输出缺失基因型、状态为无法调用。它不在那七十二条通过清单里,若只对比通过记录,就看不到这个差异。该位置也在本示例提供的高置信评估区间之外。不能因为示例真值表没有对应记录,就断言其中一个模型在这里判错。
我们将通过记录的完整参考跨度与随例的高置信 BED 对齐,只有四十八个通过键落在评估区域内。另外二十四个落在范围外,应该另列为未在该区域评估。区域内四十八个键与配套真值用染色体、位置、参考、替代逐字匹配也有四十八个交集。这里仅做小区域的表级核查,真实基准应使用能处理等价变异表示和基因型差异的比较方法,并分别报告替换、插入缺失及难比对区域。若把区间外二十四条一律当成假阳性,再计算准确率,错误首先来自评估分母的选择。
接手新的测序项目,可以先从一个有独立对照的小区间起步,保存模型版本、读段技术、输入参考、两阶段日志和下游质量阈值。若两份结果看似相同,先比较完整变异键和基因型,再比较基因型质量及缺失状态。若差异集中在高同源区或低覆盖边缘,也应把位置带回读段图和评估范围核查。这样能区分模型确实换了一种判断、项目阈值改变了纳入名单,或该区域根本没有可作判断的真值。
把这些判断规则固定后,若需将同一版本的模型推广到整批全基因组,可使用云生信的生物信息分析服务器管理输入、模型与分样本日志。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)